- @weixin_43322583


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
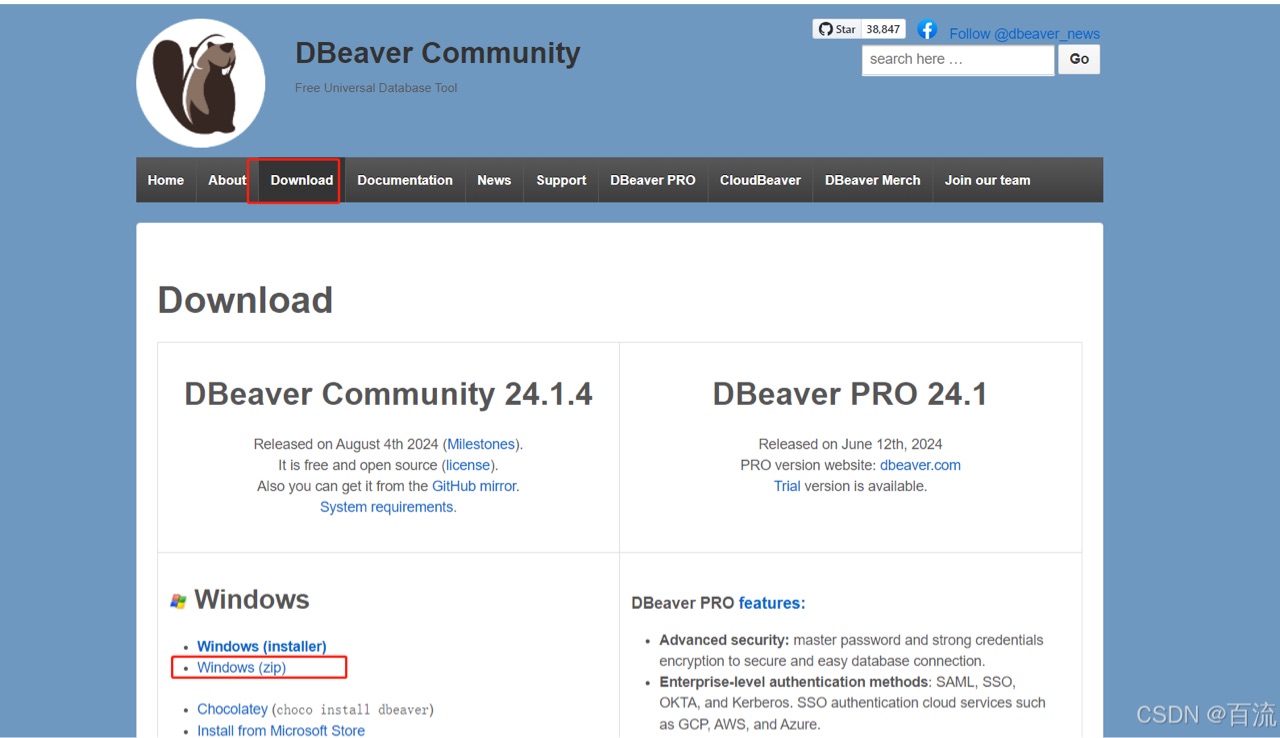
DBeaver是一款免费、开源的数据库管理工具,支持多种关系型数据库,包括MySQL、PostgreSQL、Oracle、SQLite、Microsoft SQL Server,还可以链接hive。它是一款跨平台软件,支持Windows、macOS、Linux等操作系统。DBeaver提供了强大的数据库管理功能,包括数据库连接、SQL编辑器、数据导入导出、数据备份、数据恢复等。同时,它还支持多个数
windows下centos虚拟机创建与初始化,宿主机与虚拟机共享目录设置,虚拟机配置固定ip,虚拟机与宿主机互通,虚拟机访问公网,详细过程及贴图图

linux下安装python的详细过程,以及pip源配置的方式,附图文。

pyspark 中dataframe column的基本使用方法,以及详细样例演示
使用官方源进行安装,包含linux下mysql的安装,卸载,以及解决安装过程中的问题。mysql80-community-release-el7-6.noarch.rpm的目的其实就是安装了mysql官方的yum源,这时候使用yum 进行 mysql的安装,系统会优先从mysql官方源头进行mysql安装。

Pyspark中GroupedData类型数据的内置函数,以及操作使用样例详细展示
Catalog是Spark中用于管理元数据信息的接口,这些元数据可能包括库、内部或外部表、函数、表列及临时视图等。总的来说,PySpark Catalogs是PySpark框架中用于管理和查询元数据的重要组件,它使得Python用户能够更有效地利用PySpark进行大数据处理和分析。
YAML 参考了其他多种语言,包括:C语言、Python、Perl,并从 XML、电子邮件的数据格式(RFC 2822)中获得灵感。命名卷可以用于持久化容器内的数据,即使容器被删除或重新创建,数据也不会丢失。1.命名卷存储在Docker管理的宿主机文件系统中,在Docker主机上创建的独立于容器生命周期的持久化存储区域。YAML 文件使用缩进和换行等符号来表示层次结构和序列关系,从而达到编写简单易
在已经安装完hadoop,mysql的基础上可以进行hive的安装之前部署的hadoop版本为3.2.4,mysql版本为8.0.39,详细部署流程。

es 基本了解及使用