


- @weixin_39750084


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
推送好之后,在cube studio平台上,新建一个pipeline,使用自定义镜像模板,填写镜像为ccr.ccs.tencentyun.com/cube-studio/hadoop-hive:v3.3.2-3.1.3,debug,检查目录对不对,检查环境变量是否正确,在命令行输入hive命令,看是否能正常执行。环境变量写在/etc/profile更好,因为~/.bashrc是临时的,重启一下po

比如我现在只有1个datanode,我想改成3个datanode,复制粘贴配置信息到values.yaml(没有就自己创建),更改datanode的replicas为3,先卸载,再重新执行install命令。如果需要修改配置,在官方仓库中,点击default values按钮,可以获取默认的配置,将配置信息粘贴到values.yaml,通过helm uninstall卸载后,再通过命令。可以根据新

datax使用clickhouse导出数据时配置json的官方文档:https://github.com/alibaba/DataX/blob/master/clickhousereader/doc/clickhousereader.md。这个问题我用的是偷懒的方法,直接把json配置中的speed下面的byte参数删掉了,只保留了channel,问题解决,也有更复杂的办法,修改datax的配置的

(作者:陈玓玏)主要是看《推荐系统实践》这本书做的笔记,写得不好请见谅,一些我自己的拙见有需要讨论的可以留言,谢谢!1. 分类及度量1、评分预测:预测用户对物品的评分,用RMSE和MAE做度量2、Top N推荐:给出个性化推荐列表,预测准确率通过准确率(推荐列表中被用户点击的商品/推荐列表中所有商品)/召回率度量(推荐列表中被用户点击的商品/用户点击的所有商品)。一般会给出不同的N,计...
使用clickhouse-driver包,先通过pip install clickhouse-driver安装包,再通过以下代码执行sql。
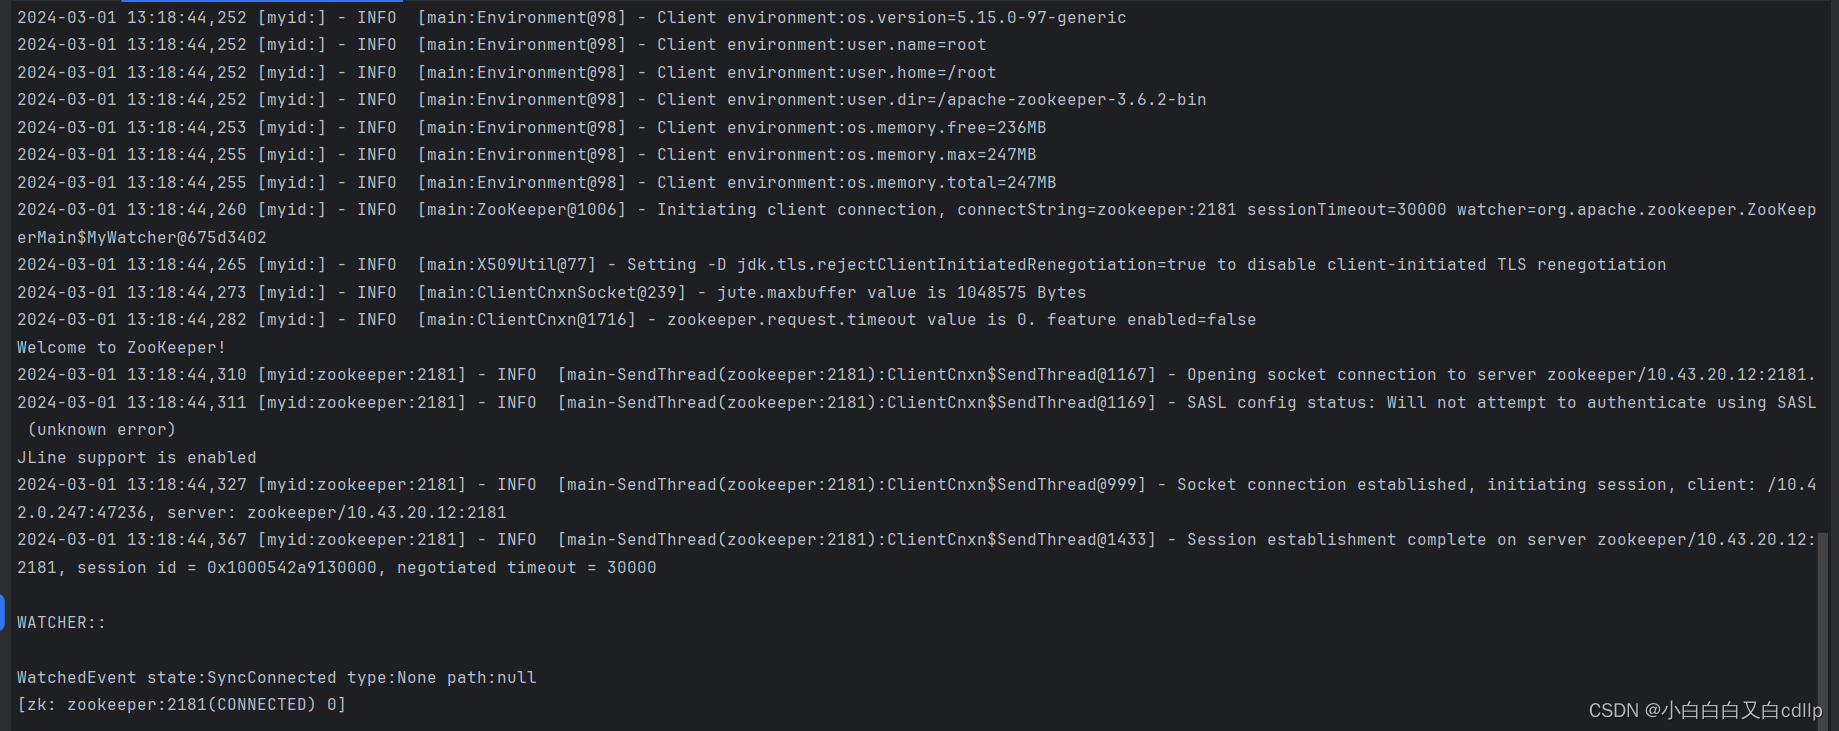
参考文章:https://blog.csdn.net/fushan2012/article/details/129556052。出现以上图片,表示可以正常执行zookeeper。
(作者:陈玓玏)有时候我们需要查看Hive表对应文件的文件大小,
介绍在数据挖掘中,经常会存在不平衡数据的分类问题,比如在异常监控预测中,由于异常就大多数情况下都不会出现,因此想要达到良好的识别效果普通的分类算法还远远不够,这里介绍几种处理不平衡数据的常用方法及对比。符号表示记多数类的样本集合为L,少数类的样本集合为S。用r=|S|/|L|表示少数类与多数类的比例基准我们先用一个逻辑斯谛回归作为该实验的基准:Weighted loss fu...
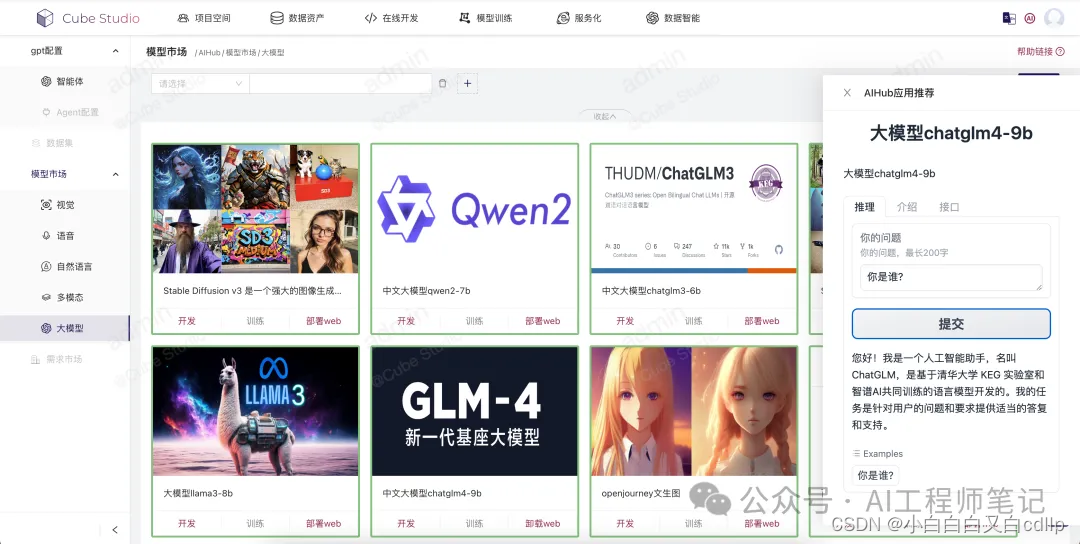
Cube-Studio是由腾讯音乐开源的一款云原生一站式AI中台,覆盖机器学习/深度学习/LLM大模型,开发、训练、推理、应用,全链路。该项目目前已是国内最火的开源算法全链路中台,上千家企业私有化部署和项目交付,非常适合数据算法架构团队搭建公司级AI中台,以及toB企业算法中台类项目交付。
(作者:陈玓玏)一、 实现功能从CSV文件中读取数据,然后构建深度神经网络,各层神经元个数分别为3/5/2/4/1,因为是二分类问题,所以输出层只需要一个神经元。前四层,包括输入层的激活函数都是Relu,还定义了Elu函数,是Relu函数的改进版,输出层使用的是sigmoid激活函数。损失函数定义为交叉熵损失函数,优化方法采用的梯度下降法。最后对结果进行评估,虽然神经网络中通常是使用准确度来评..