


- @u013571432


简介
长期从事机器学习与深度学习的研究教学与工作。
擅长的技术栈
可提供的服务
《机器学习与深度学习》系列课程学习及其应用项目开发。
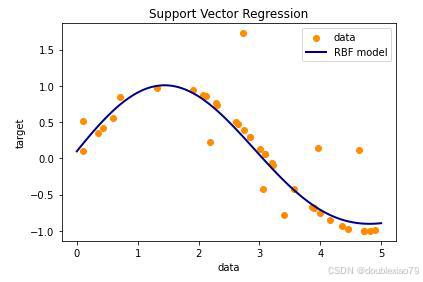
支持向量回归(Support Vector Regression, SVR)是一种基于支持向量机(Support Vector Machine, SVM)的回归算法,其核心思想是通过寻找支持向量来构建一个分离超平面,从而实现对不确定的函数关系的建模。
不过,scikit-learn中的决策树算法(如DecisionTreeClassifier)使用了类似的原理,如信息增益(或基尼不纯度)来选择最优划分属性,但并不完全等同于C4.5的信息增益比和剪枝方法。这里,我将给出一个简化的C4.5算法的Python实践框架,但请注意,这不会是一个完整的C4.5实现,因为它将省略一些复杂的优化和剪枝步骤。如果你需要一个完整的C4.5实现,你可能需要考虑使用其
在上面的示例中,我们使用了scikit-learn提供的数据集(对于分类)和自定义的简单数据集(对于回归)来演示如何使用CART算法进行分类和回归任务。在Python中,使用CART算法的一个非常方便的方式是通过scikit-learn库,它提供了DecisionTreeClassifier(用于分类)和DecisionTreeRegressor(用于回归)两个类,这两个类都实现了CART算法。对

LSTM通过其内部的记忆单元和门控机制(遗忘门、输入门、输出门),能够捕获数据中的长期依赖关系,这对于预测未来的交通流量至关重要。然后,细胞状态通过tanh函数进行处理(将其值规范化到-1和1之间),并与sigmoid门的输出相乘,最终得到需要输出的部分。(4)输出门:基于新的细胞状态和(h_{t-1})、(x_t),计算输出门的sigmoid输出,并据此确定隐藏状态(h_t)。全连接层:在LST
比如,你向一个运行中的集群增加了节点。再平衡命令将会停用拓扑,然后在相应超时时间之后重分配worker,并重启拓扑。它会以一种安全的方式销毁一个拓扑,首先停用拓扑,在等待拓扑消息的时间段内允许拓扑完成当前的数据流。我们能够挂起或停用运行中的拓扑。当停用拓扑时,所有已分发的元组都会得到处理,但是。#配置storm UI(为了避免与spark的8080瑞口冲突,改为8089)#配置supervisor
接上个实验01,启动hadoop集群,启动结束后使用jps命令列出守护进程验证安装是否成功。拷贝02-上机实验/ds.txt到客户端机器,运行下面的命令和结果对照。5)复制/移动/删除文件。# slave2 节点。没有启动,所以需要执行。2)查看文件夹权限。

1)在Hive的官网http://mirrors.cnnic.cn/apache/hive/ 下载Hive,其文件为:apache-hive-1.2.1-bin.tar.gz。这里可以看到表中是有数据的,同时数据存储在指定的/user/root/hivedemo中,并没有存储在默认的/user/hive/warehouse中;visits_data.txt数据一共包含6列,分别对应名字,姓,访问时
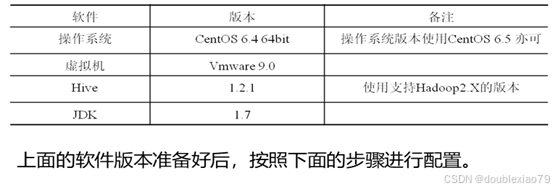
使用下面表中的软件版本进行配置:准备好后,按照下面的步骤进行配置。在VMWare主界面,点击“编辑”>“虚拟网络编辑”菜单进入虚拟网卡参数设置界面。选择VMnet8条目,点击“NAT设置”按钮后可以看到我们的VMWare Workstation为NAT连接的虚拟机设定的默认网关,此处为192.168.222.2,以及子网掩码,此处为255.255.255.0。

2)拷贝hadoop的安装目录的MapReduce Example的jar包到/opt目录下。1)拷贝02-上机实验/user.csv到客户端机器/opt目录下,并上传至HDFS。1)拷贝02-上机实验/ds.txt到客户端机器/opt目录下。这样的路径,可以避免这一问题,也可以设置环境变量来解决。3)运行MapReduce任务,导入数据。4)查看HBase 中user表的数据。下,解决的办法很简

因此,与仅在基本谐振模式(窄带器件)附近高效发电的经典悬臂式EH不同,FLC可以在谐振时达到几W的功率水平,在种模式之间的频率跨度上可以达到几百nW的功率水平。第一个FLCEH-MEMS制造样品进行了实验测试,ANSYS WorkbenchTM模型预测的耦合场行为(机械和压电)经过测量验证,显示了建模方法的良好准确性并证明了设备的多模态。设计概念讨论得到了仿真和实验测量的证实,验证了其性能,进而支
