


- @sgyuanshi


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
maven添加依赖首先,如何在maven项目中添加依赖包?这个相信对于大部分人来说是非常简单的,在pom.xml文件如下配置:<dependency><groupId>org.apache.spark</groupId><artifactId>spark-core_2.11</artifactId>...
近期,在使用spark的时候,发现spark在python下的使用,pyspark还挺好用的。你甚至可以把它当作pandas来使用,众所周知,pandas在数据处理方面是很强大的,不谈性能,它提供了许多的内置方法,非常的方便,极大的减少我们的开发时间。下面,简答来得展示一下它的具体使用。首先,我们初设一个SparkSession,并开启pandas的支持:Pandas with Apache Ar
首先,在这里说明一下,我遇到的错误如下:org.apache.hadoop.hbase.DoNotRetryIOException:/192.168.x.x:16020 is unable to read call parameter from client 10.47.x.x然后,spark读取HBase...
美团最新研究探索了在CTR预估任务中应用Scaling Law的可能性,提出了一套工业级解决方案。论文首先构建了具备扩展潜力的高精度CTR模型SUAN,采用统一注意力模块(UAB)整合时空维度的自注意力、自适应特征融合和SwiGLU FFN等先进技术。为应对线上推理的严苛延迟要求,通过稀疏自注意力和并行推断技术将模型压缩为轻量版LightSUAN,并创新性地采用在线蒸馏技术将大模型知识转移给学生模
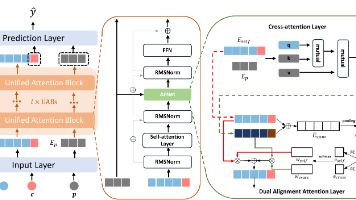
美团最新研究探索了在CTR预估任务中应用Scaling Law的可能性,提出了一套工业级解决方案。论文首先构建了具备扩展潜力的高精度CTR模型SUAN,采用统一注意力模块(UAB)整合时空维度的自注意力、自适应特征融合和SwiGLU FFN等先进技术。为应对线上推理的严苛延迟要求,通过稀疏自注意力和并行推断技术将模型压缩为轻量版LightSUAN,并创新性地采用在线蒸馏技术将大模型知识转移给学生模
本文介绍了字节跳动在工业级推荐系统中应用扩展定律(Scaling Law)的研究《TokenMixer-Large》,探讨如何通过架构优化将排序模型参数规模扩展至150亿。针对传统模型在扩展性上存在的残差设计缺陷、算子冗余、梯度更新不足等问题,TokenMixer-Large提出语义分组Token化、全局聚合Token等创新设计,重构了特征交互机制。该方法在抖音多个业务场景中验证有效,模型算力利用
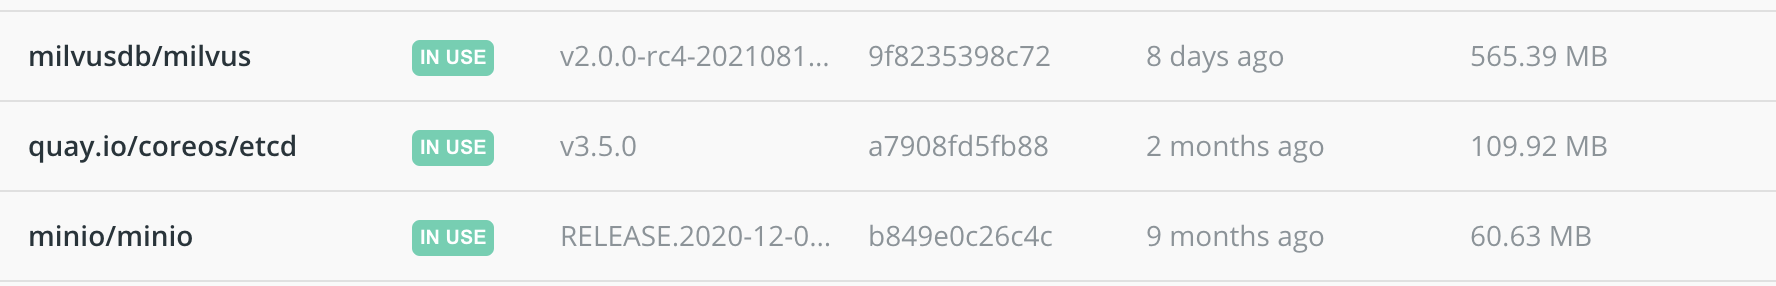
在推荐系统中,向量的最邻近检索是极为关键的一步,特别是在召回流程中。一般常用的如Annoy、faiss都可以满足大部分的需求,今天再来介绍另外一个:MilvusMilvusMilvus不同于Annoy、faiss这类型的向量检索工具,它更是一款开源向量数据库,赋能 AI 应用和向量相似度搜索。涉及的术语Filed:类似表字段,可以是结构化数据,当然还可以是向量;Entity:一组Filed,类似表
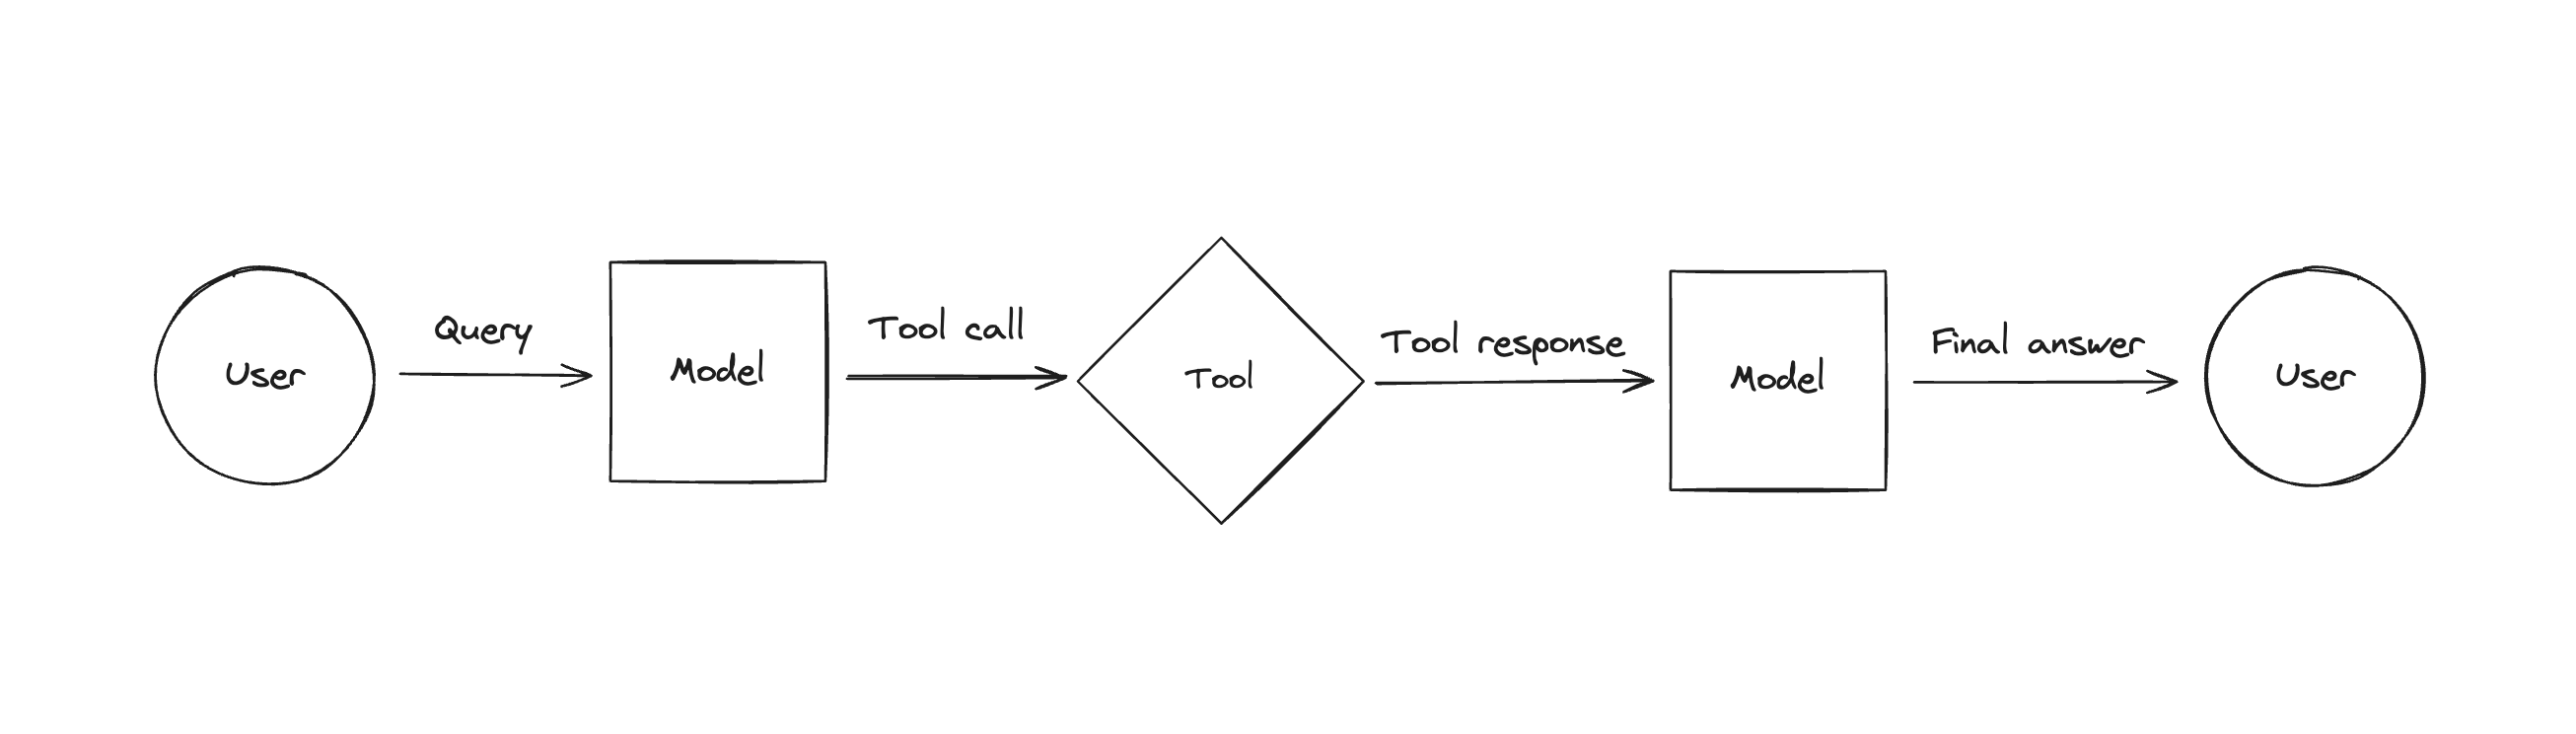
1. 这篇文章我们介绍了Agent这个热门的概念,以及它是如何依托LLM的function call来实现的2. 接着,再展示了借助LangChain的封装来简化这个开发过程,3. 并且还介绍了另外一种不依赖function call的Agent实现。
hadoop集群搭建教程:Hadoop集群搭建教程(一)Hadoop集群搭建教程(二)Spark集群官网下载:spark官网这里要注意spark兼容的hadoop版本接着解压:tar -zxvf spark-2.4.3-bin-hadoop2.7.tgz先在你的master节点进行spark的安装和配置,然后直接拷贝到其他节点就可以了。cd /usr/loca/spark/co...
在推荐系统中,向量的最邻近检索是极为关键的一步,特别是在召回流程中。一般常用的如Annoy、faiss都可以满足大部分的需求,今天再来介绍另外一个:MilvusMilvusMilvus不同于Annoy、faiss这类型的向量检索工具,它更是一款开源向量数据库,赋能 AI 应用和向量相似度搜索。涉及的术语Filed:类似表字段,可以是结构化数据,当然还可以是向量;Entity:一组Filed,类似表