


- @ruixijava


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
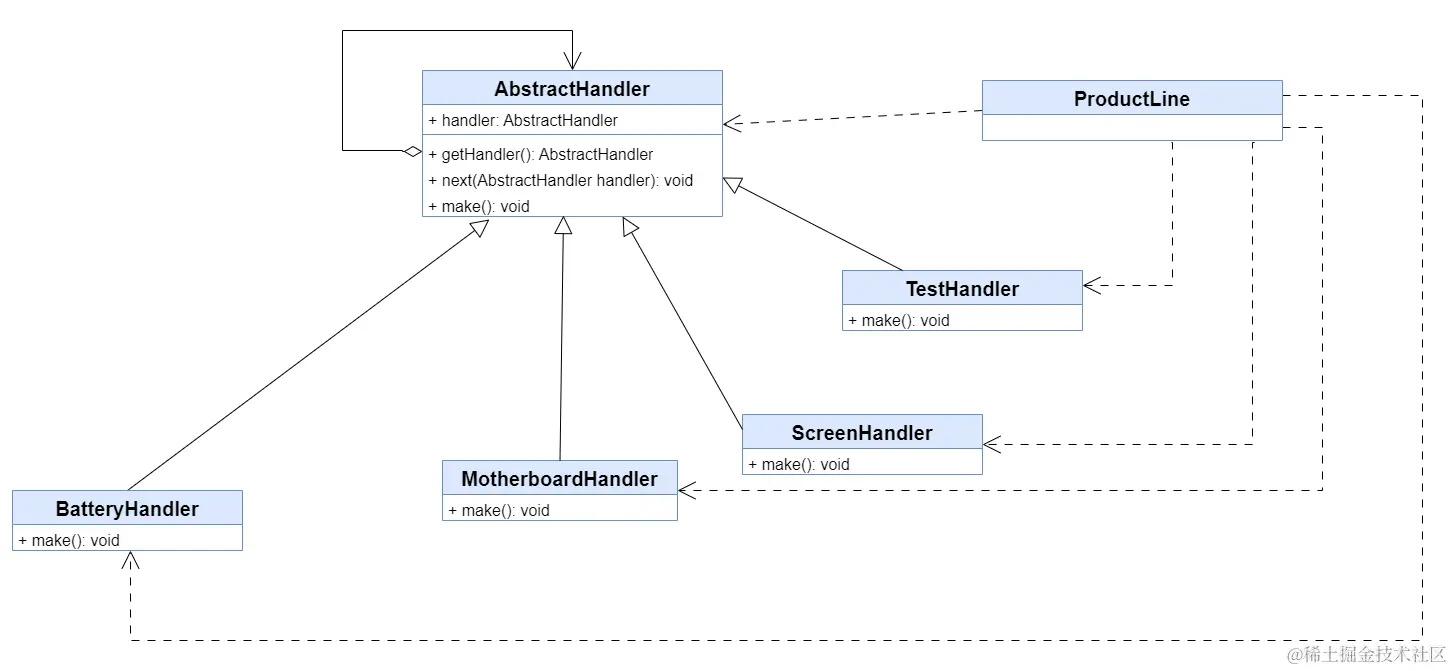
在一些业务场景下,为了避免请求发送者与多个请求处理者耦合在一起,于是将所有请求的处理者通过前一对象记住其下一个对象的引用而连成一条链;当有请求发生时,可将请求沿着这条链传递,直到有对象处理它为止。在责任链模式中,多个处理器(也就是刚刚定义中说的“接收对象”)依次处理同一个请求。一个请求先经过A处理器处理,然后再把请求传递给B处理器,B处理器处理完后再传递给C处理器,以此类推,形成一个链条。链条上的
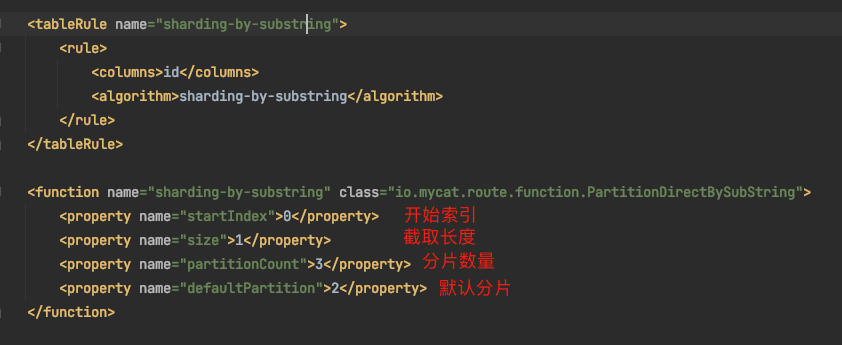
说明5: 第三个数据节点的索引是2,所以第三个数据节点是默认数据阶段,这里面保存了id以2开头的数据,可其他不满足分片规则的数据,例如id截取第一个字符串3和4,就不满足数据分片下标0,1,2的规则,就只能进入到默认的这个数据节点中。说明6:defaultPartition是默认的数据保存的数据节点,即如果万一出现了不符合的截取数据,都会存放在这个默认数据节点上,例如现在有一个截取子字符串为5开头
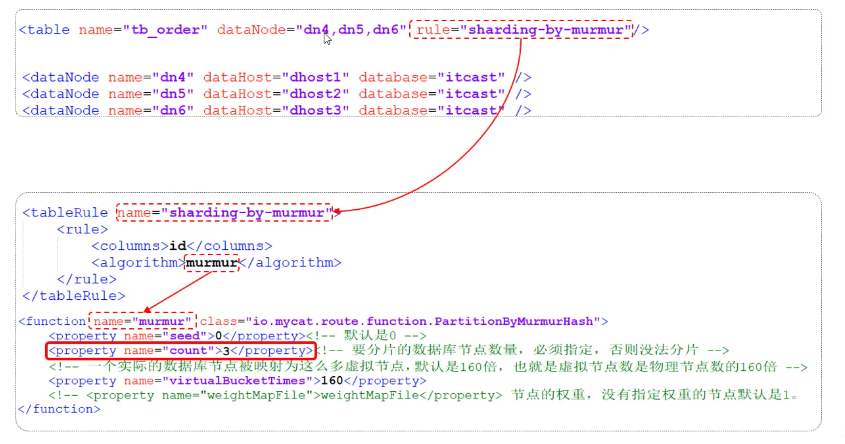
一致性哈希分片的实现思路和我们之前介绍的水平分表中的取模分片是类似的。只不过取模分片,采用的是利用主键和分片数进行取模运算,然后根据取模后的结果,将数据写入到不同的分片数据中。这时候就可以采用一致性hash算法分片,其分片的原则是根据id 哈希运算之后,然后再决定写入到哪个分片,所以我认为一致性哈希的分表方式是对取模分片的补充。说明4:一致性hash会根据id键hash运算之后决定写入到哪个分片,
Redis(Remote Dictionary Server)是一个开源的使用ANSI C语言编写、支持网络、可基于内存亦可持久化的日志型、Key-Value数据库,并提供多种语言的API。与Memcached类似,为了保证效率,数据都是缓存在内存中。但Redis的数据是存在内存中的,读写速度非常快,每秒可以处理超过10万次读写操作,因此被广泛应用于缓存。此外,Redis支持存储的value类型相

LOADING_PERCENT的值就是20),即设定loadingId为20%的阈值,例如当前id是10000,步长为10000,那么loadingId=12000。Leaf的snowflake模式依赖于ZooKeeper,不同于原始snowflake算法也主要是在workId的生成上,Leaf中workId是基于ZooKeeper的顺序Id来生成的,每个应用在使用Leaf-snowflake时,

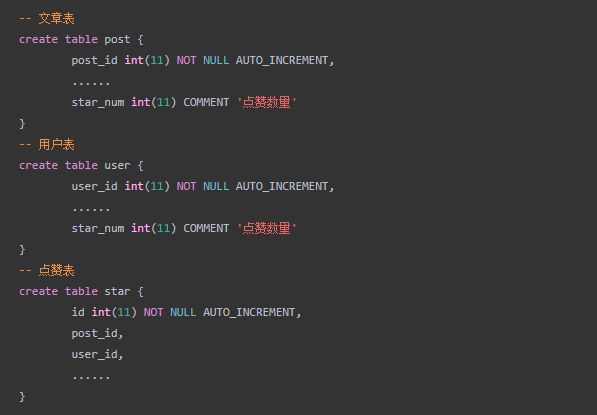
点赞功能是目前app开发基本的功能今天我们就来聊聊点赞、评论、收藏等这些场景的db数据库设计问题~我们先看一下头条和微博的例子这两个都是具有顶级流量的,后端肯定有复杂的架构,我们今天只谈大众化的方案。2.1 mysql方案mysql方案, 随着nosql的流行,大数据的持续热点,但是mysql仍然不可替代,对于大多数的中小项目,低于千万级的数据量,采用mysql分表+cache,是完全可以胜任的,
近年来,随着网络,移动设备,社交网络,博客的出现,创造了大量数据,这些新数据源创建的数据无法使用传统的数据存储技术(通常是关系数据库)进行处理。进而,最近几年出现了许多实现大规模数据的数据存储,比如 Hadoop 生态系统项目,几个 NoSQL 数据库以及搜索和分析引擎,如 Elasticsearch。

之所以会有这篇文章,主要是想总结一下大数据框架下常用的(准实时/实时)数据更新的常用解决方案,毕竟解决方案是通用的,只是实现方式会有差异。

好,经过我们前面文章的编写,大家可以了解到微信小程序开发相关的知识,了解完了这个微信小程序开发和云开发之后,从这篇文章开始,我再来给大家写一下关于 Uniapp 的知识。好,开始,那什么是 Uniapp 呢?这个时候我们不管三七二十一,先打开我们 Uniapp 官方文档,它官方地址也很简单,叫做dcloud.io这就是官方档。在官方文档当中有一个 uni-app,然后它下面写了一句话,开发一次多端

短信平台研发完成之后,满足了当时的业务需求,因为短信的管理也归于统一,提升了业务接入短信服务的效率,所以各个技术团队也比较认可。短信平台当前提供了手工绑定的短信模版的功能,也就是我们需要先在阿里云或者腾讯云先申请签名和模版,然后绑定到我们在平台创建的模版。阿里云、腾讯云、华为云提供的都是按照模版发送短信的接口,为了统一管理模版,我们也只提供按照模版发送短信的接口。
