- @m0_46324847


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
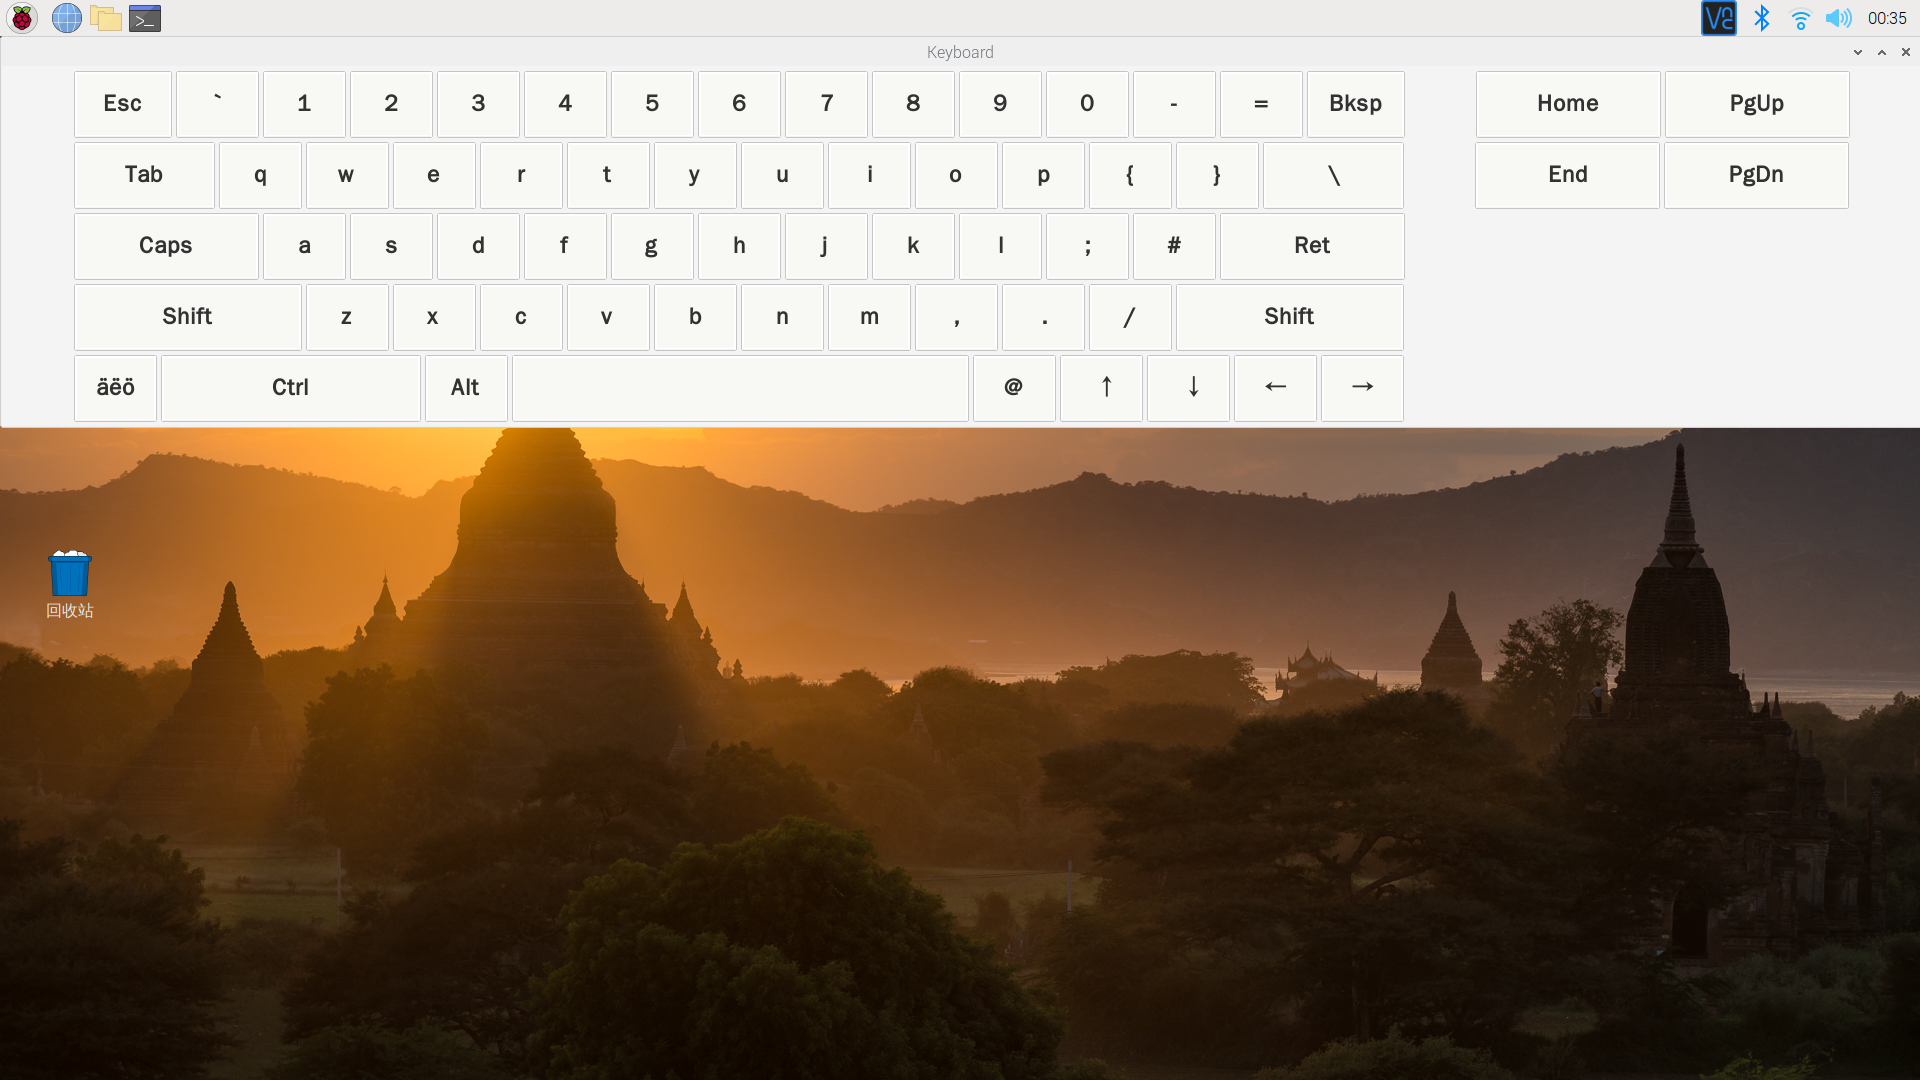
当我们买了触摸屏后,会发现没有键盘,还是无法输入,因此需要虚拟键盘。如果你的语言和地区是中文,那么安装虚拟键盘后可能显示乱码,所以还需要安装中文字体。如果你用的是树莓派的MIPI DSI触摸屏,出现触控漂移或者显示不正常的问题,需要进入`boot`目录下的`config.txt`文件,把`dtoverlay=vc4-fkms-v3d`注释掉,应该有两句,确保都注释掉。然后重启。
开启cmd,“以管理员身份运行”,先激活之前创建的虚拟环境并设置环境变量,导航到有.pb文件的地方,使用Windows上的Model Optimizer生成IR文件,按照你自己在Windows上的OpenVINO安装路径来运行下面的代码。接下来为Model Optimizer做准备,因为我只打算将TensorFlow的模型文件作为我的转换媒介,因此我只做关于TensorFlow的准备,其他模型文件
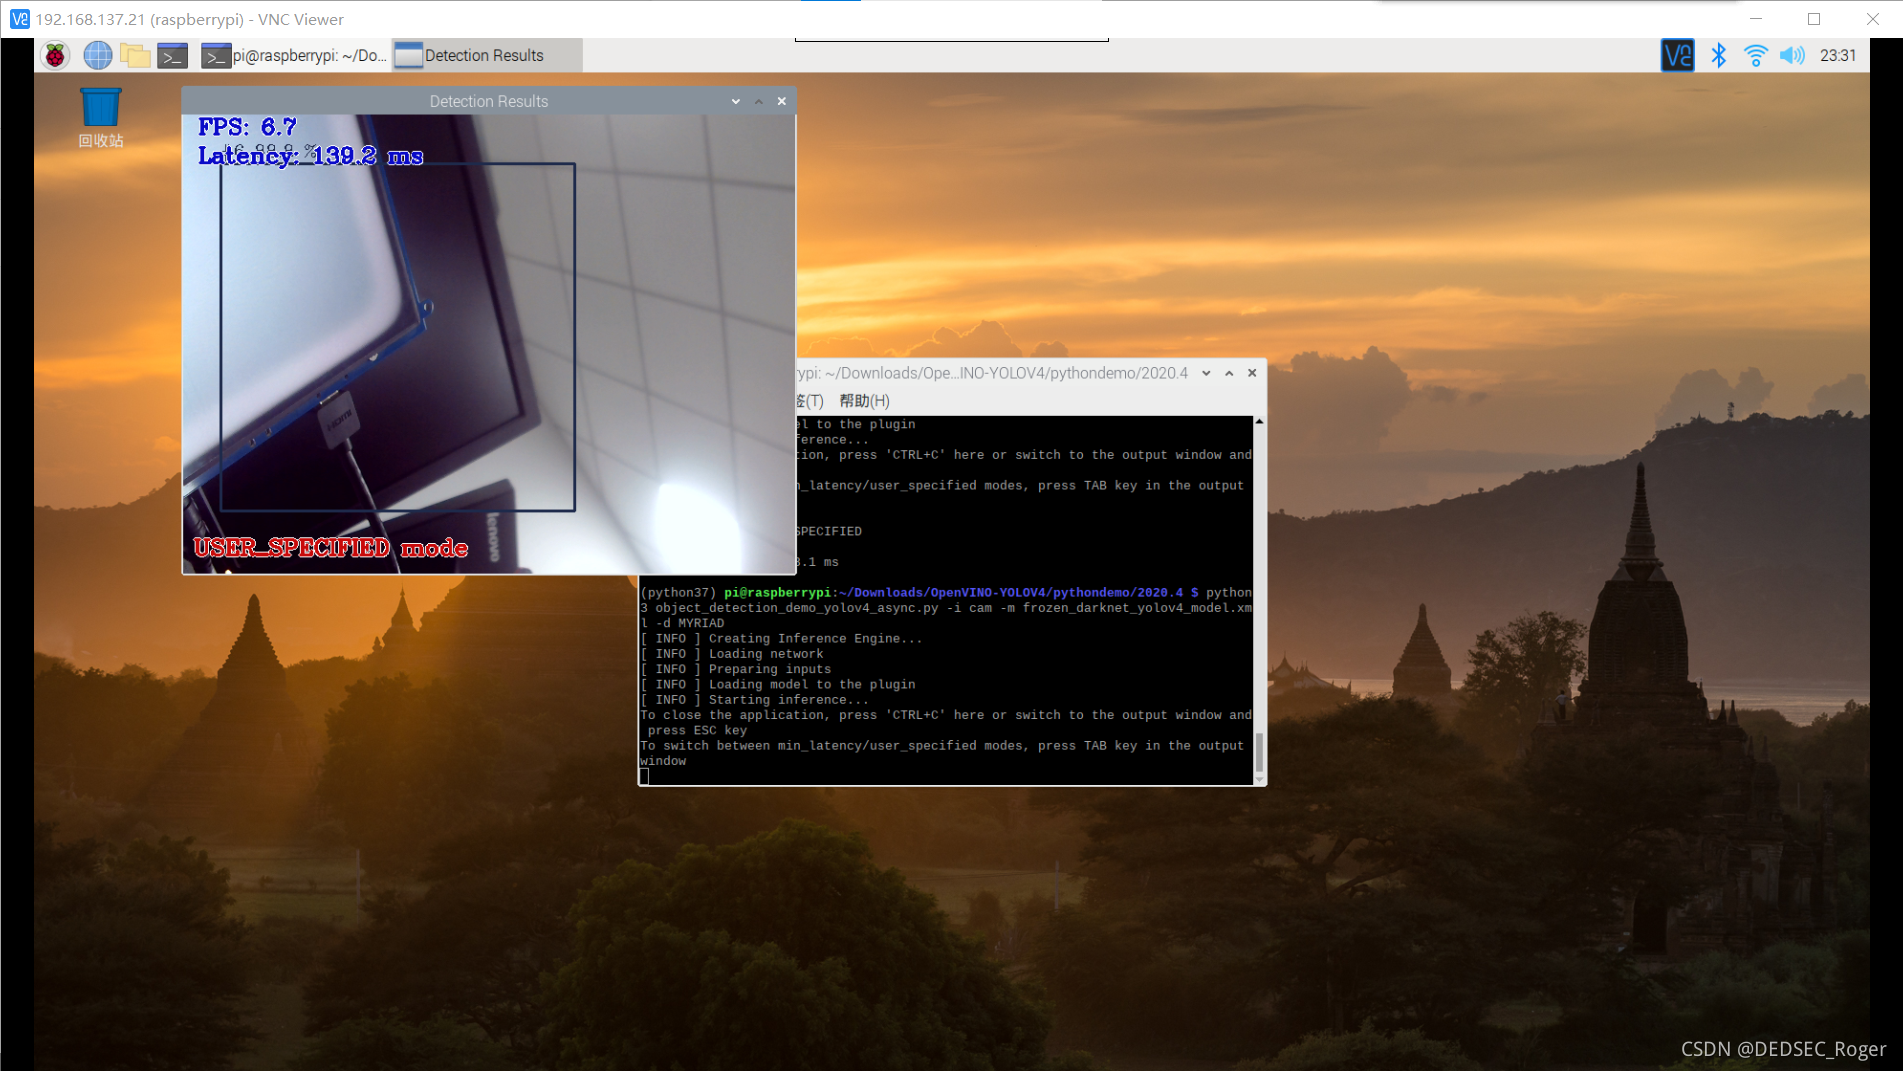
开启cmd,“以管理员身份运行”,先激活之前创建的虚拟环境并设置环境变量,导航到有.pb文件的地方,使用Windows上的Model Optimizer生成IR文件,按照你自己在Windows上的OpenVINO安装路径来运行下面的代码。接下来为Model Optimizer做准备,因为我只打算将TensorFlow的模型文件作为我的转换媒介,因此我只做关于TensorFlow的准备,其他模型文件
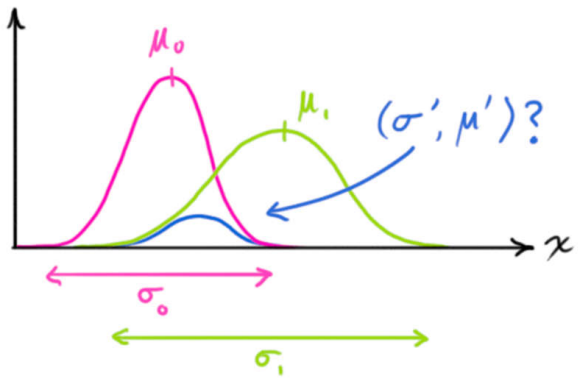
卡尔曼滤波的设计过程中需要定义两个变量,一个是状态量,另一个是观测量。
本文总结了4个常见音频处理相关错误的解决方案:1)运行funasr训练时缺少libsox库,通过sudo apt install libsox-dev解决;2)安装PyAudio时缺少portaudio头文件,安装portaudio19-dev即可;3)在Jetson上构建torchaudio时出现依赖冲突,使用--force-overwrite强制覆盖安装;4)torchaudio不支持ffmp

webrtcvad因此需要利用setup.py进行安装本文还提供了Python3.7下,webrtcvad的最新版本(2.0.11.dev0,最后一次更新是2021年2月)的win_amd64和linux_armv7l架构wheel文件的下载链接链接:https://pan.xunlei.com/s/VNNarY2ackt_NZSmMRcOja8eA1 # 提取码:wj6g。
机器学习领域名言“Garbage In, Garbage Out!”不论神经网络多么先进,如果输入是垃圾,那么输出也一定是垃圾在说话人识别领域,所需的最小数据单元,包括:一段只包含单一说话人语音的音频,被称为Utterance(话语)该段音频的说话人标签,能够唯一地在整个数据集中标识该说话人怎么样的数据不是Garbage呢?或者说,如何评价一个数据集的质量呢?有以下这些指标:说话人的数量每个说话人
【代码】Conda虚拟环境管理,示例:安装GPU版PyTorch、解决PowerShell启动时无法激活虚拟环境的问题、导出导入环境、安装GCC编译器。
ECAPA-TDNN是说话人识别中基于TDNN的神经网络,是目前最好的单体模型之一关于TDNN,可以参考深入理解TDNN(Time Delay Neural Network)——兼谈x-vector网络结构。