- @llovewuzhengzi


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
端到端:只有发送端会接收端有上面四层,所以可以直接看成上面四层是端到端直接相连的(因为只有传输过程只有一个处理到了上面四层,所以上面四层对应的连接也只有一个,类似路线中的出发点到终点)校验点:会话突然关闭,此时利用校验点恢复到之前的会话(如当传输大文件时候,如果突然中断,如果重传就浪费了之前传的部分了,利用校验点继续从之前的地方继续传)点到点:每个都有下三层,所以这个不能作为指示一个发送端和接收端

汇编中可以使用链接脚本中的符号来赋值,只不过要当链接后才会生效,即生成目标文件时并不会赋值成功(该符号会被识别为未定义符号(Undefined symbol)表示该符号在当前目标文件中没有定义,在链接阶段会被解析为其他目标文件中定义的符号。data段里声明了一个变量, 这个变量的值会被包进ELF里,ELF文件里会包括这个变量的符号与值,但是如果比如编译器发现, 你有些变量一开始是0, 编译器就可以
此时进入第一次小循环,此时当high移动到与low相同才跳出第一次小循环,此时由于low=high,第二次小循环也会跳出,随后大循环条件不满足了,跳出大循环。此时移动low位置的值到high位置上去,此时回到大循环,发现low

这里是先设高度最小为h则可以列出此时对应的节点数应该是大于前h-1层最多的节点数的,不然不可能还会有第h层嘛,然后此时n不可能比h层最多的节点数还多嘛,不然就有h+1层了,可以列出不等式,化简。有四层时,一二三四层的度数和相当于二三四层的节点数和(四层的度数和为零),但树的节点数还包括根节点,而一二三四层的度数和没有包括第一层的节点数,而第一层节点数为1。完全二叉树最多只有一个度为1的节点,如果有

LLM通过提示词来提取出与防汛抢险相关的术语+聚类算法抽取术语主题重组优化。亮点:三元组+《水利水电工程设计术语标准》SL26-2012—>五元组。数据处理:防汛抢险知识来自多源异构知识载体,半结构化和非结构化。概括:多源文本->LLM+卷积模块+语义关联层面提升。作者:周逸凡 段浩 赵红莉 赵慧子 李豪 韩昆。实体数据增强扩充数据,引入CNN改进提取模型。题目:水文模型知识图谱构建与应用。期刊:

RGB(Red, Green, Blue)颜色空间是一种基于光的加色模型,通过红、绿、蓝三种颜色光的不同强度组合来表示颜色。/camera/camera_info:相机的内参信息,如焦距、主点坐标和畸变系数等。image_rect_color话题的消息格式就是sensor_msgs/Image。/camera/image_rect_color:彩色的、经过畸变校正的图像数据。/camera/ima

RGB(Red, Green, Blue)颜色空间是一种基于光的加色模型,通过红、绿、蓝三种颜色光的不同强度组合来表示颜色。/camera/camera_info:相机的内参信息,如焦距、主点坐标和畸变系数等。image_rect_color话题的消息格式就是sensor_msgs/Image。/camera/image_rect_color:彩色的、经过畸变校正的图像数据。/camera/ima
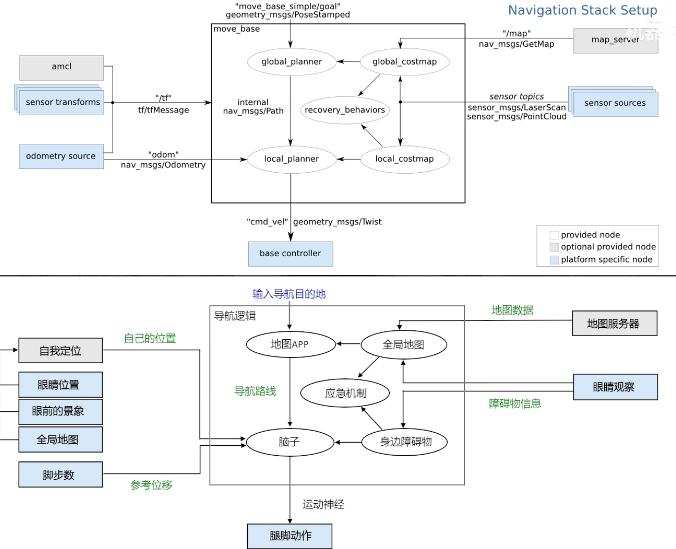
算法:使用多种算法,包括 sample_motion_model_odometry、beam_range_finder_model、likelihood_field_range_finder_model、Augmented_MCL 和 KLD_Sampling_MCL。clear_costmap_recovery 包提供了一种恢复行为(Recovery Behavior),用于在机器人导航过程中清
在每次互动后,你会更新之前状态下所选择了的行动的Q值,使用一个称为贝尔曼方程的公式。这个公式会考虑之前选择了的行动后的奖励和当前状态的Q值和之前状态的Q值,以更新当前状态下的Q值。这个公式可以简单解释为:当前状态下选择某个行动的Q值等于当前即时奖励加上折扣后的下一状态的最优行动的Q值。在Q学习中,你会记录每个房间的状态、每个行动的奖励以及你对每个行动的期望价值,这个期望价值被称为Q值。当你在迷宫中

项目地址:https://github.com/Narwhal-Lab/MagicSkills很多团队做多 Agent,最先失控的不是模型,而是 skill 管理。同一个 skill 目录,往往既想给 Codex、Cursor、Claude Code 这类 Agent 应用使用,也想给 LangChain、LangGraph 这类框架里创建的多个 agent 使用。