- @hogwarts_ziqi


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
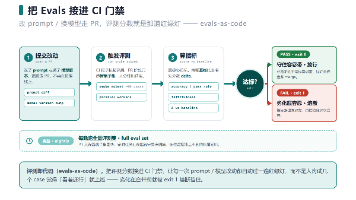
本文提出将大模型应用的评测流程纳入CI,实现“evals-as-code”门禁机制。通过将评测集、执行器与阈值代码化并集成至PR流水线,确保每次改动自动触发冒烟测试与全量评估,实现分钟级反馈与长尾问题拦截。关键在于:评测应从“人肉跑一次的报告”变为“自动强制执行的门禁”,结合规则裁判防漂移、分层评测控成本,真正守住质量底线。
本文分享了用DeepSeek Harness与Workbuddy组合实现测试用例自动生成的实践:通过10分钟配置,将PRD与接口文档转化为结构化用例,覆盖正常、异常与边界场景。虽需人工复核8条左右,但效率远超手写,尤其适合文档清晰的后端迭代。核心价值不在于“取代”测试,而在于释放人力,聚焦业务理解与风险洞察。
以上⽅式我们其实是重新打开了某个app, 但是更多的时候,我们是期望测试⼀个已经打开的app,试想⼀下如下的场景,某个app需要登录,登录的⽅式⼜⽐较复杂,扫码登录或者短信登录,或者有验证码,但是如果成功登录以后,⼀段时间以后再次打开就不会进⼊到登录界⾯,此时,我们不希望每次运⾏⽤例的时候,都重新登录,这时,我们就需要使⽤ selenium 来测试⼀个打开着的应⽤。接下来我们来写⼀个简单的测试,就
Google 官方提供了一个 Android 自动化测试工具(Java 库),基于 Accessibility 服务,功能很强,可以对第三方 App 进行测试,获取屏幕上任意一个 App 的任意一个控件属性,并对其进行任意操作,但有两个缺点:测试脚本只能使用 Java 语言;测试脚本要打包成 jar 或者 apk 包上传到设备上才能运行;实际工作中,我们希望测试逻辑能够用 Python 编写,能够
Midscene.js 以 93.10% Pass@1 成绩在 AndroidWorld 基准中表现亮眼,其核心是通过视觉理解替代传统选择器,实现零代码维护的跨端 GUI 测试。它用自然语言描述操作意图,依赖多模态模型定位元素、执行动作并断言结果,显著降低前端变更带来的维护成本。但代价是判定非确定性、模型调用开销与延迟。官方建议结合 aiQuery 与标准断言提升可靠性。该方案适用于复杂界面和高变
DeepSeek此次扩招150人,聚焦服务端开发与Agent弹性计算,虽非直接招聘测试岗,却为测试人提供了新机遇。面对AI系统落地中的稳定性、幂等性、异常恢复等工程挑战,过往的测试经验——如边界值、接口验证、日志排查、回归测试——依然关键。真正重要的是将经验转化为可验证的测试方法:从“接口返回成功”到“业务结果一致”,从“重试机制”到“防止重复执行”。通过模拟真实场景(如退款超时重试),构建可复现
<think>我们需要根据内容生成≤150字的文章摘要。内容是科技圈大瓜:OpenAI终止向Cursor提供模型,背景是SpaceX收购Anysphere。然后重点转向测试人的启示:不要依赖单一AI工具,提升核心能力,传统测试vs AI测试开发差距。最后呼吁系统训练。我们需要提炼核心。字数限制严格。摘要应包含事件、启示、对测试人的建议。注意不要包含图片、格式。语言简洁。我们需要控制在150字以内。
摘要:随着大模型应用落地,软件测试领域出现新方向——大模型测试(LLM Testing),测试重点转向验证AI回答准确性、幻觉问题、稳定性等。面对海量测试数据,哈希表成为关键数据结构,用于测试数据去重、快速查询和版本关联分析。测试工程师需要掌握哈希表的核心能力(去重、快速查询、唯一标识),以应对AI测试中的数据管理挑战。从传统自动化测试到AI质量工程,测试对象和所需能力发生显著变化,数据处理和算法
摘要:针对大模型输出不确定性的自动化测试难题,文章通过一个电商客服系统的真实故障案例,提出四层断言策略:1) 请求侧约束输出格式;2) 硬断言验证JSON结构;3) 用更强模型(LLM-as-Judge)进行语义软断言;4) 通过多次采样统计稳定性。核心观点是分层管控不确定性:机器契约零容忍,语义容错但设阈值,并强调禁用失败用例的危险性。最终沉淀为"格式硬锁+语义软判+稳定性兜底"的方法论,配套工
本文揭秘大模型性能测试核心差异:告别传统QPS/RT,聚焦TTFT(首字延迟)、TPOT(逐字间隔)等流式指标。通过真实大促事故(首字延迟从0.8秒飙至15秒),剖析容量规划缺失、KV cache打满、无降级等痛点,并给出阶梯压测、拐点识别、混长文本等实战方法,助你应对AI面试高频题。