- @aqin1012


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
新建测试表:-- Table: public.table01-- DROP TABLE public.table01;CREATE TABLE IF NOT EXISTS public.table01(id bigint NOT NULL,name character varying COLLATE pg_catalog."default" NOT NULL,age integer,CONSTRA
本文介绍了Ollama本地大模型的安装和使用指南:1)下载安装Ollama;2)下载模型(推荐qwen2.5:7b);3)通过Docker启动OpenWebUI界面(端口3000);4)验证本地服务是否正常运行。关键验证点包括检查11434端口监听、API接口测试和容器环境变量确认。最后提供了容器重启命令以便修复问题,实现完全本地的ChatGPT功能。
大模型Skill的本质是"上岗说明书",将人类经验转化为可重复执行的规则。就像带教新员工一样,Skill需要明确任务边界、操作流程、输出标准和风险防范,而非追求"万能"。一个有效的Skill应包含:明确职责定位、适用场景判断、核心执行步骤、结果格式要求和错误处理机制。新手应从高频、明确的小场景入手(如会议纪要整理),通过真实样本测试迭代,逐步实现稳定输出。S
大数据技术命名趣闻:Kafka灵感来自卡夫卡小说的迷宫感,Hadoop是开发者两岁儿子对玩具象的昵称,雅虎团队用动物命名(Pig、Hive)形成"大数据动物园"。Flink(德语"灵巧")、Doris(希腊海神)、Spark("火花")等名称都巧妙体现技术特性,YARN则展现程序员的自嘲幽默。这些名字背后藏着父子温情、文学情怀和团队趣事,
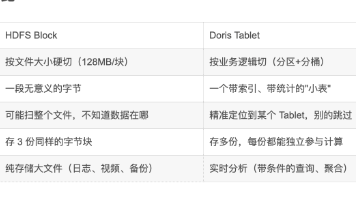
HDFS Block与Doris Tablet的核心区别在于数据切分逻辑:HDFS采用固定大小(默认128MB)的物理分块,如同"按斤切肉"般无视数据内容,仅存储原始字节段,查询时需全量扫描;而Doris Tablet则基于业务逻辑进行"按户分粮"式分区(如时间)和分桶(如用户ID哈希),每个Tablet都是带索引的独立数据单元,支持精准定位查询。这种差异使
数据仓库是企业数据管理的核心系统,它通过分层架构(ODS→DWD→DWS→ADS)对业务数据进行采集、清洗和建模,解决OLTP系统(如MySQL)在海量数据分析中的性能瓶颈。其核心采用星型模型,通过事实表(记录业务事件)和维度表(描述业务实体)的关联支持多维度分析。典型技术栈包括:Hive(离线存储)、Spark(批量计算)、Flink(实时处理)、Doris(高速查询)和Kafka(数据传输),
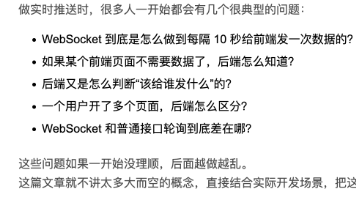
本文从实际开发场景出发,梳理了 WebSocket 定时推送的基本实现方式,并详细解释了后端如何识别前端连接、维护订阅关系,以及实现“给谁发什么”的精准推送机制。
本文对比分析了Hive和Doris在存储成本、计算成本和隐性成本三个维度的差异。Hive采用弹性计算模式,存储成本低廉但查询延迟高;Doris基于常驻进程,存储成本高但查询响应快。Hive的成本与数据规模和加工次数线性相关,适合批处理;Doris的成本与服务等级和留存体量挂钩,适合实时查询。建议采用混合架构:Hive处理全量数据,Doris仅承载需要快速访问的热数据,以优化总体成本效益。两种技术成
本文对比分析了Hive和Doris在存储成本、计算成本和隐性成本三个维度的差异。Hive采用弹性计算模式,存储成本低廉但查询延迟高;Doris基于常驻进程,存储成本高但查询响应快。Hive的成本与数据规模和加工次数线性相关,适合批处理;Doris的成本与服务等级和留存体量挂钩,适合实时查询。建议采用混合架构:Hive处理全量数据,Doris仅承载需要快速访问的热数据,以优化总体成本效益。两种技术成
【摘要】Hive与Doris在数仓架构中形成互补:Hive作为低成本批处理底座,负责PB级数据存储和ETL计算;Doris作为交互式查询引擎,加速高频访问的热数据查询。典型分层架构中,Hive承载原始数据清洗和规范化(ODS/DWD),结果数据通过批量加载进入Doris提供秒级响应(DWS/ADS)。二者的本质差异在于成本模型和适用场景——Hive适合离线重计算和冷数据存储,Doris擅长实时分析