登录社区云,与社区用户共同成长
邀请您加入社区
是操作数组的工具类,提供了排序、查找、拷贝、转换等静态方法,简化数组操作。public class ArraysDemo { public static void main(String[] args) { int[] arr = {10, 20, 5, 30, 15};
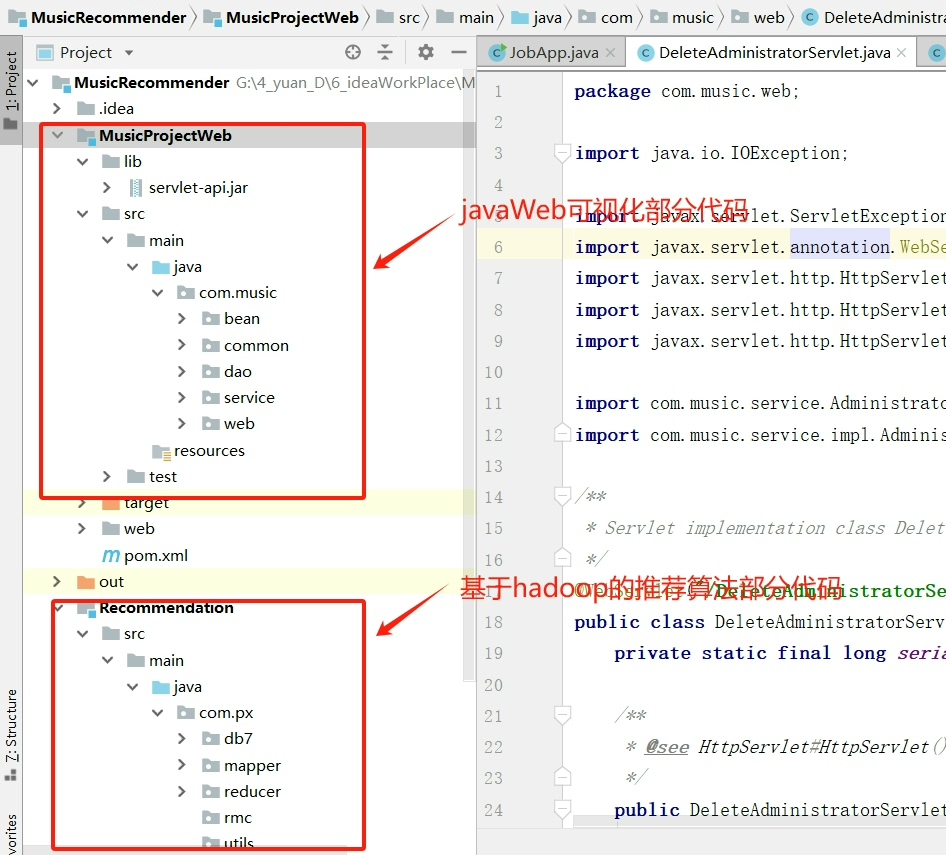
这个系统主要运用MapReduce来处理海量数据集,计算歌曲推荐分支并排序,从而给用户提供个性化的歌曲推荐。它包含了数据存储、大数据分析、Web后端以及可视化前端几个关键部分,运行起来十分便捷,而且数据文件和SQL文件一应俱全,全方位为用户打造高效的歌曲推荐服务。我们使用的可是真实的海量数据集,足足有23197条呢!另外,还有简单易懂的部署文档、运行演示视频,甚至连论文参考和毕业答辩PPT都准备妥
o1-o2。
本文介绍了STL中的关联式容器map和set,它们底层采用红黑树实现,具有高效的增删查操作(O(logN))。set是纯key搜索结构,map是key/value结构,两者都支持排序且默认升序。文章详细讲解了set和map的构造、迭代器、增删查操作,重点分析了map通过operator[]实现插入和修改的机制,以及利用仿函数实现容器定制的原理。同时对比了set/multiset和map/multi
研究提炼了运维流程的智能化路径,探讨了算法优化与系统架构设计的关键挑战,并基于实际案例验证了该体系在提升运维效率、降低风险等方面的有效性,为智能化运维实践提供了理论支持与实践参考。通过算法创新与系统架构的深度融合,研究提出的方法在效率、可靠性和扩展性方面展现出显著优势,为推动智能运维领域的技术标准化与规模化应用奠定了基础。算法优化是智能运维的核心支撑。某互联网企业的实践案例表明,部署本方案后,系统
关键在于它的硬件适配逻辑很务实:不需要A100/H100这种高端卡,在主流办公级设备如搭载RTX3060(12G显存)的工作站上就能稳定输出1080P口播视频,单条耗时控制在45秒以内,实测连续生成20条不掉帧、不崩进程。有家区级融媒体中心上线后反馈说,原来外包一条政策解读短视频要三天加两千元,现在编辑自己写稿→导入系统→选模板→点击生成,全流程不到八分钟,且成品通过内部审核直接发稿。该方案支持中
他们这两年在IQC端部署的数据中台,并非堆硬件,而是把每批母粒的MFI、密度、灰分、色差等十余项核心物性数据,全部绑定唯一生产工单号和原料溯源码。比如现在有些厂开始用数据中台整合近红外光谱初筛、全自动MFI测试仪实时回传、历史批次趋势比对等功能,一旦某项关键参数超出预设区间,系统自动标红并推送至质量工程师终端——不等人发现问题,问题还没发生就被识别出来。最近有家山东的客户反馈,同样配方、同一台吹膜
本文介绍了LeetCode上两道双指针算法的经典题目解法。11题"盛最多水的容器"通过双指针法优化,从数组两端向中间移动,每次移动较矮的指针,计算最大面积,时间复杂度为O(n)。15题"三数之和"先排序数组,固定一个数后用双指针寻找另外两个数,通过去重处理避免重复解,关键点在于对a、left、right三个指针的去重逻辑处理。两题都展示了双指针算法在数组问题
首先set容器的底层实现机制是红黑树,但是我们在使用的时候压根不用管这个容器的底层实现机制是什么,那样反而会干扰我们对容器的理解。关于我上一个关于set容器的学习内容,那一片段写的太水了,这次得写详细点。不过在学习了一段时间后,我发现这些容器的很多函数居然是相通的。在打了一堆比赛后,我终于发现了关于set的一个妙用。在我学习这个函数之前,我一直拿这个当做计数器的变量。在初次学习set这个容器的时候
大数据处理中,排序算法需兼顾效率与可扩展性。主流方案包括:1)Timsort作为混合排序算法,适应Spark等分布式场景;2)外部排序通过分片归并解决内存限制;3)基数排序适合固定长度数据;4)BitonicSort专为并行计算优化。工程实践中,通常采用分治策略,先局部排序再全局归并。内存充足时优选Timsort,海量数据用外部排序,特定场景使用基数或并行排序。理解这些算法特性有助于优化分布式系统
本文深入探讨Top K问题的五种解法,从信息学奥赛中的全排序到大数据面试中的堆应用,再到分布式环境下的MapReduce方案。通过Python/Java代码示例和性能对比,帮助开发者掌握不同场景下的最优选择策略,提升算法实战能力。特别适合准备NOI/OpenJudge竞赛或大数据面试的读者。
本文深入探讨了C++ STL容器(map/set)在天梯赛L2排序题中的高效应用,通过对比传统cmp函数与STL自动排序技巧,展示了如何更优雅地处理复杂排序需求。文章结合天梯赛实战案例,详细解析了map、set和优先队列的使用方法,帮助开发者提升代码简洁性和性能表现。
【代码】25大数据 13-1 选择排序。
【代码】25大数据 13-2 选择排序。
记录每一轮最后一次发生交换的位置,该位置之后的元素已经有序,下一轮只需遍历到此位置即可。return arr。
在C++编程中,标准模板库(STL)是提升开发效率与代码质量的核心工具。其设计基于泛型编程思想,通过容器、算法和迭代器三大组件的解耦与协作,实现了数据结构和算法的独立与复用。从技术价值看,STL提供了大量经过高度优化和严格测试的通用组件,能显著减少重复编码,增强程序的可维护性和可移植性。在实际应用场景中,诸如数据排序、区间求和、极值过滤等常见操作,均可通过组合STL内置算法优雅实现。本文以比赛评分
本文介绍了在PyCharm 2026.1.1中新建Python项目的步骤:1)选择预建的空项目文件夹auto-test2026;2)演示了快速排序算法的实现与运行。总结了项目命名规范(建议小写字母+短横线),推荐新建项目时勾选自动创建Git仓库。特别强调了环境配置的两个选项(继承基础解释器包和全局可用)的潜在问题,指出两者都可能导致依赖冲突和环境污染,建议谨慎选择以保持项目独立性。
桶排序(基数排序)凭借 “分而治之” 的思想,在整数排序场景中展现出极高的效率,是算法学习和工程实践中不可或缺的工具。不同于比较类排序算法,桶排序通过将数据分配到不同的 “桶” 中,再对桶内数据单独排序,最后合并结果,能在特定条件下实现线性时间复杂度。从基础的冒泡、选择排序,到进阶的快速、归并排序,每种算法都有其独特的适用场景。然后按当前位分桶,提取出当前位的数字,将该数放入对应桶中,再清空原先数
Python排序和查找
桶排序(Bucket Sort)是一种分布式排序算法,它将待排序的元素分布到有限数量的桶中,然后对每个桶中的元素进行排序,最后按照桶的顺序依次取出所有元素得到有序序列。桶排序是计数排序的升级版,利用了函数的映射关系,高效与否的关键在于这个映射函数的确定。
选择排序(Selection Sort)是一种简单直观的排序算法,其核心思想是在未排序序列中查找最小(或最大)元素,然后将其放到已排序序列的末尾。该算法通过不断选择剩余元素中的最小值来实现整个序列的排序。
实现简单:逻辑清晰,易于理解和实现稳定性:相等元素的相对位置保持不变原地排序:只需要常数级别的额外空间适应性:对基本有序的数据效率较高。
模型基于KDA混合线性注意力机制(Kimi Delta Attention)和注意力残差(Attention Residuals)技术构建,原生支持视觉理解,并拥有100万token上下文窗口,在保持顶尖能力的同时,将KV Cache压缩75%,长上下文解码速度最高提升6.3倍,大幅优化了训练与推理的效率及成本。例如,真武M890对Kimi K3模型架构的核心算子进行优化,显著提升推理的算力和带宽
分治(Divide and Conquer)是一种重要的算法设计策略,其核心思想是将一个复杂的问题分解为若干个规模较小但结构与原问题相似的子问题,递归地解决这些子问题,然后将子问题的解合并得到原问题的解。
本文详细介绍了8种常用排序算法及其Java实现,包括插入排序、希尔排序、选择排序、堆排序、冒泡排序、快速排序、归并排序和计数排序。每种算法从核心思想、实现代码到性能分析(时间复杂度、空间复杂度、稳定性)进行全方位解析,并针对特定算法提供优化版本(如快速排序的递归和非递归实现)。文章还特别介绍了排序算法的基础概念(稳定性、时空复杂度等),帮助读者全面理解排序算法的特性和适用场景。所有代码均封装完整,
本章重点讲解以下四种排序算法。
关于【C++中常用的排序方法之——冒泡排序】目录:一、 冒泡排序的定义二、冒泡排序的算法原理三、冒泡排序的算法示例四、冒泡排序的算法分析五、冒泡排序的特点六、冒泡排序的优点七、冒泡排序的缺点
本文系统讲解了11种经典排序算法,包括插入排序、希尔排序、选择排序、堆排序、冒泡排序、快速排序、归并排序和计数排序等。每种算法都提供了Java实现代码,并详细分析了核心思想、时间/空间复杂度、稳定性和适用场景。文章特别对比了不同规模数据下的最优选择:小规模数据推荐插入/选择排序;中等规模适用希尔排序;大规模数据首选快速排序(非稳定)或归并排序(稳定)。针对特殊场景如元素范围小的整数数组,计数排序性
排序算法是将一组数据按特定顺序(如升序、降序)重新排列的算法,核心评价指标为时间复杂度(数据规模与操作次数的关系)、空间复杂度(算法所需额外存储空间)和稳定性(相等元素排序后相对位置是否不变)。复杂度:时间复杂度 O(nlogn)(平均)、O(n²)(最坏,基准选极值);空间复杂度 O(logn)(递归栈,平均)/ O(n)(最坏)。复杂度:时间复杂度 O(n²)(最坏/平均)、O(n)(最好,已
本文总结了八大经典排序算法的Java实现,包括冒泡、选择、插入、希尔、归并、快速、堆和计数排序。每种算法均提供代码示例,并分析其时间复杂度(如快速排序平均O(n log n)、冒泡最坏O(n²))、空间复杂度(如归并排序O(n))和特性(稳定/不稳定)。文章还给出优化策略,如快速排序的三数取中法、冒泡排序的提前终止标志。针对不同场景需求,可选择合适的算法:小数据用插入排序,大数据用快速排序,范围小
本文介绍了C++中常见的7种排序算法,包括冒泡排序、插入排序、希尔排序、堆排序、选择排序、快速排序和归并排序。每种排序算法都给出了代码实现,并比较了它们的时间复杂度和空间复杂度。排序算法在C++编程中非常常见,既可作为独立算法使用,又可作为其他算法的基础工具。文章通过清晰的代码示例和复杂度分析,帮助读者理解不同排序算法的特点和适用场景。
此外,三向比较返回的强序(std::strong_ordering)使CPU分支预测器能更准确预测比较结果的分支走向,分支预测失败率降低约30%,尤其在处理浮点数或复杂对象时,避免了传统比较因NaN或部分相等导致的不可预测分支。此外,三向比较支持弱序(std::weak_ordering)和偏序(std::partial_ordering),使排序算法能自然处理浮点数、字符串等特殊类型的比较需求,
排序是前端开发中最常见的操作之一。无论是用户列表、商品价格还是文章日期,都需要高效的排序算法来处理。本文将深入解析五种核心排序算法,从原理到实践,帮你全面掌握这一必备技能。
第1轮( i=0 ): j 的上限是 arr.length - 1 (因为 arr.length - 0 - 1 = arr.length - 1 ),即比较所有元素;条件 arr[j] > arr[j+1] :判断当前元素 arr[j] 是否比下一个元素 arr[j+1] 大(升序排序的条件)。第2轮( i=1 ): j 的上限是 arr.length - 2 ,即忽略最后1个已排序元素;第 i
关于【C++中常用的排序方法之4——希尔排序】一、希尔排序的定义二、希尔排序的发展历史三、希尔排序的的排序过程四、希尔排序的基本原理五、希尔排序的的特点六、希尔排序的的优点七、希尔排序的的缺点
关于【C++中常用的排序方法之3——插入排序】一、插入排序的定义二、插入排序的的思路及具体步骤三、插入排序的的算法性能四、 插入排序的适用场景五、 插入排序的的特点六、 插入排序的的优点七、插入排序的的缺点
本文介绍了如何实现一个物品排序系统。通过定义一个Item类,包含类型、品质和名称属性,随机生成10个物品并存入List。核心是使用Lambda表达式实现多条件排序:优先按类型降序,其次按品质降序,最后按名称长度降序。代码展示了完整的排序过程,包括随机物品生成、自定义比较器的实现以及排序结果的输出。该方案适用于需要复杂排序规则的物品管理系统。
重复循环遍历,每次比较相邻的两个元素,如果前大于后就交换,这样每次最大的元素都会交换到最后,每次循环遍历时去掉最后的元素。
方法时间复杂度空间复杂度稳定性适用场景面试推荐归并排序(递归)O(n log n)O(log n)✅通用⭐⭐⭐⭐⭐归并排序(迭代)O(n log n)O(1)✅严格要求O(1)空间⭐⭐⭐⭐⭐快速排序平均 O(n log n)O(log n)❌链表已排序时易超时⭐⭐计数排序O(n + k)O(k)✅值域范围小⭐⭐⭐。
有一组数据在数组当中存储,我们默认第一个数为有序的,然后从他后面的数开始,先用一个变量把数据值保存,把这个数值在数组中对应的位置空出来,我们需要拿着这个数值和他前面的值一次进行比较,比较会出现两种情况:一、比前面的值小,前面的值要往后挪动到空位,又有新的空位,更新一下空位以及继续要比较的前一个数;,借助前后指针,一开始前指针指向key,后指针指向key+1位置,后指针指到的如果是小于key的值,前
本文介绍了三种解决「数组第K大元素」问题的方法:1) 直接排序法(O(nlogn)),适合快速建立解题直觉;2) 小顶堆法(O(nlogk)),简洁高效;3) 快速选择算法(平均O(n)),通过随机pivot和双指针分区实现最优解。重点分析了快速选择的实现细节,包括主循环的二分收敛、随机基准选择、双指针扫描逻辑及边界处理。文章建议面试优先掌握快速选择写法,并提供了清晰的代码实现和面试讲解要点。