
Leetcode215 三种写法完成数组中的第K个最大元素 【hot100算法个人笔记】【java写法】
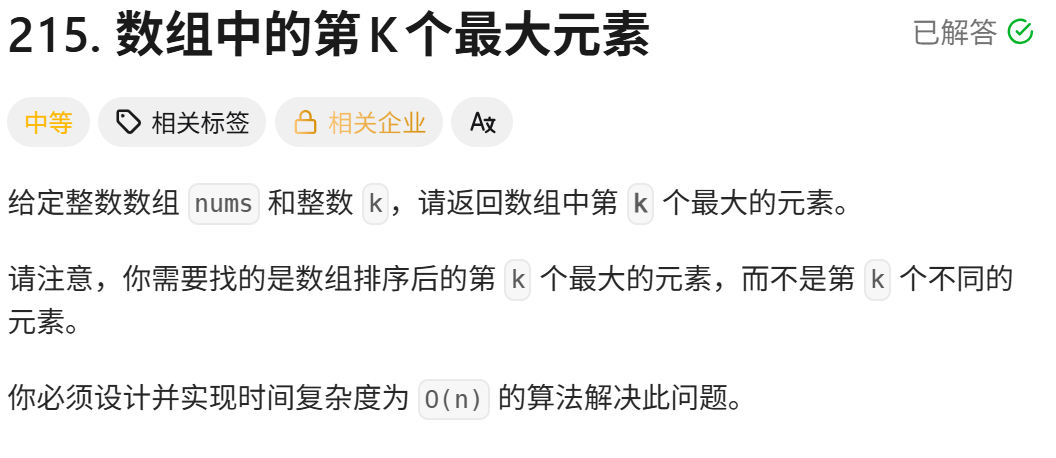
刷过这道题的小伙伴,大概率都写过「sort 后直接取第k个」或者「小顶堆」的解法,毕竟这是面试的高频题。
但不知道你有没有发现,这种“找第k大”的题目,最适合的解法,同时也是LeetCode要求的解法:

其实是快速选择(Quickselect)算法,它可以在平均 O(n) 的时间复杂度内找到答案,空间复杂度只有 O(1)。
一、题目回顾:数组中的第K个最大元素到底要做什么?
先来回顾一下这道非常经典的题目:
给定整数数组
nums和整数k,请返回数组中第 k 个最大的元素。请注意,你需要找的是数组排序后的第
k个最大的元素,而不是第k个不同的元素。
例如:
nums = [3,2,1,5,6,4], k = 2,输出5nums = [3,2,3,1,2,4,5,5,6], k = 4,输出4
题目本质非常清晰:我们不需要对整个数组排序,只需要找到排在特定位置的元素即可。这就给快速选择这样的“部分排序”算法留下了巨大的优化空间。
二、阅读建议:循序渐进的学习路径
很多小伙伴一上来就看快速选择的各种指针交换和边界条件,很容易被绕晕。这里我给大家整理了三种实现的阅读顺序建议:
- 如果你刚接触这道题,先看排序法,直接调用语言内置函数搞定,快速建立整体解题的直觉;
- 如果你想兼顾易懂和效率,再看优先队列(堆)的写法,用 JDK 自带的小顶堆轻松实现 O(nlogk);
- 如果你已经熟悉了前面的思路,想要搞懂最优解,或者准备面试,最后再深入手写快速选择,彻底拿下 O(n) 的实现细节。
三、标准实现:用 JDK 自带工具优雅解题
我们先来看两种不需要自己手写底层逻辑的写法,它们能帮你快速解决问题,而且代码非常短。
写法一:直接排序 —— 新手最友好的解法
这个写法完全不需要动脑筋,调用 Arrays.sort 排好序,然后直接取倒数第 k 个元素:
class Solution {
    public int findKthLargest(int[] nums, int k) {
        Arrays.sort(nums);
        return nums[nums.length - k];
    }
}
时间复杂度 O(nlogn),空间复杂度 O(logn)(排序栈空间)。虽然直接粗暴,但在数据量不大的情况下,它依然是一个可以快速通过判题系统的解法,非常适合刚接触题目的同学建立第一印象。
写法二:小顶堆 —— 用 PriorityQueue 轻松实现 O(nlogk)
另一种简洁又不失效率的方式,是借助 JDK 的优先队列 PriorityQueue,维护一个大小为 k 的小顶堆:
class Solution {
    public int findKthLargest(int[] nums, int k) {
        PriorityQueue<Integer> minHeap = new PriorityQueue<>(k);
        for (int num : nums) {
            minHeap.offer(num);
            if (minHeap.size() > k) {
                minHeap.poll();
            }
        }
        return minHeap.peek();
    }
}
堆中始终只保留 k 个最大的元素,堆顶就是第 k 大的元素。时间复杂度 O(nlogk),在很多场景下非常好用,代码量也很少,是刷题和面试中很常见的“稳妥写法”。
四、最优实现:快速选择的深度解析
堆的解法已经很不错了,但它的时间复杂度是 O(nlogk),空间也要 O(k)。如果面试官追问:“有没有 O(n) 的解法?” 这时候就轮到快速选择闪亮登场了。
快速选择是快速排序的“半成品”:我们只关心目标位置是否被排好,不关心其他部分是否有序。它的核心步骤与快排的 partition 完全相同:
- 随机选取一个基准元素
pivot; - 通过前后双指针,把小于
pivot的元素放到左边,大于的放到右边; - 看
pivot的最终位置是不是我们要找的“索引”; - 如果是,直接返回;如果不是,只去一侧继续查找。
下面就是我们今天要重点分析的一段快速选择实现:
class Solution {

    private static final Random rand = new Random();

    public int findKthLargest(int[] nums, int k) {
        int n = nums.length;
        int targetIndex = n - k;          // 第k大 转换为 升序数组中的下标
        int left = 0;
        int right = n - 1;
        while (true) {
            int i = partition(nums, left, right);
            if (i == targetIndex) {
                return nums[i];
            }
            if (i > targetIndex) {
                right = i - 1;
            } else {
                left = i + 1;
            }
        }
    }

    private int partition(int[] nums, int left, int right) {
        // 随机选取一个元素作为基准,换到最左边
        int i = left + rand.nextInt(right - left + 1);
        int pivot = nums[i];
        swap(nums, left, i);

        i = left + 1;
        int j = right;
        while (true) {
            while (i <= j && nums[i] < pivot) {
                i++;
            }
            while (i <= j && nums[j] > pivot) {
                j--;
            }
            if (i >= j) {
                break;
            }
            swap(nums, i, j);
            i++;
            j--;
        }
        swap(nums, left, j);   // 将基准元素放到正确位置
        return j;              // 返回基准元素的最终下标
    }

    private void swap(int[] nums, int i, int j) {
        int temp = nums[i];
        nums[i] = nums[j];
        nums[j] = temp;
    }
}
1. 主循环中的二分收敛逻辑
在 findKthLargest 方法中,我们首先将“第 k 个最大元素”转化为“升序数组中的目标下标”:
int targetIndex = n - k;
例如数组长度 6,第 2 大元素就是升序后下标为 4 的元素。接下来我们不断调用 partition,每次都会得到一个已经“归位”的基准元素下标 i(即左侧都小于它,右侧都大于它)。然后通过二分的方式缩小搜索范围:
- 如果
i == targetIndex,直接返回; - 如果
i > targetIndex,说明目标在左半边,更新右边界; - 如果
i < targetIndex,说明目标在右半边,更新左边界。
这样就不需要完全排序,平均每次都能把问题规模减半,从而得到平均 O(n) 的时间复杂度。
2. partition 中的随机基准与双指针扫描
这段 partition 是快速选择的精华,它使用了随机 pivot + 前后双指针的经典写法,有效避免退化成 O(n²) 的最坏情况。
首先,随机选一个元素作为基准,并与最左边的元素交换,防止固定选第一个或最后一个在极端输入下性能恶化:
int i = left + rand.nextInt(right - left + 1);
int pivot = nums[i];
swap(nums, left, i);
然后设置两个指针 i = left + 1(从左边向右扫描)和 j = right(从右边向左扫描):
- 左指针
i一直向右移动,直到遇到不小于 pivot 的元素; - 右指针
j一直向左移动,直到遇到不大于 pivot 的元素; - 如果
i < j,说明左边有“大元素”且右边有“小元素”,交换它们; - 最终
i >= j时,j的位置就是 pivot 应该放置的正确位置,将 pivot 与nums[j]交换,返回j。
这个过程保证了 partition 结束后,pivot 左边全小于等于它,右边全大于等于它。
3. 边界条件与死循环的避免
while (i <= j) 的判断是关键:当 i == j 时,我们仍然需要检查 nums[i] 与 pivot 的关系,然后才会跳出循环,避免了因为相同元素或初始有序状态造成的死循环。swap(nums, i, j) 之后立即 i++; j--; 能确保指针始终在相向而行,也是防止死循环的重要细节。
五、面试中的手写考察
面试中,如果被问到这道题,面试官大概率会期待你写出手写的快速选择实现。相比直接使用堆,快速选择更能体现出你对快排分区过程的理解,以及对随机化算法、边界处理的掌握程度。
上述代码其实就是一份非常适合面试的“干净版”实现,它没有多余的外部依赖,只用了基本的数组操作和 Random 对象。面试时,你可以按下面几个重点来向面试官讲解:
- 为什么要把第 k 大转换为目标下标? (统一为升序下标的索引问题)
- 随机选取 pivot 的意义是什么? (避免最坏情况,保证期望 O(n))
- partition 中双指针的移动条件怎么设计? (
< pivot和> pivot的严格不等式,以及交换后同时移动指针) - 为什么循环条件是
while (true)并靠i >= j跳出? (保证单次 partition 完整执行,后续二分确定方向)
把这些点讲清楚,手写快速选择就能成为面试中的加分项。
六、三种写法的适用场景对比
现在我们已经有了三种典型的解法,它们各自适合什么样的场景呢?
| 写法 | 时间复杂度 | 空间复杂度 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|---|
| 排序法(Arrays.sort) | O(nlogn) | O(logn) | 代码最短,新手友好 | 没有利用“部分排序”的特性,效率稍低 | 快速过题,数据量小的场景 |
| 小顶堆(PriorityQueue) | O(nlogk) | O(k) | 代码简洁,逻辑清晰,效率不错 | 仍然需要堆空间,不是最优 O(n) | 日常刷题,k 较小时的在线处理 |
| 快速选择(Quickselect) | O(n) 期望 | O(1) | 时间和空间均最优,面试考察重点 | 代码复杂,指针和边界易出错 | 面试手写,海量数据离线场景 |
总结一下:
- 刷题时,堆的写法最通用,两三行核心逻辑搞定,且不容易写错。
- 学习时,先看排序法理解题意,再用堆理解“维护前k大”的思想,最后深入快速选择弄懂分区细节。
- 面试时,一定要能流畅地手写出快速选择,并清楚讲解随机 pivot、双指针 partition 以及二分收敛的完整流程。
总结
数组中的第 K 个最大元素是一道典型的分治算法题,它背后融合了二分思想与快排分区操作。
无论是简单粗暴的排序、优雅简洁的优先队列,还是极致高效的快速选择,本质上都是在试图平衡“代码复杂度”与“运行效率”的经典取舍。
真正吃透这道题,你就同时掌握了排序、堆和快速选择三大核心工具,这对刷题和面试都大有裨益。
更多推荐

 12
 0
- 0


 已为社区贡献7条内容

所有评论(0)