登录社区云,与社区用户共同成长
邀请您加入社区
其中capture是捕获列表,params是参数列表,opt是函数选项,ret是返回值类型,body是函数体;下面逐个详细介绍。捕获列表capture:捕获一定范围内的变量,具体使用方式[]:不捕获任何变量。[&]:捕获外部作用域中所有变量,并作为引用在函数体内使用(按引用捕获)[=]:捕获外部作用域中所有变量,并作为副本在函数体内使用(按值捕获),拷贝的副本在匿名函数体内部是只读的。如果想要修改
我们可以看到,因为get_first和get_second做了一个只读的事情,所以返回的链表的第二个值(代表新的a)和第三个值(代表新的b)都是旧的a和b。然后我们就拿到了一个3×4的长方形的面积12了。当然,即使是仓促设计出javascript的那个人,大概也是知道构造函数也是一个函数的,而且类的成员跟函数的上下文链表的节点对象其实没什么区别。call by need这个东西在某些著名的实用的函
为解决传统差分进化算法(DE)在复杂函数寻优中易陷入局部最优、参数敏感性高及鲁棒性不足的问题,本文聚焦DE算法及其改进变体L-SHADE-cnEpSin,以CEC2005标准测试函数集为基准,开展系统性的寻优性能对比研究。DE算法作为经典全局优化算法,凭借结构简单、收敛快速的特性在多领域广泛应用,但固定参数设置使其在高维、多峰问题中表现受限。L-SHADE-cnEpSin在SHADE算法基础上,融
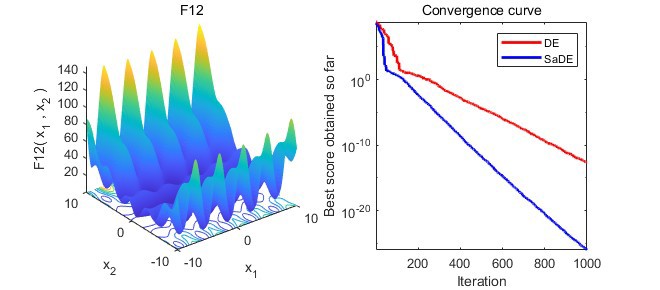
在智能优化算法的江湖里,差分进化(DE)就像一位基本功扎实的剑客,而它的升级版自适应差分进化(SaDE)则更像精通变招的宗师。而自适应差分进化算法 (SaDE)算法是差分进化的一个变种,其主要特点是引入了自适应机制来动态调整算法参数(例如变异和交叉概率)。而自适应差分进化算法 (SaDE)算法是差分进化的一个变种,其主要特点是引入了自适应机制来动态调整算法参数(例如变异和交叉概率)。总的来说,DE
Docker 是一个容器化平台,用于将应用及其依赖打包成一个独立的运行单元,以此来实现通过一次的构建,到处运行。namespace就是资源隔离机制进程(PID)文件系统(mount)网络(net)主机名(UTS)用户(user)IPC。
摘要: 本项目基于Java SpringBoot框架开发高考录取分数推荐与可视化系统,旨在解决传统志愿填报信息滞后、分析单一等问题。系统采用MySQL5.7数据库,整合爬虫技术实时采集各省市录取数据,通过协同过滤算法实现个性化院校推荐,并结合可视化技术生成分数线趋势图、院校热力图等。管理员可通过/admin路径登录后台管理数据,系统支持多维度分析(如分数、位次、地域等),帮助考生规避“滑档”风险。
大模型高效运行的关键在于数据结构优化。注意力机制的O(n²)复杂度成为计算瓶颈,通过稀疏化、分块和流水线等数据结构创新实现突破:稀疏矩阵减少非必要计算,分块处理(Flashattention)降低内存需求,流水线提升并行效率。这些技术支撑了PaLM2、GPT-4等千亿参数模型的训练和推理,将计算效率提升3-4倍。未来动态稀疏、量子数据等新结构将助力更大规模的多模态模型发展。这些看不见的数据结构创新
AVL树:是一种 自平衡二叉搜索树,由苏联数学家 Georgy Adelson-Velsky 和 Evgenii Landis 在 1962 年提出,其名称来源于这两位发明者的名字缩写。AVL树要么是空树,要么是满足以下性质的二叉搜索树:其左、右子树也都是 AVL 树并且左、右子树的高度差的绝对值不超过 1假如以pParent为根的子树不平衡,即pParent的平衡因子为2或者-2,分以下情况考虑
Kafka 作为流数据核心枢纽,认证是数据安全的基石。内部集群需防未授权访问,企业级多团队共享需统一身份管控,金融医疗等场景需满足合规要求,云原生环境需动态管控第三方接入。其技术必要性在于阻止身份伪造、数据窃听,保障数据完整性,适配多场景安全需求。
本文介绍了C++中stack(栈)和queue(队列)两种适配器容器的核心特性与使用方法。栈遵循后进先出规则,适用于函数调用栈等场景;队列采用先进先出原则,常用于任务调度等场景。文章详细讲解了两者的头文件、定义方式、常用接口(如push/pop/top等),并提供了代码示例。最后通过4道经典算法题(最小栈、栈序列判断、逆波兰表达式求值、二叉树层序遍历)进行实战演练,帮助读者掌握这两种容器的实际应用
本文总结了哈希表的学习和应用过程。作者通过4天分散学习,完成了8道哈希表相关题目,涵盖基础哈希和前缀和+哈希表两类题型。学习过程分为三个阶段:最初对哈希表仅停留在概念层面;中期在实践中踩坑,遇到容器选择、数组比较等问题;后期终于理解哈希表本质是空间换时间,掌握其三种主要用途(判断存在性、统计频次、分组)及对应容器选择原则。文中详细分析了典型题目解法,如两数之和的哈希优化、字符重排的数组模拟技巧等,
在这篇文章中,我介绍了 PySpark SQL 中两个较为不寻常的数据操作函数,并给出了一些它们可以非常有用的用例。如果您需要将 dataframe 中的数组或字典数据字段转换为它们的组成部分,并将它们放入 dataframe 中的单独记录中,请使用explode函数。可以将函数视为explode函数的逆函数。使用这个函数将单个 dataframe 记录中的项目聚合到集合中。_ 好的,就到这里吧。
到这里,stack、queue 和 priority_queue 的概念、实现原理以及它们为什么“看起来简单却不能遍历”,我们都已经讲清楚了。你会发现,它们本质上并不是新的容器,而是建立在其他顺序容器之上的“使用方式约束”。理解了这一点,不管是自己模拟实现、刷OJ题,还是面试手撕代码,都会轻松很多。这一篇就到这,下一篇我们继续搞点更硬核的东西。
简介:本质:set和multiset区别:功能描述:创建set容器以及赋值构造:赋值:示例:总结:功能描述:函数原型:示例:总结:功能描述:函数原型:示例:总结:功能描述:函数原型:示例:总结:学习目标:区别:示例:总结:功能描述:两种创建方式:示例:3.8.8 set容器排序学习目标:主要技术点:示例一 set存放内置数据类型总结:利用仿函数可以指定set容器的排序规则示例二 set存放自定义数
当数据以键值对形式存在,可以考虑用map 或 multimap。总结:map中所有元素都是成对出现,插入数据时候要使用对组。统计 — count (对于map,结果为0或者1)查找 — find (返回的是迭代器)map插入方式很多,记住其一即可。插入 — insert。删除 — erase。清空 — clear。
在Java 8之前,我们需要实现一个简单的比较器时,往往需要编写冗长的匿名内部类。而现在,通过Lambda表达式,同样的功能可以用一行代码实现。开发者在处理集合操作时,能够用更直观的方式表达自己的意图。虽然Lambda表达式带来了编码的便利,但在性能敏感的场景下需要谨慎使用。理解Lambda的实现原理和性能特征很重要,特别是在循环和频繁调用的场景中。方法引用作为Lambda表达式的一种特殊形式,进
浅析了EXT2文件系统的核心机制。首先介绍了i_block数组的三级索引结构,推导出单个文件最大存储容量的计算方法;其次详细阐述了inode和block位图的管理机制,解释了删除文件时仅需修改位图而无需清空数据块的原理。文章还分析了文件系统"满"的三种情况,并重点讲解了超级块和组描述符的关键作用。在文件操作层面,系统性地揭示了新建、删除、查找和修改文件时内核的底层处理流程,特别
map容器核心概念总结(入门)
size( ):返回底层有效元素的个数empty( ):判断容器是否为空reserve(20):vector预留空间,只给容器底层开辟指定大小的内存空间,并不会添加新的元素resize(20):扩容,不仅给容器底层开辟指定大小的内存空间,还会添加新的元素swap( ):两个容器进行元素交换。
以下是手写List容器的扩展功能实现,包含排序、反转和合并功能。
下面我将手写一个简化的List容器核心函数实现,包含插入、删除和查找功能。
手动实现线程安全 List 容器的核心是:使用锁保证基本安全,并引入原子操作优化关键部分(如计数器)。设计时需权衡性能、复杂性和可靠性。上述 Python 示例提供了一个起点,您可根据需求扩展(如支持迭代器安全)。多线程编程中,始终优先测试并发行为,以确保无数据竞争。如果您有特定语言或场景需求,我可以进一步调整实现!
在 C++ 开发中,std::list作为标准库提供的双向链表容器,因其高效的元素插入和删除操作而被广泛应用。然而,在某些特定场景下,开发者可能需要自定义 List 容器以满足性能、内存或功能上的特殊需求。本文将通过手写一个简化版的 List 容器,并设计一系列兼容性测试,验证其与标准库std::list在功能、接口和性能上的兼容性,确保自定义容器能够无缝替代标准库实现。1 2。
必要性:避免冗余注释(如i++ // 增加i),只解释非显然逻辑实时性:代码修改时同步更新注释一致性:团队统一使用或//风格可追溯性:关键变更添加版本标记(如可读性:新人快速理解设计思路可维护性:修改时明确影响范围可扩展性:标注潜在优化点引导后续开发。
关联容器通过 键(Key) 高效存储和访问元素,它们的元素位置取决于键值,而非插入顺序。主要分为两类:1.无序关联容器,依赖于链式哈希表,增删查O(1)使用头文件:#include<unordered_set>、#include<unordered_map>set:集合keymap:映射表[key, value](键值对)unordered_set:单重集合unordered_multiset
DestinationRule 指定服务的子集(版本)。创建 YAML 文件(如。
随着uFog联盟标准的推进,Java雾计算架构正在向四个方向演进:①基于Sulong的LLVM多语言支持,②eBPF驱动的内核级服务治理,③量子耐受密码学框架集成,④元宇宙虚实交互接口标准化。在5G-V2X场景实践中,系统可自动在TCP和QUIC间切换,配合智能拥塞控制算法,使传输抖动降低67%。通过Enclave扩展实现Java代码模块的可信执行,结合Intel SGX和ARM TrustZon
学习笔记,部分内容参考网络教学视频,侵删。
lambda 表达式本质是匿名函数对象—— 就是不用给函数起名字,写完就能用,适合实现简单、短期使用的逻辑(比如你的加法逻辑,只用来配合 bind,没必要单独写一个命名函数)std::bind是头文件里的工具,作用是绑定函数的部分参数、调整参数顺序,生成一个新的 “参数调整后” 的函数简单说:它能把一个 “多参数函数” 变成 “少参数函数”(固定部分参数),或者重新排列参数的顺序也是头文件里的工具
容器是用来存储和组织数据的类模板容器-顾名思义就是拿来装东西的。你可以装标准的基本数据类型,如int,double,string等、也可以装复杂的自定义类型,例如class 定义的类的对象,对象指针等复合类型的数据。C++ stl标准库提供了多种容器,每种容器都有特定的用途和性能特点。对于map,set,multimap,multiset,当对顺序有要求时候,选择这些,对顺序无要求时候,可以选择带
题目摘要: 该问题描述了一个数字猜测魔术的实现原理。给定N个数字、K张卡片(每张包含M个数字),和F个朋友各自的"是/否"回答序列。要求编写程序根据回答序列准确猜出朋友心中选择的数字(1到N之间)。关键在于每张卡片的数字组合会生成唯一的"是/否"模式,通过建立回答模式与数字的映射关系来猜测。若模式对应多个数字则输出0。输入包括卡片数字和回答序列,输出为猜测结
本文介绍了栈和队列这两种基本数据结构。栈遵循后进先出(LIFO)原则,通过数组和链表两种方式实现,分别具有固定大小和动态扩展的特点。队列遵循先进先出(FIFO)原则,采用循环数组和链表两种实现方式,解决了"假溢出"问题。文章还介绍了C++ STL中stack、queue和deque的使用方法。通过手工实现和STL工具的比较,强调了理解底层原理和善用标准库的重要性。这些数据结构广
过去,我们“收集数据”;现在,我们“理解数据”;未来,我们可能会与数据共生。当数据系统具备自学习与自演化能力,它们将像生态系统一样生长——不断吸收信息、生成洞察、重构自身结构。那时,数据不再是工具,而是企业的“有机智能”。它既能看见过去,也能预见未来。数据的觉醒,不是数字的爆发,而是人类智能与机器智能,共同书写的进化篇章。
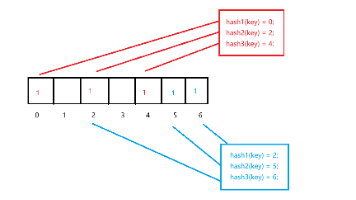
比如:二、布隆过滤器引言:我们在使用新闻客户端看新闻时,它会给我们不停地推荐新的内容,它每次推荐时要去重,去掉那些已经看过的内容。问题来了,新闻客户端推荐系统如何实现推送去重的? 用服务器记录了用户看过的所有历史记录,当推荐系统推荐新闻时会从每个用户的历史记录里进行筛选,过滤掉那些已经存在的记录。 如何快速查找呢?大意是不同的数据结构有不同的适用场景和优缺点,你需要仔细权衡自己的需求之后妥善适用它