- @xiameimei_win


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
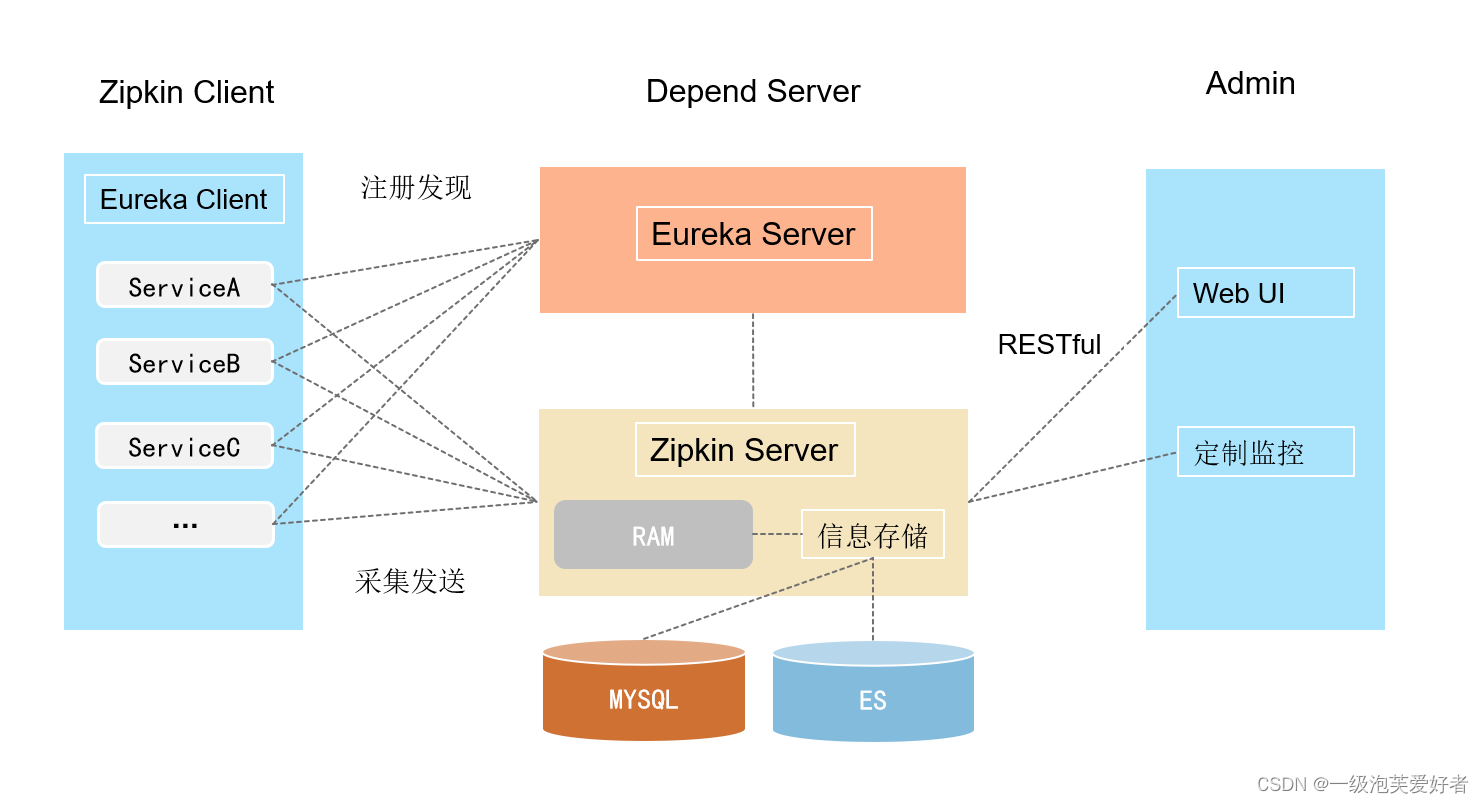
公司内部一个功能的实现,底层可能调用多个应用系统在调用这个功能的同时,可能会出现多种情况,比如访问较慢,出现错误,可能需要进行定位所以,我们需要快速定位服务错误点大规模分布式系统可参考这个链接跨微服务的API调用发生异常,要求快速定位出问题出在哪里;跨微服务的API调用发生性能瓶颈,要求迅速定位出性能瓶颈。
jmeter不需要安装,直接打开注意系统环境。

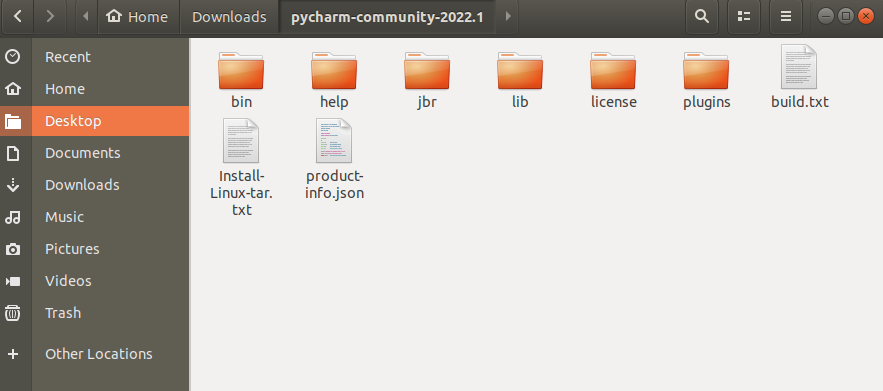
1.0 下载Ubuntu配套的pycharm2.0 拖动到Ubuntu中,进行解压缩3.0 切入到pycharm的bin文件夹下,打开pycharm4.0 创建一个项目,并且打开5.0 关闭pycharm ,并且再次打开就可以点击add获取remove6.0 支持中文打开指定的文件添加语句-Drecreate.x11.input.method=true...
一、本地运行pyspark --master local[N]local[N] 代表在本地运行,N的值代表同时执行N个程序(1)查看当前的运行模式:sc.master(2)读取本地文件,路径之前加上“file:”testFile = sc.textFile('file:/usr/local/spark/README.md')(3)显示项数testFil...
1.0 安装注意点安装注意点:NameNode 和 SecondaryNameNode 不要安装在同一台服务器2.0 开始配置核心文件2.1 打开文件所在的位置cd /opt/module/hadoop-3.1.3/etc/hadoop2.2 配置core-site.xmlvim core-site.xml<?xml version="1.0" encoding="UTF-8"?>&l
1.0 备份原来的源sudo cp /etc/apt/sources.list /etc/apt/sources_init.list2.0 更换源sudo gedit /etc/apt/sources.list使用gedit打开文档,删除原来的所有内容,将下边的清华源复制进去,然后点击保存关闭。使用清华源deb https://mirrors.tuna.tsinghua.edu.cn/ubuntu

pycharm配置一键pep8
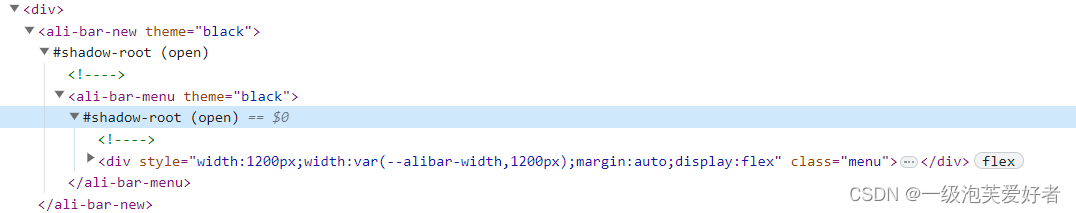
通过shadow-root的父级定位到shadow-root,再通过语句进行操作两种方法:第一种,Python种JS实现第二种,selenium实现。
TensorFlow正常保存模型,但是加载模型失败。将模型的位置,放置在无中文的目录下就可解决这个问题。保存模型的时候,保存位置出现中文。