- @xdpcxq1029


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
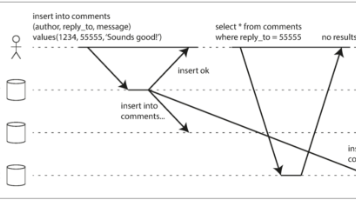
本文探讨了MySQL主从复制中的延时问题及其解决方案,以及读写分离场景下的读一致性挑战。主要内容包括:1. 主从延时原因分析:设备性能差异、从库负载过高、大事务执行等,并提出了提升从库复制性能的方法。2. 读写分离的读一致性问题:提出"读己所写"和"单调读"两种一致性要求,分别给出了读主库和基于binlog点位的解决方案。3. 基于ShardingJDBC的
Lua 是一种轻量小巧的脚本语言,用标准C语言编写并以源代码形式开放, 其设计目的是为了嵌入应用程序中,从而为应用程序提供灵活的扩展和定制功能。为什么要用Lua呢Redis采用单线程架构,可以保证单个命令的原子性,但是无法保证一组命令在高并发场景下的原子性。当 事务1执行删除操作时,查询到的锁值确实相等。在 事务1执行删除操作之前,锁的过期时间刚好到达,导致 Redis 自动释放了该锁。事务2获取

本文介绍了在阿里云新加坡机房手动搭建Kubernetes集群的过程。首先在2核4G的ECS上部署ControlPlane节点,安装kubelet/kubeadm/kubectl(v1.33.4)和containerd运行时。通过kubeadm初始化集群后,使用Cilium(1.18.1)作为CNI插件替代kube-proxy。随后扩展至3个ControlPlane节点,并部署阿里云NLB实现负载均

本文探讨了MySQL在Docker容器化环境中的主要挑战。首先指出容器与有状态的MySQL存在本质矛盾,随后详细分析了性能、数据持久化、资源管理、高可用、安全性和监控诊断等方面的问题。容器带来的I/O性能损耗、数据丢失风险、资源控制不精准等问题严重影响MySQL稳定性。虽然开发环境可以使用Docker部署MySQL,但生产环境建议采用传统物理机或Kubernetes StatefulSet方案,后

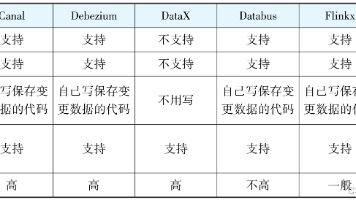
本文探讨了微服务架构中跨服务数据查询的优化方案。针对商品、订单、采购等服务间的数据依赖问题,作者分析了传统方案的三大痛点:查询性能低下、核心服务过载和依赖链雪崩。提出通过数据冗余存储商品信息来提升查询效率,并比较了同步调用更新和消息异步更新两种方案的优缺点。最终推荐采用基于Bifrost中间件的实时数据同步方案,将商品数据实时同步至下游服务数据库,实现本地化查询。该方案具有配置简单、维护成本低、对
Flink的Kafka Connector实现解析 摘要: 本文详细分析了Flink Kafka Connector的实现机制。该Connector采用三层架构:Metadata层处理表元数据,Planning层转换CatalogTable为DynamicTableSource/Sink,Runtime层实现与Kafka的交互。Source端通过ScanTableSource接口支持多种查询能力,

本文记录了在Windows系统搭配AMD显卡环境下成功编译ROCm版PyTorch并验证其性能的过程。通过构建一个经典的MNIST手写数字识别CNN模型,测试了ROCm环境下显卡识别、张量运算和模型训练等功能。实验采用包含卷积层和全连接层的简单CNN结构,相比传统全连接网络能更好地保留图像空间特征。测试结果显示,AMD Radeon RX6650XT显卡成功被识别,并在5.61秒内完成了500个b
做容器化部署时,单靠docker run命令逐个启动 MySQL、Redis、后端、Nginx 容器会非常繁琐 —— 不仅要记大量命令参数,还得手动控制容器启动顺序、配置网络联动,一旦服务器重启,所有容器要重新逐个启动,维护成本极高。是 Docker 官方的多容器编排工具,核心是通过一个配置文件,集中管理所有容器的等所有配置,能完美解决单容器部署的痛点。
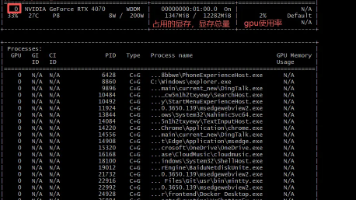
本文介绍了使用RTX 4070显卡和Ollama框架部署大语言模型的实践。主要内容包括:1)利用nvidia-smi工具监控GPU资源;2)通过Ollama部署Qwen3-8B对话模型和嵌入模型,实现按需加载和REST API调用;3)展示function calling功能,使LLM能调用外部工具获取实时数据。实验表明,RTX 4070能有效支持中小型模型的推理任务,显存占用约6GB,适用于交互
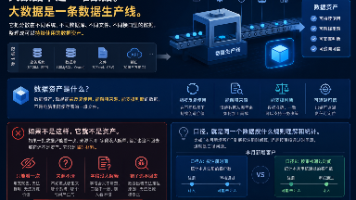
大数据不是简单的数据堆积,而是构建一条完整的数据生产线。其核心在于将分散的数据转化为可追溯、可解释、可复用的数据资产,而非仅关注数据量大小。真正的价值体现在数据采集、清洗、建模到服务业务的全流程管理,确保数据口径统一、来源清晰、质量可控。判断大数据是否落地的关键标准是:能否说清数据来源和含义,能否追溯原始数据,能否支撑业务决策。大数据建设应匹配业务复杂度,从基础的数据治理做起,逐步构建完整的数据服