


- @weixin_72100405


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
根据字母搭配出现的频率组成词根。初始vocabulary:["b", "g", "h", "n", "p", "s", "u"]然后计数字母搭配出现的频率,比如"hu"=10+5=15次,"ug"=10+5+5=20次,"un"=12+4=16次每次选取频率最高的搭配进行更新vocabulary,那么此时vocabulary:["b", "g", "h", "n", "p", "s", "u","
仅代表个人观点,因为都是凭借主观感觉的,并没有一个标准打分机制:rerank对query engine的提升还是有的,只不过要耗费多一点时间;但是对于chat engine来说还是不rerank比较好。refine知识库和SI知识库感觉差不多,但是对于chat engine来说可能SI更灵活更智能一点?其实各有千秋,挺难选择。
PS:`stats.norm.ppf`是SciPy库中的一个函数,用于计算正态分布的百分位点(也称为分位数)`stats.norm.ppf(q, loc=0, scale=1)`用于计算给定累积概率`q`下的正态分布的百分位点。函数返回的结果是给定累积概率下的对应百分位点的数值。PDF:概率密度函数(probability density function), 在数学中,连续型随机变量的概率密度函
从远程文件download,然后从本地文件夹打开文件,再运行。确认配置好SSH和编译器以及映射没错。那就是打开方式有问题。
⑧反向传播结果归到GPU0,由GPU0进行总计算,减小梯度,更新参数,再把更新后的模型重新复制三份到三个GPU。模型大小受限于单卡容量(第一张卡显存的85%左右大小的模型是比较合适的)假设一共有384张卡,每48张卡复制一个模型,那么数据可以分为8份【数据并行 n=8】ZeRO-3:对优化器状态、梯度、模型参数都进行分片(显存降低更多,但通信成本增加1.5倍)③每个模型对自己那部分数据前向传播。如
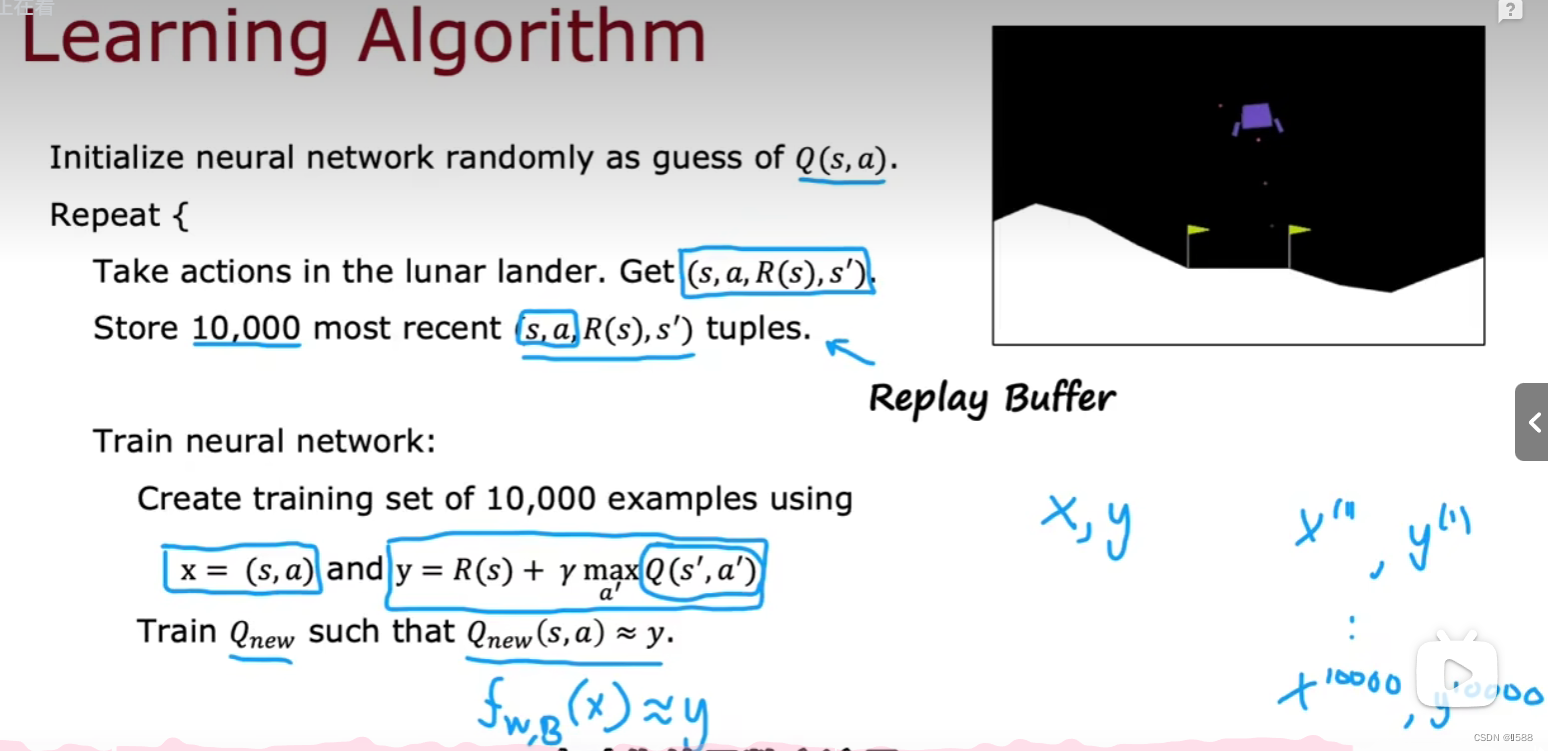
第一步是随机产生一个Q,用来得到作为trainingset的x和y,然后把x和对应的y输入到NN中。第三种:mini batch训练 减少训练时间 ——这个也可以作为普通NN的训练方法以减小训练时间。第一种:把输出层从一个神经元变成跟action个数一样的神经元数量。epsilon的尝试要从高开始逐渐降低,比如从1到0.01。
gradient_accumulation_steps(per_device_train_batch_size*gradient_accumulation_steps=计算梯度的数据数)gradient_checkpointing(前项激活值里面有很多是不需要存的,可以在反向传播再次计算的)per_device_train_batch_size(相当于batch size,越小显存占的越小)opt
部署服务的时候其他都跟旧的一样,只不过多加一个--task=classify。旧镜像需要更新vllm。
第一步是随机产生一个Q,用来得到作为trainingset的x和y,然后把x和对应的y输入到NN中。第三种:mini batch训练 减少训练时间 ——这个也可以作为普通NN的训练方法以减小训练时间。第一种:把输出层从一个神经元变成跟action个数一样的神经元数量。epsilon的尝试要从高开始逐渐降低,比如从1到0.01。
第一步是随机产生一个Q,用来得到作为trainingset的x和y,然后把x和对应的y输入到NN中。第三种:mini batch训练 减少训练时间 ——这个也可以作为普通NN的训练方法以减小训练时间。第一种:把输出层从一个神经元变成跟action个数一样的神经元数量。epsilon的尝试要从高开始逐渐降低,比如从1到0.01。