


- @weixin_56956615


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
所以,单调栈本质上不是为了“存储”,而是为了**“维护一种有序性”,从而实现O(1) 时间找到最近的极值**。相当于栈是一个 todolist,在循环的过程中,现在还不知道答案是多少,在后面的循环中会算出答案。一旦出现一个“矮个子”,它就会把前面所有“比它高的”全部杀掉,维护一个从矮到高的优良序列。单调栈解法,维护一个从栈底到栈顶高度递增的栈(因为每次都是踢掉高的,留下矮的)。单调栈:只保留**“
链表基础知识链表的类型链表的类型单链表双链表循环链表存储方式代码——链表的定义链表的操作删除结点添加结点性能分析链表的类型什么是链表,链表是一种通过指针串联在一起的线性结构,每一个节点是又两部分组成,一个是数据域一个是指针域(存放指向下一个节点的指针),最后一个节点的指针域指向null(空指针的意思)。链接的入口点称为列表的头结点也就是head。链表的类型单链表刚刚即是双链表单链表中的节点只能指向
7-51 两个有序链表序列的合并题目已知两个非降序链表序列S1与S2,设计函数构造出S1与S2合并后的新的非降序链表S3。输入格式:输入分两行,分别在每行给出由若干个正整数构成的非降序序列,用−1表示序列的结尾(−1不属于这个序列)。数字用空格间隔。输出格式:在一行中输出合并后新的非降序链表,数字间用空格分开,结尾不能有多余空格;若新链表为空,输出NULL。输入样例:1 3 5 -1 2 4 6
%% 独占一行的注释(有上下横线分割–可以用来分区)% 普通注释多行注释:选中,快捷键Ctrl+R取消多行注释:选中,快捷键Ctrl+T(1)(2) 分号也可以用于区分行。3.clear和clcclear:clear 关键字 —— 删除某个变量clear —— 删除工作区所有变量clc :清除命令行窗口中所有文本,让屏幕干净。输入:二、数据类型1.数字可以进行普通运算 加减乘除平方开方指数对数,具
之前可以使用穷举的方法逐个测试找使损失函数最小的点(即找最优权重),但权重过多时,会使穷举变得非常困难,因此需要优化,梯度下降法就是其中一种优化方式。要找到最小值的点,可以让点沿着下降最快的方向移动,梯度的负方向(即负的cost对w的导数)就是下降最快的方向,w随之更新。梯度下降并行度更好,时间复杂度低,但是性能较差。(实话讲这里没听懂老师说的原因,只知道结论了,先记录下来)图中公式的α值代表学习

在PyTorch中,torch.Tensor类是存储和变换数据的重要工具,相比于Numpy,Tensor提供GPU计算和自动求梯度等更多功能,在深度学习中,我们经常需要对函数求梯度(gradient)。里面包含两个比较重要的成员data(比如权重值)和grad(损失函数对权重的导数)有两个重要的成员,一个是data(保存权重w),一个是grad(保存损失函数对权重的导数)。对于简单的模型,梯度变换
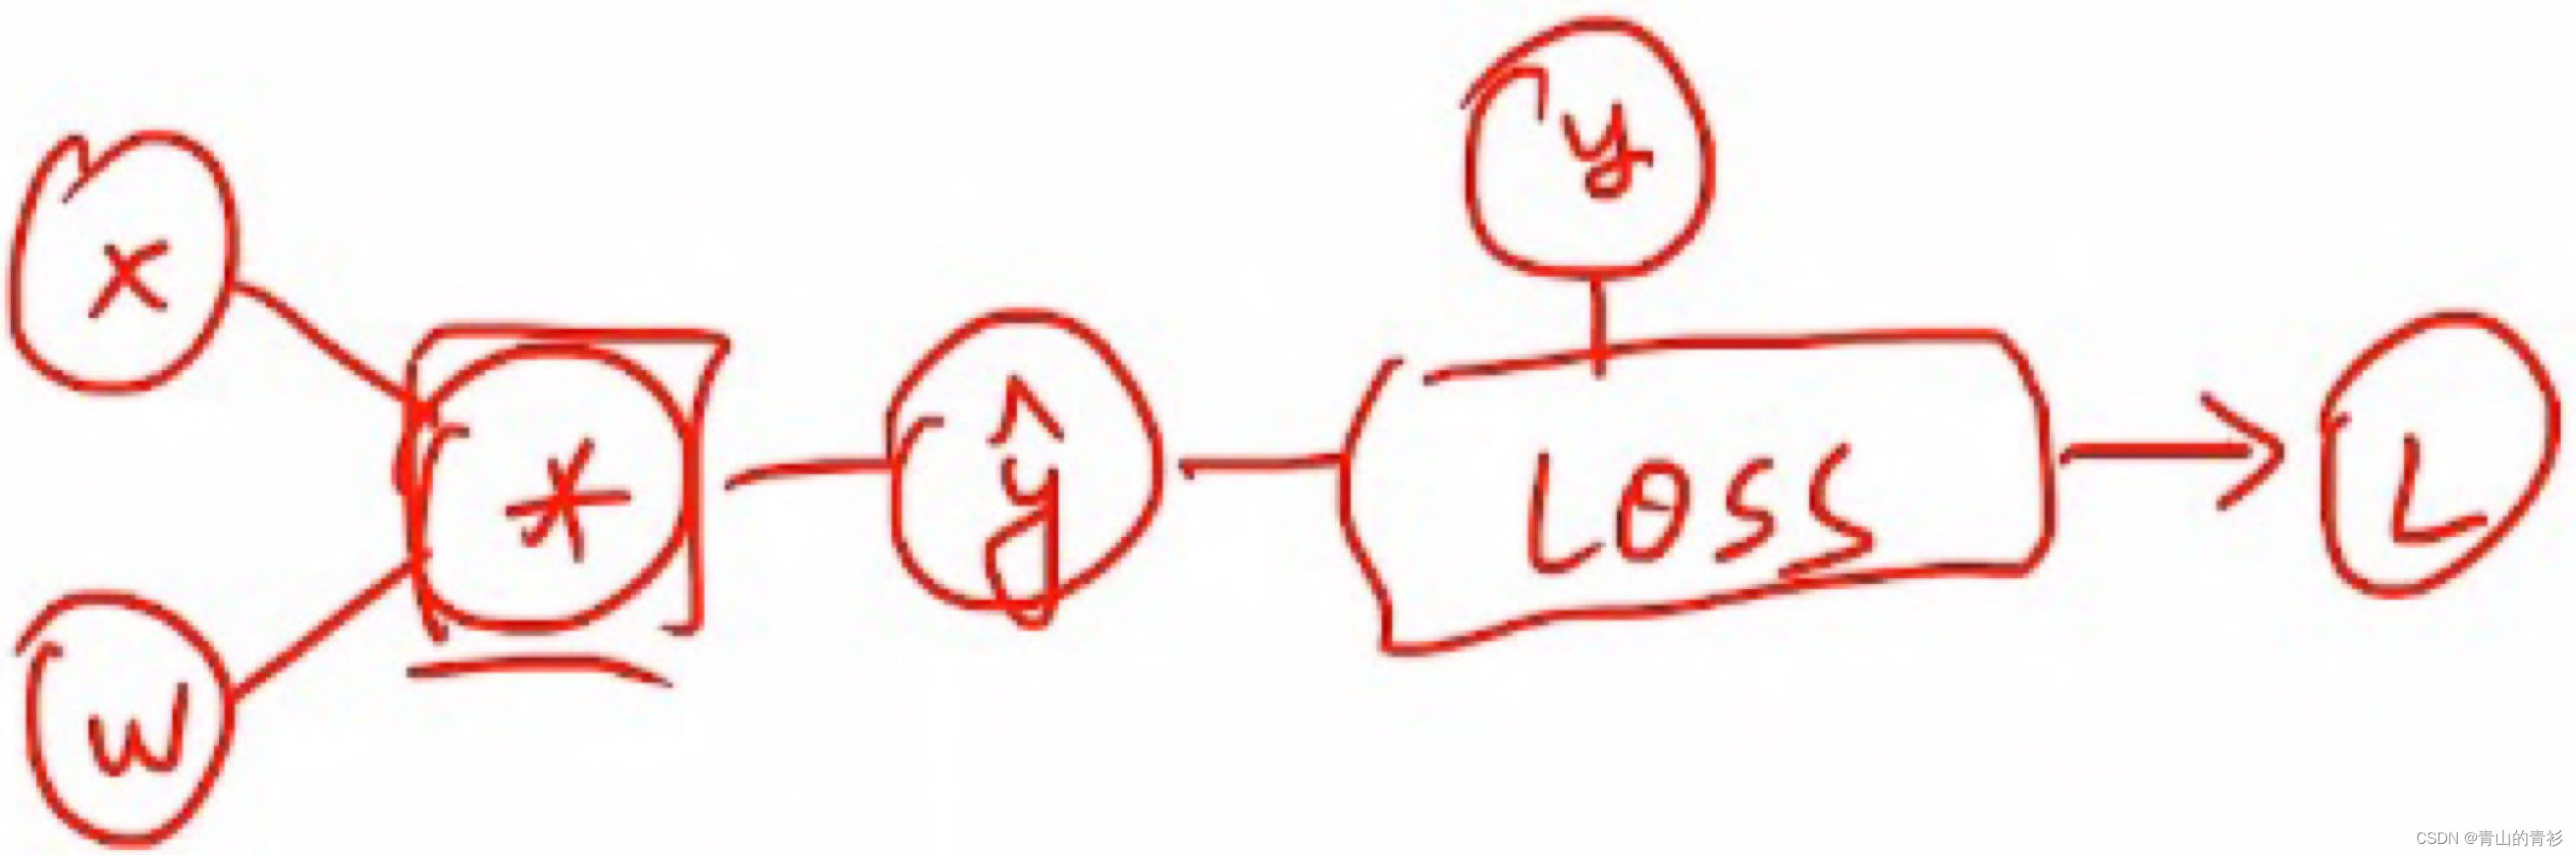
1.准备数据集 dataset和dataloader 2.设计模型 3.构造损失函数和优化器4.训练过程前馈(算损失)、反馈(算梯度)、更新(用梯度下降更新)
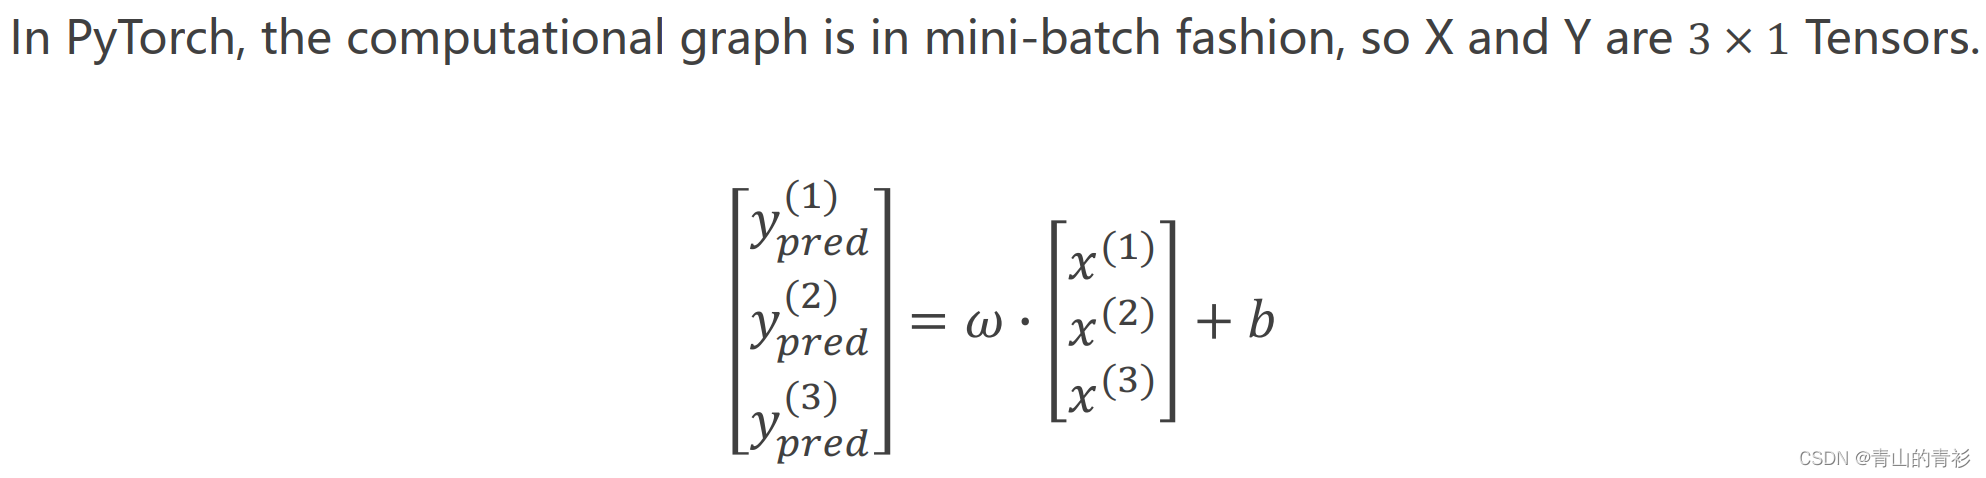
在PyTorch中,torch.Tensor类是存储和变换数据的重要工具,相比于Numpy,Tensor提供GPU计算和自动求梯度等更多功能,在深度学习中,我们经常需要对函数求梯度(gradient)。里面包含两个比较重要的成员data(比如权重值)和grad(损失函数对权重的导数)有两个重要的成员,一个是data(保存权重w),一个是grad(保存损失函数对权重的导数)。对于简单的模型,梯度变换
评价类问题,充分利用原始数据的信息,精确反应各个评价方案之间的差距。公式不唯一公式不唯一(但我也没想到更好的)不唯一不唯一,这只是前人论文中用的较多的一种标准化方法。未完待续…...
当需要多分类的时候,会输出一个分布,这些分布需要满足`P(y = i) >=0 和 所有的P值加起来=1`,使用softmax可以实现。