- @weixin_54227557


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
1、已准备了本地仓库gitTraining,并在master分支进行了三次提交:第一次提交:添加了helloGit1;第二次提交:添加了helloGit2;第三次提交:添加了helloGit3。现在发现,helloGit3内容有错误,需要撤销第三次提交,即将HEAD指向第二次提交。2、已准备了本地仓库gitTraining,并在master分支进行了三次提交:第一次提交:添加了helloGit1;
(2) Error when doing “import tensorflow.keras.utils.np_utils”. https://stackoverflow.com/questions/60218142/error-when-doing-import-tensorflow-keras-utils-np-utils 访问时间 2023/3/19.https://github.com/te
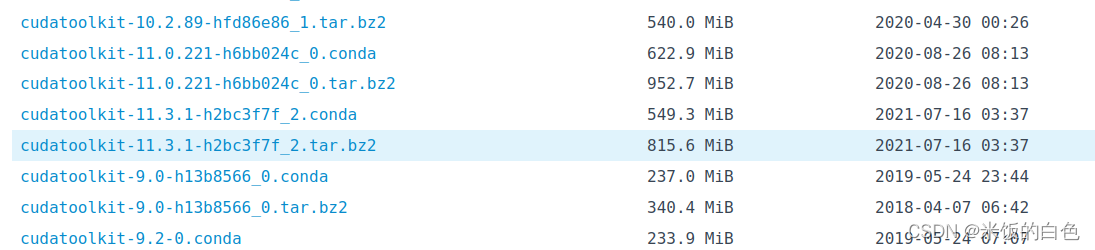
(2). 因为用的是清华的国内镜像, 所以到(因为此网页内容比较多, 所以加载很慢) 中查看是否有具体的 cuda 版本 (可以用 Ctrl F cuda 进行搜索), 也可以看到(3). 查看 cudnn 的版本, 所以也就确定了与 cuda11.3 相应的 cudnn 版本为 8.2.1确定好所需的各个版本之后就可以利用 conda 进行安装了。
当我在wsl2配置昇腾训练营的模拟器的时候,遇到了一个报错。我能够通过运行来拉取最新能用的包文件列表,通过运行来升级包,以上命令不会删除或者安装其他包。然而,当运行Debian指南有一些关于如何释放空间的提示,这是一个很好的开始,之后我必须进一步弄清楚到底是什么占用了/var中的全部空间。

3条都执行了,还有报错,看来layer有问题,明天解决一下。就可以体验jupyterlab环境了。prototype原型、最初形态。仔细看json文件,有不少怪异符号。benchmark基准检测。进入openvino专区。
参考:https://www.hiascend.com/document/detail/zh/CANNCommunityEdition/600alpha003/developmenttools/devtool/atlasprofiling_16_0090.html。【两个文件,各10分,共20分】通过profile对比,我们可以看到,耗时大的算子时间有了明显的减少,对比耗时情况,在语义相同的情况下
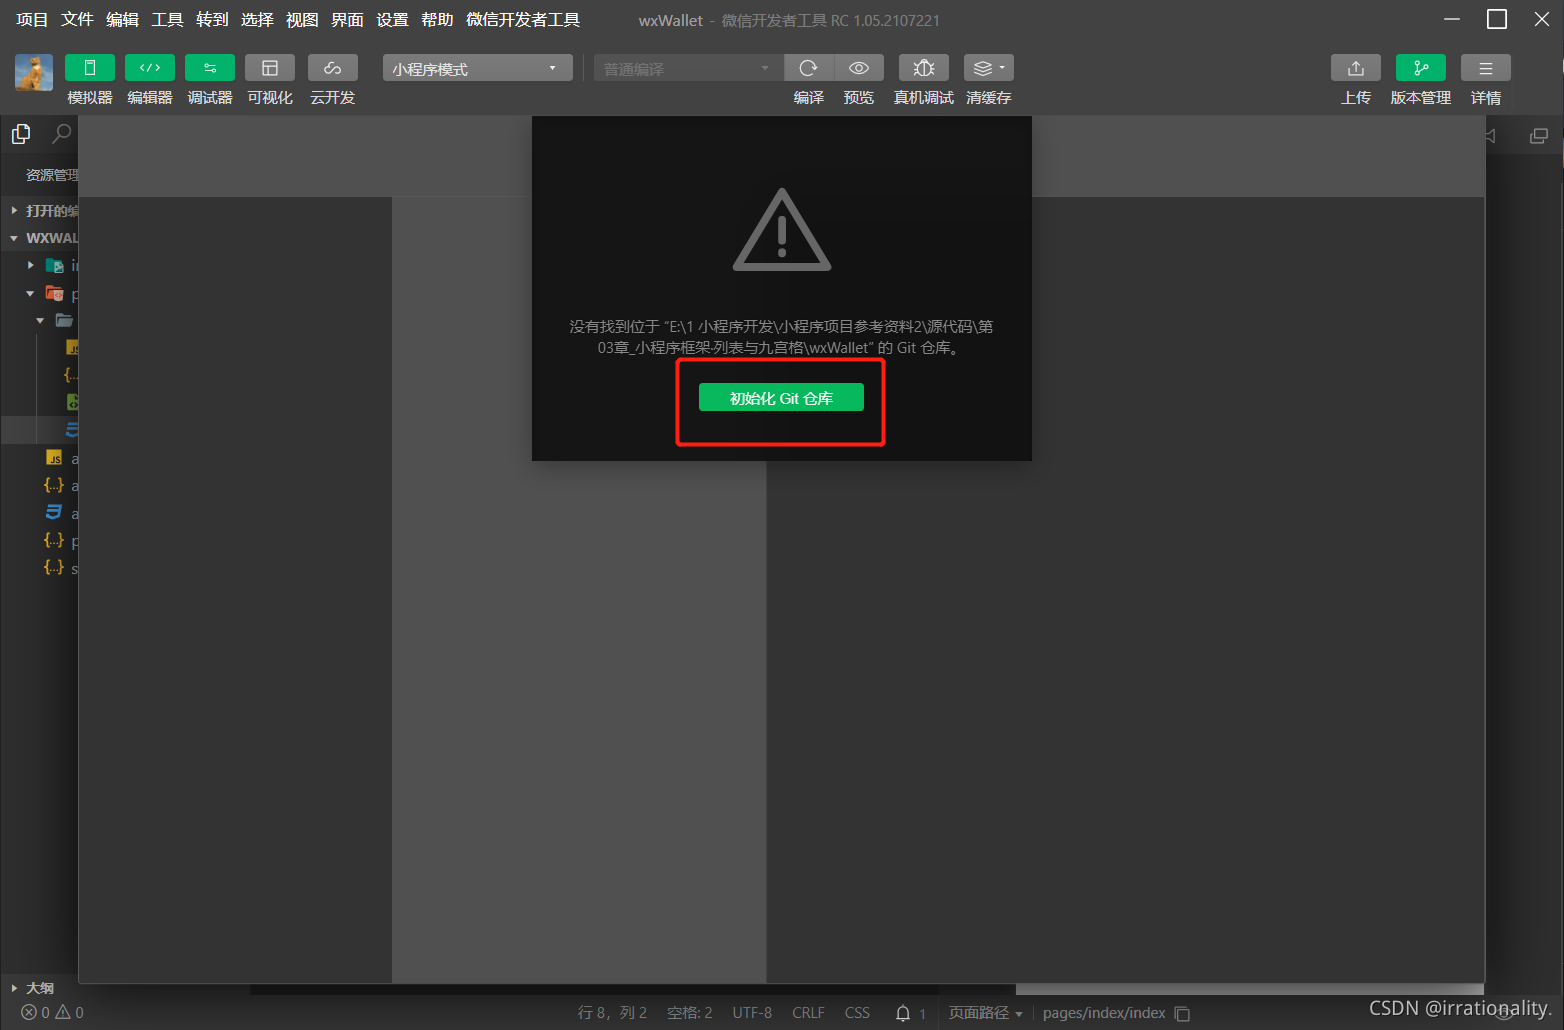
最近研究了一下微信小程序,感觉和vue思想几乎一致,自己也在写一些小Demo进行练习,但是考虑到需要进行版本控制,于是研究了一下将项目上传到github的步骤,网上也有很多其他博主写的相关文章,我也是踩了很多坑才成功,下面来和大家分享一下:Step1:点击开发工具右上角的版本控制按钮Step2:点击初始化仓库:等待初始化结束Step3:在github新建仓库:复制仓库地址:(HTTP)Step4:
大二下暑假的时候参加了中国科学院OSPP开源之夏活动,作品是在MindSpore开源代码仓提交一个PR,增加创建Tensor的方法。这是我第一次参加正式的开源活动,对开源的热情就此一发不可收拾。经过项目初次选拔后的两星期左右,我开始着手做本项目。由于之前对深度学习的了解仅限于构建网络进行训练和深度学习库的使用,很少接触深度学习框架一些底层代码的开发,中间也遇到了不少困难,但却能更好地体验开源世界带
题目:实现更丰富的数据预处理策略,穿插MindSpore预定义的数据增强API、以及自定义的python function操作。定义两个函数,一个是张量形状的推导函数(infer_shape),另一个是张量数据类型的推导函数(infer_dtype)。使用作业模板提供的测试代码测试基于上面函数的pyfunc类型自定义算子,并与MindSpore自带的Sin算子作为比较。题目:使用MindSpore
本项目中,我们使用MindSpore和GPT实现了情感分类模型,完成了IMDB数据集的加载、预处理、模型构建、训练和测试全过程。在单个epoch的训练过程中,我们达到了约90%的分类准确率。未来可以进一步尝试更复杂的预训练模型、多样化的超参数配置,以及更长的训练周期来提升模型性能。