


- @weixin_51702416


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
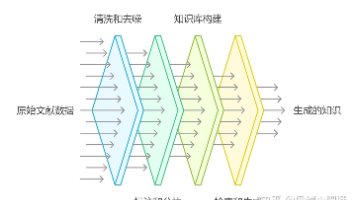
在生成式人工智能(Generative AI)快速发展的当下,大语言模型(LLMs)的幻觉问题始终是制约其落地应用的关键瓶颈。检索增强生成(RAG)技术通过引入外部知识库,将动态检索与生成能力结合,为解决这一难题提供了重要思路。然而,RAG系统的核心性能——数据召回率,高度依赖于底层数据的质量与组织形式。尤其是一些领域文献,原始数据常以非结构化形式(如PDF论文、扫描文档、图像表格)存在,且包含冗
使用ollama create命令创建自定义模型!
Redis持久化RDB快照(snapshot)在默认情况下, Redis 将内存数据库快照保存在名字为 dump.rdb 的二进制文件中。你可以对 Redis 进行设置, 让它在“ N 秒内数据集至少有 M 个改动”这一条件被满足时, 自动保存一次数据集。比如说, 以下设置会让 Redis 在满足“ 60 秒内有至少有 1000 个键被改动”这一条件时, 自动保存一次数据集:#save 60 10
前言“Tomcat是一个Servlet容器”,这句话对于JAVA程序员们应该都是耳熟能详。但是就这么单纯的这么一句话被阿里面试官嘴里问出来之后,你觉得还那么简单吗?好,单纯的思考一下这句话,我们可以抽象出来这么一段代码:class Tomcat {List<Servlet> sers;}但是如果Tomcat就长这样,那么它肯定是不能工作的,所以,Tomcat理论上其实是这样才对:cla
MCP(Model Context Protocol)是一种用于大语言模型与外部工具交互的协议框架。它允许大语言模型能够调用各种外部工具来扩展其能力边界,如访问文件系统、搜索引擎、数据库等。MCP的技术实现是一个多层次、多组件协作的过程,它通过标准化的协议实现了大语言模型与外部工具的无缝交互。通过Agentic Loop循环机制,系统能够支持复杂任务的递进式解决,而基于JSON-RPC 2.0协议
近春招和日常实习已开启。不同以往的是,当前职场已不再是那个双向奔赴时代了。求职者在变多,HC 在变少,岗位要求还更高了。最近,我们又陆续整理了很多大厂的面试题,帮助一些球友解惑答疑,分享技术面试中的那些弯弯绕绕。万万没想到啊,实习岗居然都这么卷,HR反馈当前岗位投递人较多,让耐心等待结果,竞争真的太激烈。所以说啊,无论是实习还是找工作,还是要提前做准备,越早越好啊,希望助力大家都能拿到心仪的off
本文介绍了如何使用Coze搭建热点监控智能体,帮助我们自动收集和分析抖音平台的热门视频数据。通过工作流实现自动化监控,该智能体能够每天定时采集指定关键词的热门视频,并将数据自动整理存储到飞书多维表格中,便于后续分析。这份《AI产品经理学习资料包》已经上传CSDN,还有完整版的大模型 AI 学习资料,朋友们如果需要可以在文末CSDN官方认证二维码免费领取【保证100%免费】资料包:CSDN大礼包:《
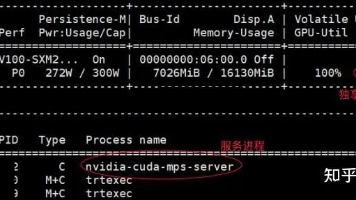
MPS(Multi-Process Service)是一种支持多任务模式的方法,它跟网络、框架(PyTorch/Tensorflow/others)无关,只跟任务数量以及硬件相关,由于尝试成本比较低,那就试一下吧,收获还不小,简单聊一点。至于能学习到多少就看你的学习毅力和能力了。没错,MPS 让利用率变低了,86%→53%,为什么会降低,结合上面对 GPU 利用率的解释不难理解,在共享模式下,由于
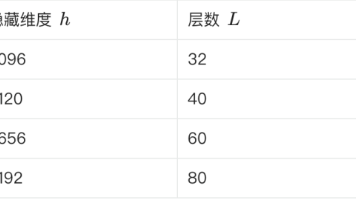
我们以 LLaMA-7B 为例,这个大模型参数量约为 70 亿,假设每个参数都是一个 fp32,即 4 个字节,总字节就是 280 亿字节,则 280 亿字节/1024/1024 = 26.7GB,当然这是原始的理论值,我们再往下看。具体增加多少其实不是很重要了,因为在模型权重文件里面,参数量 98% 的大头是权重数据,其他数据占比其实很少,我们从开源的 LLaMA-7B 的实际的存储结果来看,是
文章介绍了如何使用Qwen3-1.7b小模型结合猫娘问答数据集进行微调,以训练一个猫娘对话模型。作者首先提到在知乎上关于小参数模型作用的讨论,并决定尝试用Qwen3-1.7b模型进行实验。由于缺乏现成的猫娘问答数据集,作者通过修改现有数据集并利用大模型生成新的回答,最终制作了包含270条问答的数据集。接着,作者详细描述了代码实现过程,包括加载预训练模型、配置LoRA微调参数、处理数据集、定义训练器