- @weixin_48093827


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
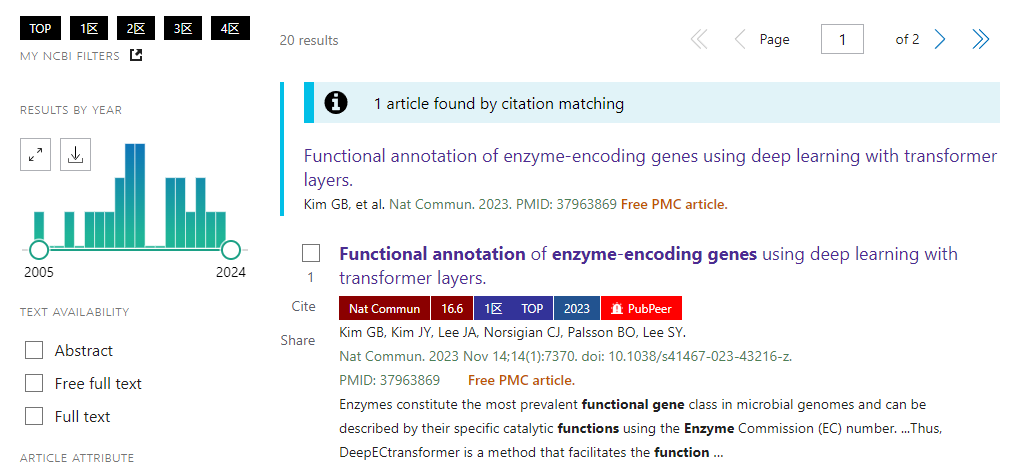
在使用进行文献检索时,没有使用任何插件的检索页面:在使用检索文献时,是否也曾被这样的困扰打断思路:文章虽多,却难以快速判断其质量?我们往往希望第一时间看到期刊的影响因子()、,甚至引用次数等关键信息,但默认界面并不显示这些指标。这使得从成百上千篇文献中筛选出高质量文章,变得既耗时又低效。
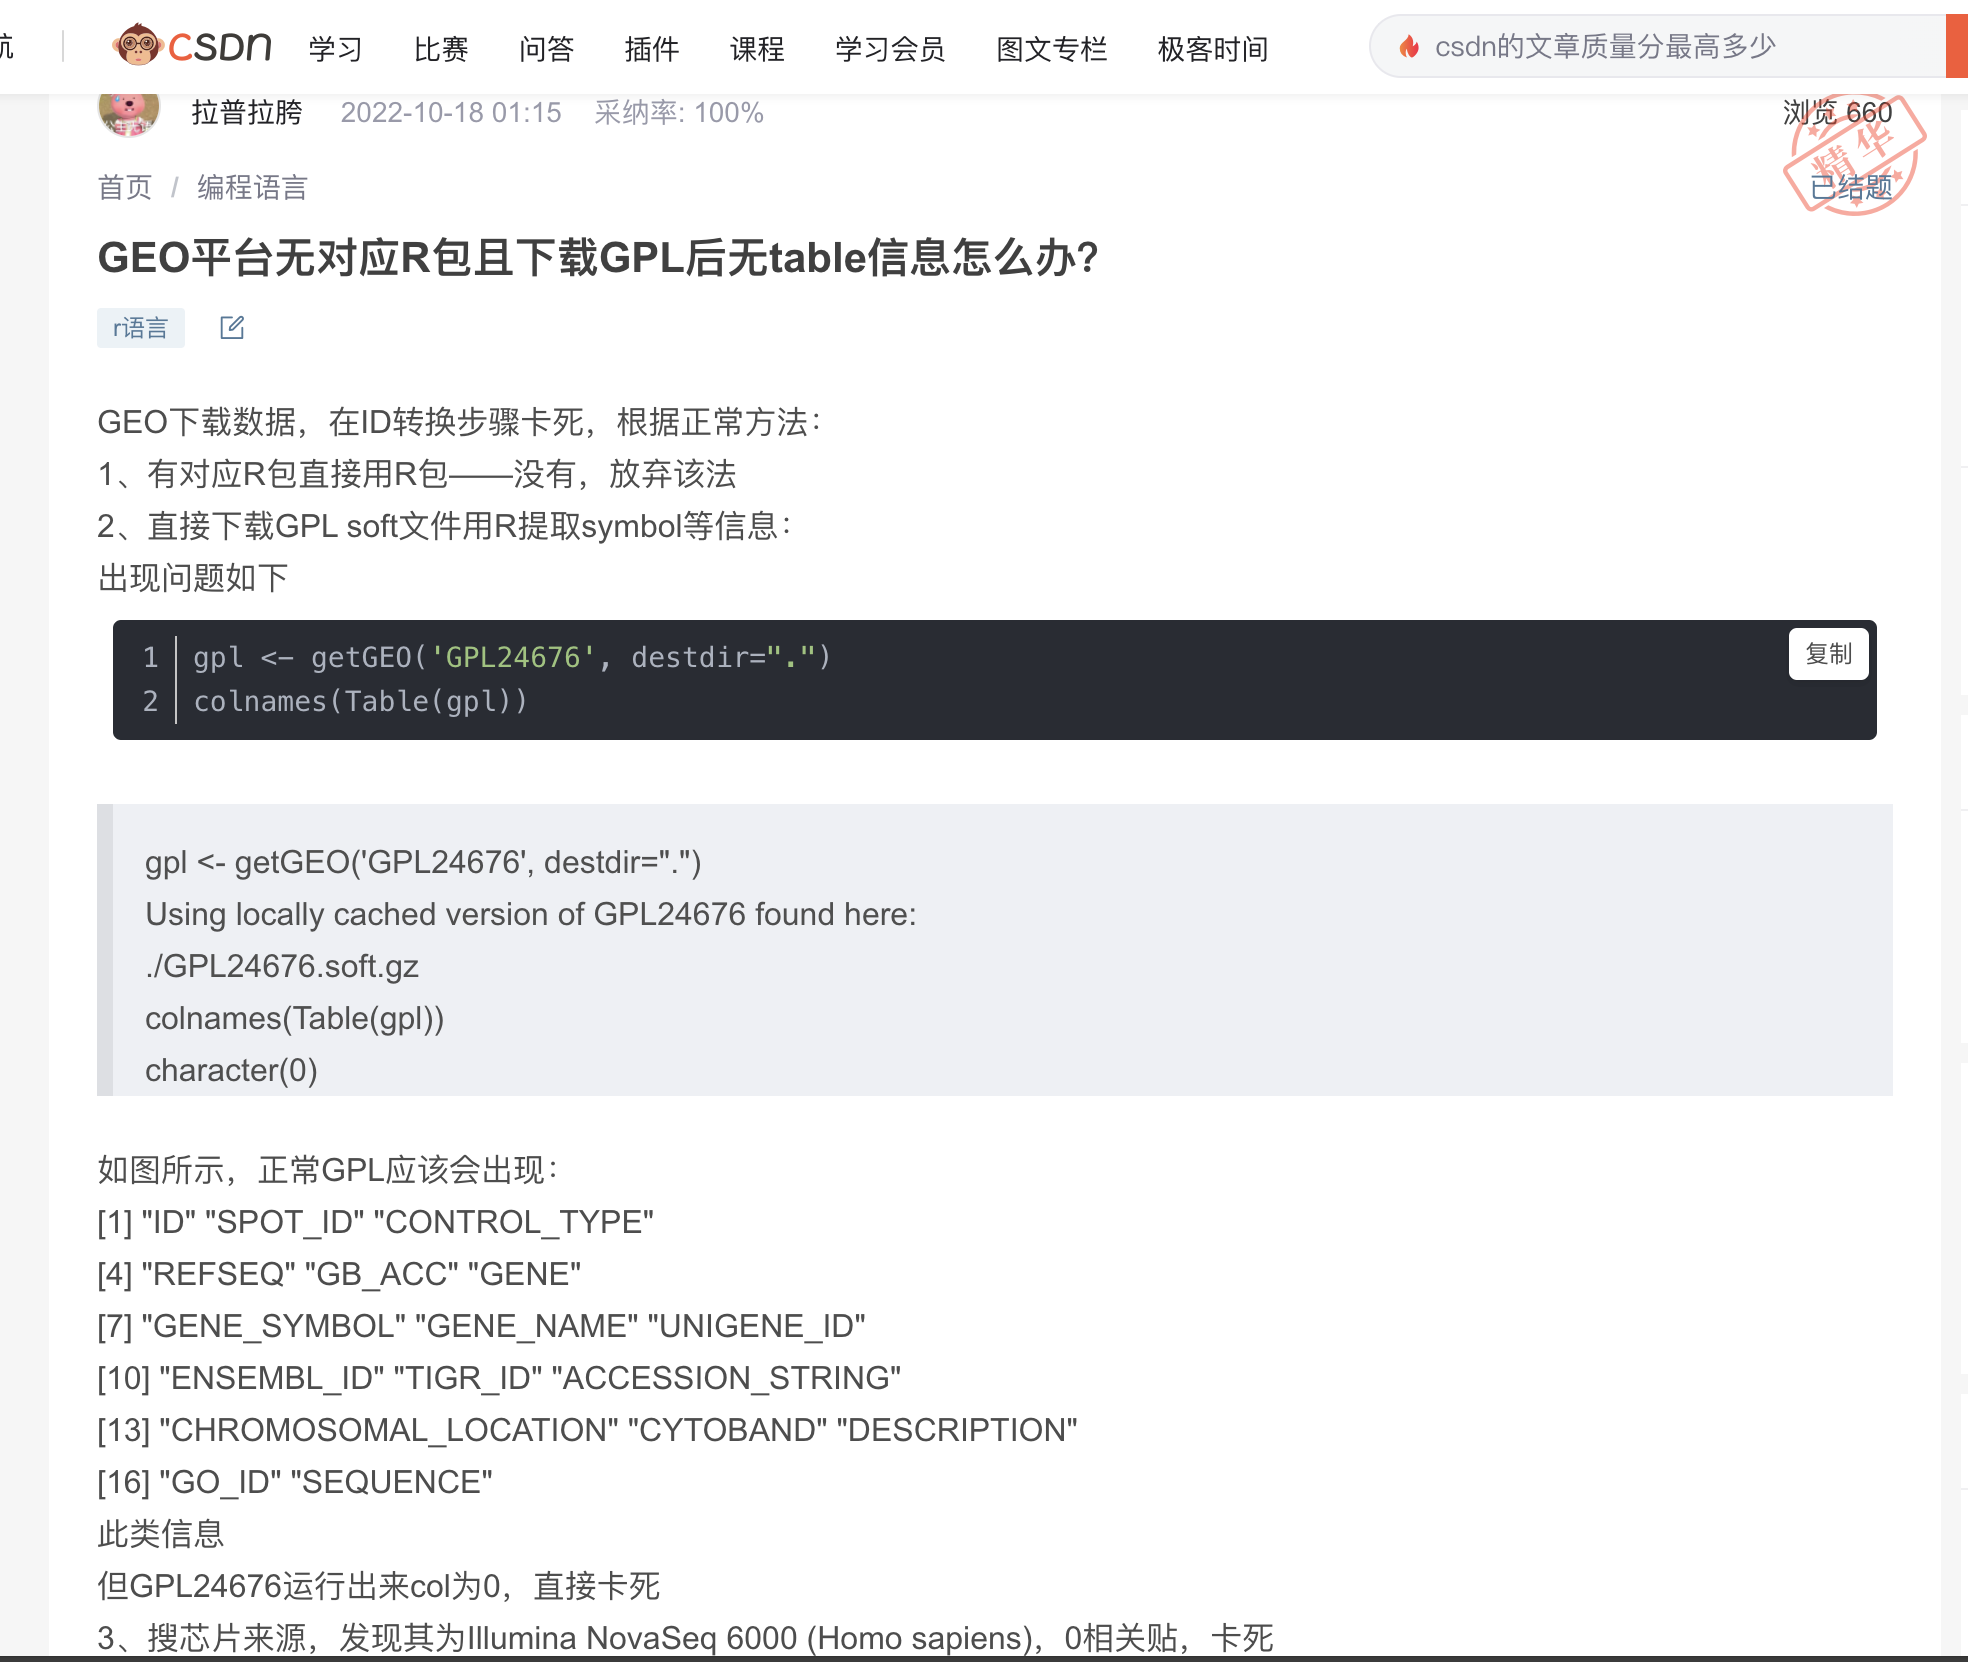
前因是小编在接近两年前回复了C站小伙伴一条帖子,这一年多来陆续有20几个问题,同样是问GPL没有基因注释文件怎么转换Symbol ID说实话我也不知道,如果是做大队列的话一般为了省事我直接换一个GSE,但如果这个数据集真的很好,含泪也要想办法去搞定。而且第一时间看到soft里无symbol或者GPL一般情况下,作者都会在补充文件上传已经注释好ID的表达矩阵,或者把注释文件,直接下载使用即可。第二般
思的一句话:如果你开始用鼠标做一些动作,停下来想想是否有捷径。
我们老百姓也没法挣扎,入门小白就开始细思极恐,大佬们更坐不住了(网络安全越接触越知道人外有人),提高安全意识是我们最后的倔强了
摘要 本文面向生物信息学初学者,强调系统学习的重要性,建议从基础概念入手而非急于求成。文章首先推荐使用在线分析工具(如GEPIA2、UALCAN等)快速获取结果,然后详细介绍了R语言与RStudio的关系及安装步骤。对于深入学习,文章讲解了R包的四种安装方式(CRAN、本地、Bioconductor、GitHub)及常用数据格式的读取方法。作者建议新手优先学习R语言,通过官方渠道获取稳定版本,并循
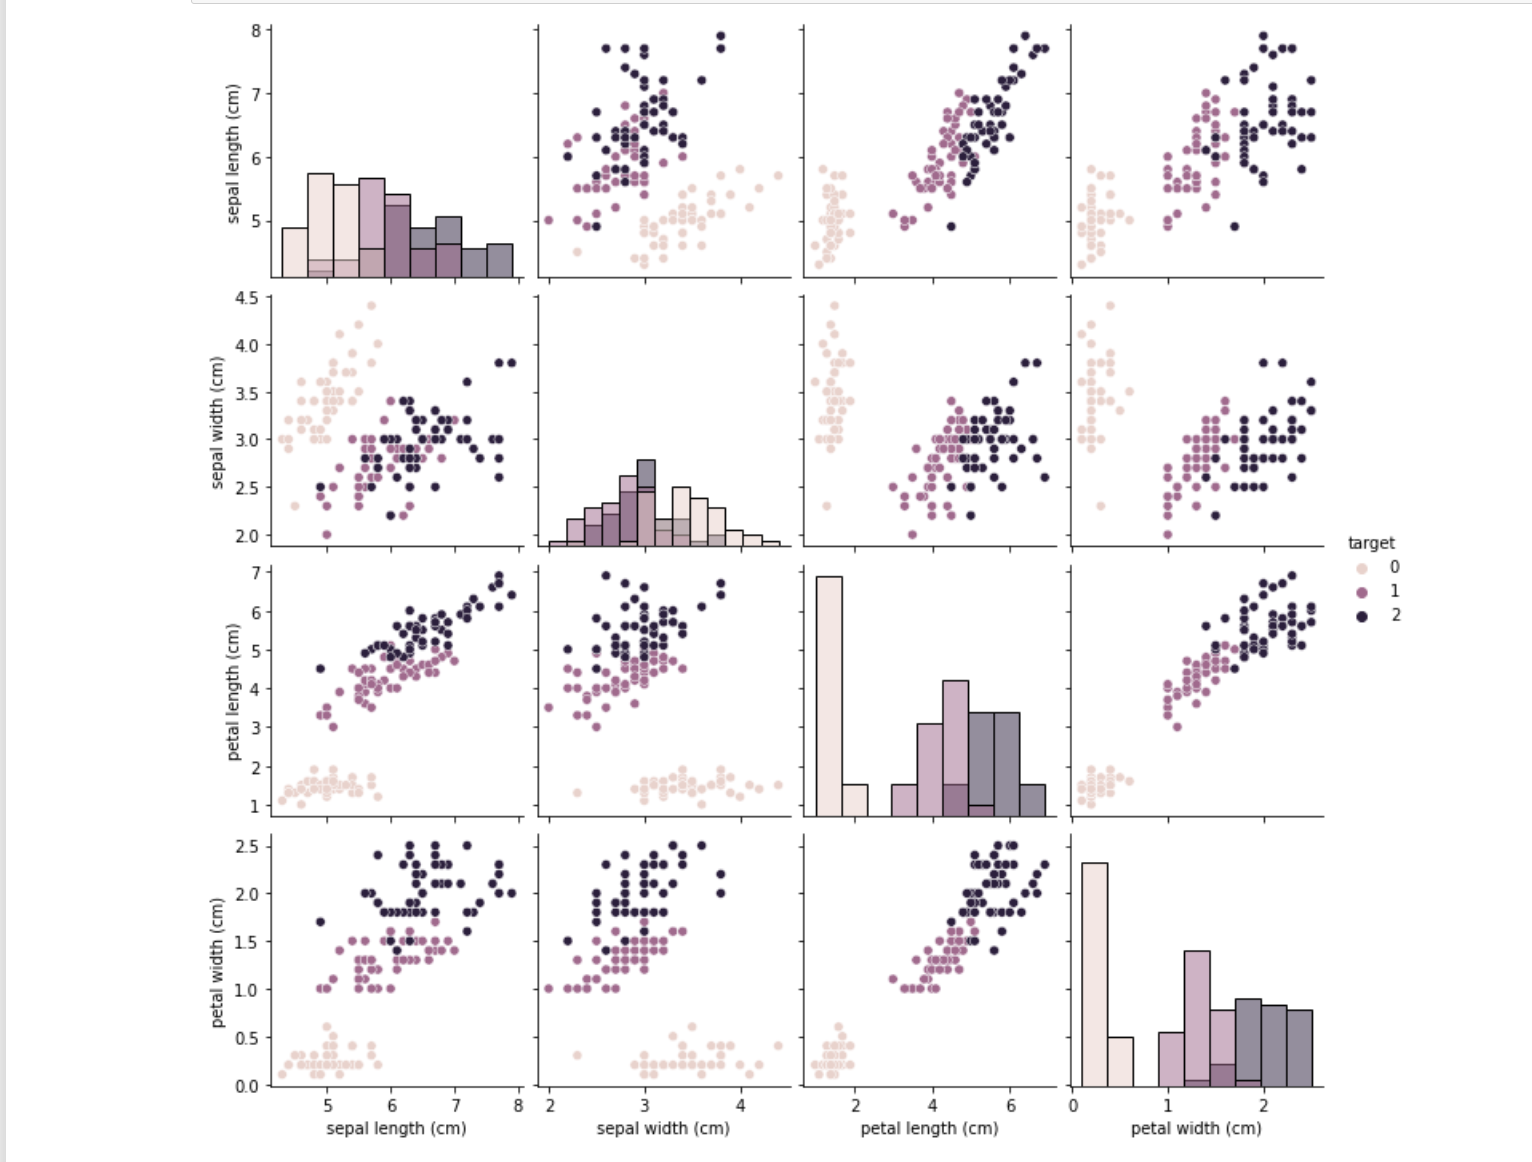
Logistic回归计算量小,训练速度快。输出结果易于理解。Logistic回归的输出结果是概率,易于解释。容易扩展。可用于多分类问题和不平衡数据集。只适用于线性可分的问题。
🚀 我做了一个小工具:LLMFetch一个面向本地大模型用户的终端工具,目标很简单:打开终端,就能快速知道这台机器适合跑什么模型。
本文介绍如何将Codex编程工具的前端工作流与DeepSeek V4的高性价比模型能力相结合。由于两者API接口不兼容(Codex使用Responses API,DeepSeek采用Chat Completions API),直接对接会导致请求失败。解决方案是在本地搭建轻量桥接服务,将Codex的请求转换为DeepSeek兼容格式,再反向转换响应数据。文章详细说明了环境准备、服务部署、配置文件修改
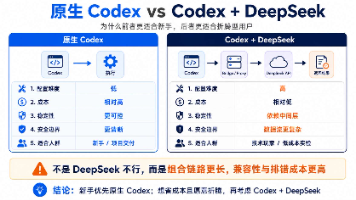
如果你确实要接 DeepSeek,再使用 Moon Bridge 或类似 bridge 工具。建议新建一个测试项目,不要拿公司主项目直接试。API key 单独管理,配置文件不要提交到 Git。先跑通原生 Codex,再折腾多模型接入,这是我给新手最重要的建议。Codex + DeepSeek 这套组合,本质上不是一个“错误方案”,而是一个“高级玩法”。DeepSeek 的模型能力、价格、cont
对比项普通论文总结核心目标读懂论文复用论文研究思路输出内容背景、方法、结果、结论研究问题、中心假设、方法主线、图表证据链、迁移规则使用方式一次性阅读生成 Skill 后反复调用是否适合换方向较弱强是否保留图表逻辑通常较少强调 Figure-by-Figure evidence chain是否关注方法迁移风险很少明确标出哪些能迁移、哪些不能迁移适合场景快速读文献学习文章套路、迁移课题设计、搭建论文框