- @weixin_46788581


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在Scaffold-GS的横向对比上,本文方法相比空地联合训练在保留测试集上PSNR提高了0.66 (NYC) 和0.59 (SF),视角平移与旋转时PSNR提高了0.47 (NYC)和 0.57 (SF) ,并且逆转了空地联合训练对SSIM与LPIPS的负面影响,全部指标甚至优于用高清航拍数据辅助训练的效果。为了利用无人机视角中的丰富信息来辅助地面数据的训练,我们首次将跨视角不确定性的概念融入3
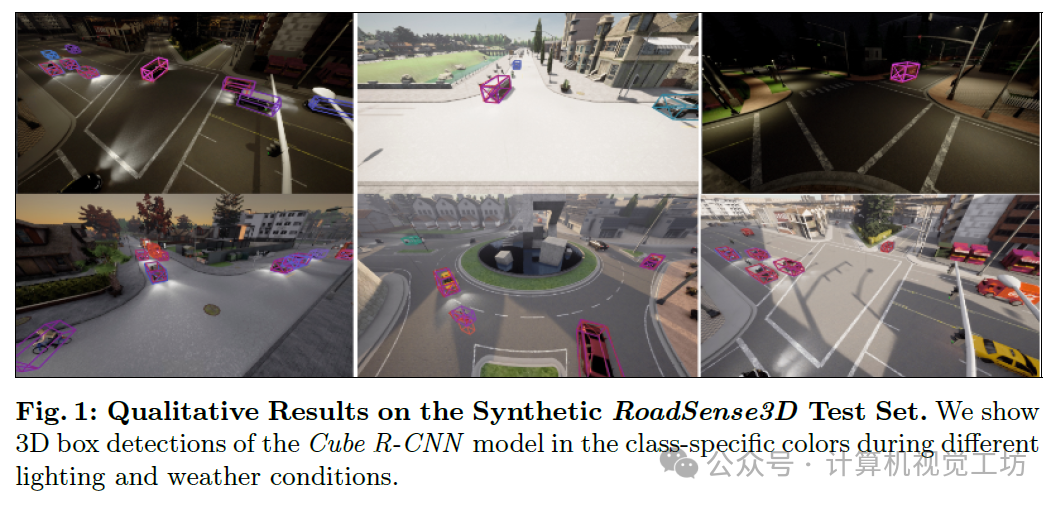
由于相机视角的变化和不可预测的场景条件,在动态路边场景中从单目图像中准确检测3D对象仍然是一个具有挑战性的问题。本文介绍了一个两阶段的培训策略来应对这些挑战。我们的方法首先在大规模合成数据集RoadSense3D上训练一个模型,该数据集为鲁棒的特征学习提供了一系列不同的场景。随后,我们在真实世界数据集的组合上微调该模型,以增强其对实际条件的适应性。

调整properties中dispaly range的数值,点云本身深度区间最佳。下图是用苏州三迪斯维智能科技有限公司的。重建的硬币,本教程将用此素材做演示。将点云的颜色按照深度范围筛选后显示。演示素材已放至知识星球,需要自取。一 根据坐标系对点云着色。来源:计算机视觉工坊。
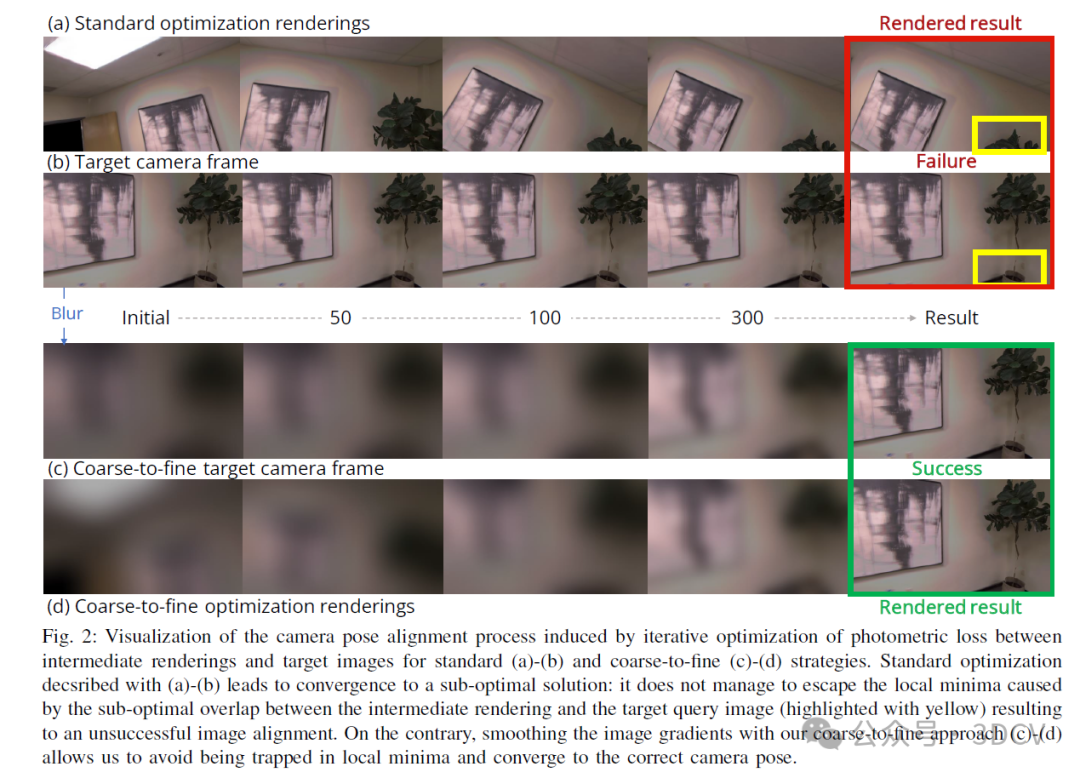
我们提出了一种名为GSLoc的新型视觉定位技术,该技术基于三维高斯溅射环境图表示。我们在合成数据和真实数据上都已证明,该方法能够实现精确的相机位姿估计。我们通过对各种相机初始化和参数化的全面收敛性分析,验证了这一点。我们深入探讨了由于光度损失的非凸性导致的收敛局限性,并提出了一种由粗到精的策略来缓解这一问题。最后,我们提出了一种有效的方法,通过改进GSLoc的相机初始化来提升定位结果,该初始化是通
我们提出了Hi-SLAM,一种语义3D高斯Splatting SLAM方法,其特征在于一种新颖的分层分类表示,该方法能够在3D世界中实现精确的全局3D语义映射、放大能力和显式语义标签预测。语义SLAM系统中的参数使用随着环境复杂性的增加而显著增加,使得场景理解特别具有挑战性并且成本高。为了解决这个问题,我们引入了一种新的分层表示法,它利用大型语言模型(LLM)的能力,以紧凑的形式将语义信息编码到3

“手”即机器人,“眼”即3D相机,手眼标定是校准“手”与“眼”之间的空间关系,即确定相机坐标系与机器人末端坐标系之间的刚性变换矩阵(包含旋转和平移),以便将视觉信息准确转化为机器人动作,从而实现准确的视觉引导抓取放置。眼在手上(EyeInHand):相机固定安装在机械臂的末端工具上,随着机械臂的运动而运动,相机相对于机器人末端法兰是固定的,标定板相对于机器人基座是固定的。相机固定安装在机械臂的末端
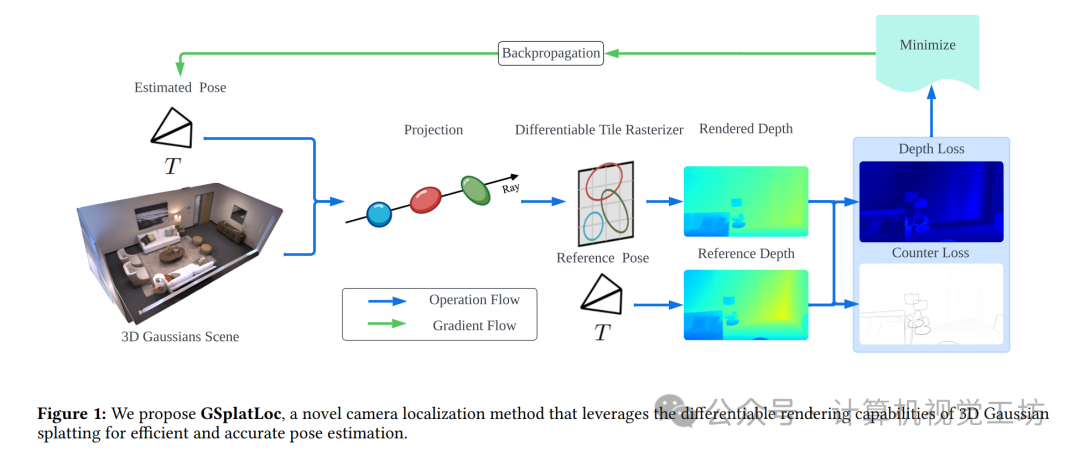
在本文中,我们介绍了GSplatLoc,这是一种利用3D高斯溅射(splatting)的可微分渲染能力实现超精确相机定位的新方法。通过将位姿估计公式化为一个完全可微分框架内的基于梯度的优化问题,我们的方法实现了从预存在的3D高斯场景中渲染的深度图与观测到的深度图像之间的高效准确对齐。在Replica和TUM RGB-D数据集[39]上进行的广泛实验表明,GSplatLoc在平移和旋转精度方面均显著
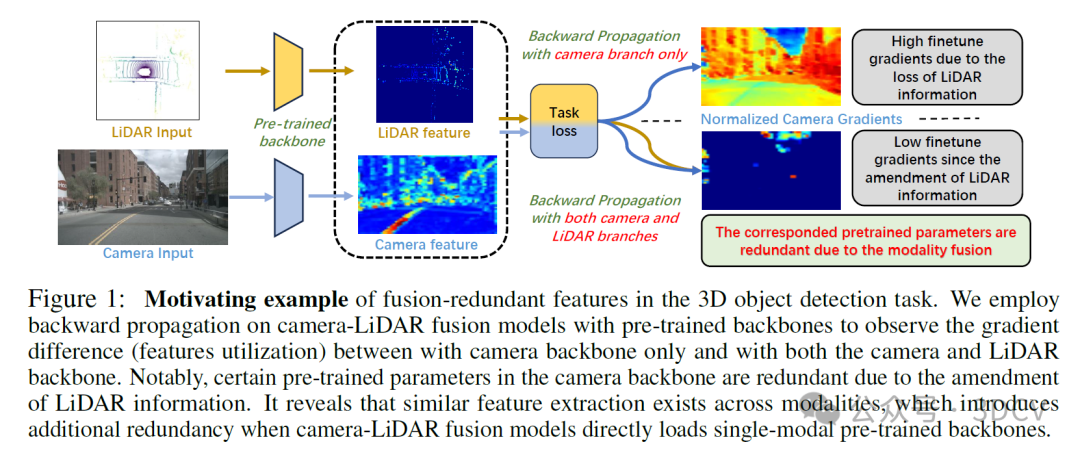
相机-激光雷达融合模型显著增强了自动驾驶中的感知性能。融合机制利用了每种模式的优势,同时最大限度地减少了它们的缺点。此外,在实践中,相机-激光雷达融合模型利用预先训练的主干进行有效训练。然而,我们认为,由于融合机制的性质,直接将单模态预训练相机和激光雷达主干加载到相机-激光雷达融合模型中会引入跨模态的相似特征冗余。不幸的是,现有的剪枝方法是针对单模态模型开发的,因此,它们难以有效地识别相机-激光雷
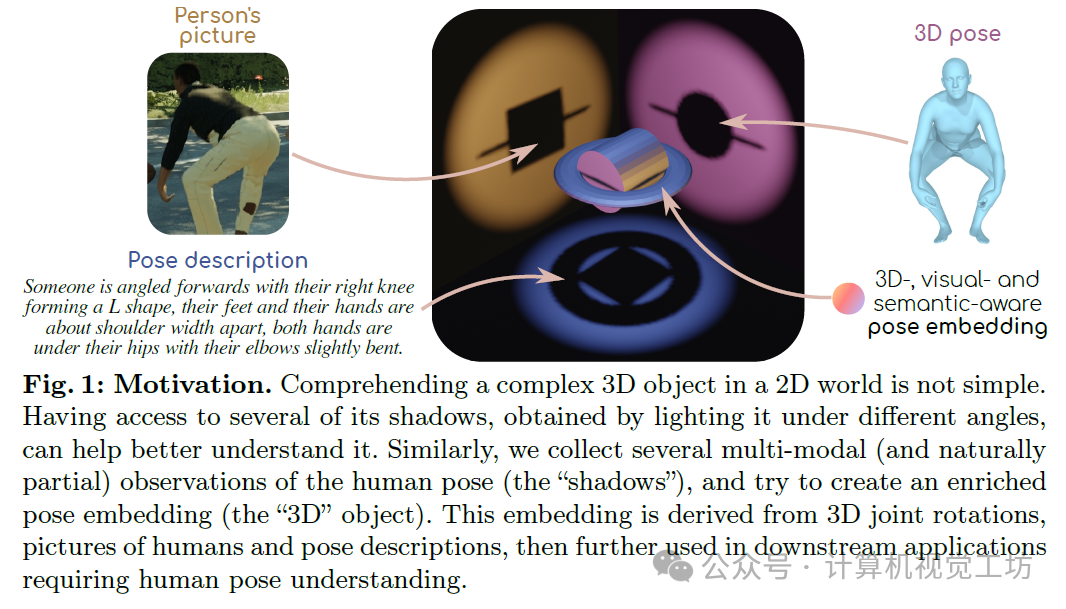
在潜在空间中排列多种形式,如图像和文本,已显示出产生强大的语义视觉表示,为图像字幕、文本到图像生成或图像基础等任务提供动力。在以人为中心的视觉环境中,尽管类似剪辑的表示相对较好地编码了大多数标准的人类姿势(如站立或坐着),但它们缺乏足够的敏锐度来辨别详细或不常见的姿势。实际上,虽然3D人体姿态经常与图像相关联(例如,执行姿态估计或姿态条件图像生成),或者最近与文本相关联(例如,用于文本到姿态生成)