


- @weixin_45937224


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Failed to execute goal org.scala-tools:maven-scala-plugin:2.15.2:compile (default) on project graduation: wrap: org.apache.commons.exec.ExecuteException: Process exited with an error: 1(Exit value: 1)
最近在尝试flinkCDC3.0的pipeline功能同步数据至doris以备实时数仓的开发,总结几点,新功能很方便,通过配置文件的方式可以采集多个表,不用单独写一个一个的flinkSQL配置,而且可以动态监控表创建、字段变更、数据变更等,非常的方便。美中不足的是目前不支持application方式提交,且检查点重启配置,任务执行日志监控等相对于比较的模糊。2、找到flink-cdc-connec

解决idea本地使用sparkSQL操作hdfs文件load命令不生效的情况,并对hive表库进行操作
1.final是修饰符关键字,用来修饰类,属性和方法修饰类的时候表示这个类不能被继承;修饰属性的时候表示这个属性不能被修改,且必须要有初始值,被引用时也不能被修改,即常量;修饰方法时表示该方法不能被重写。2.finally是try..catch方法中最终需要执行的代码块标识,这就意味着程序无论正常执行还是发生异常,这里的代码只要JVM不关闭都能执行,可以将释放外部资源的代码写在finally块中3
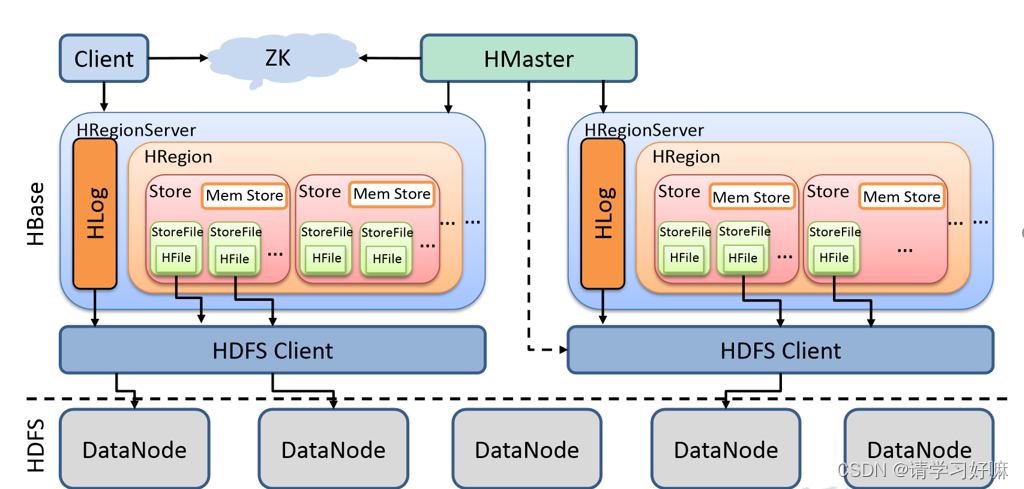
HBase整个架构与大数据学习生态圈一样以hadoop的HDFS文件系统为基底,通过zookeeper集群的协调建立.而集群又有自己的HMaster和HRegionServer.通过三个框架协调架构运行.1.hadoop Datanode存储region server所管理的真实的数据,如果是虚拟机集群,则真实存在集群磁盘里面.所有的hbase数据都存在hdfs中.而hadoop的NameNode
☆:节点一到节点五的myid分别是1,2,3,4,5zookeeper对leader的选举往往分为两个方面,细分的话可以分为三个方面第一个是zookeeper集群第一次启动,另一种是非第一次启动,而非第一次启动又分为leader存活状态和非存活状态。一、第一次启动选举zookeeper特点是,只要节点有半数以上存活就能正常工作,因此其选举机制达到半数就能选出leader。选取机制:1.当第一台节点