


- @weixin_44041700


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
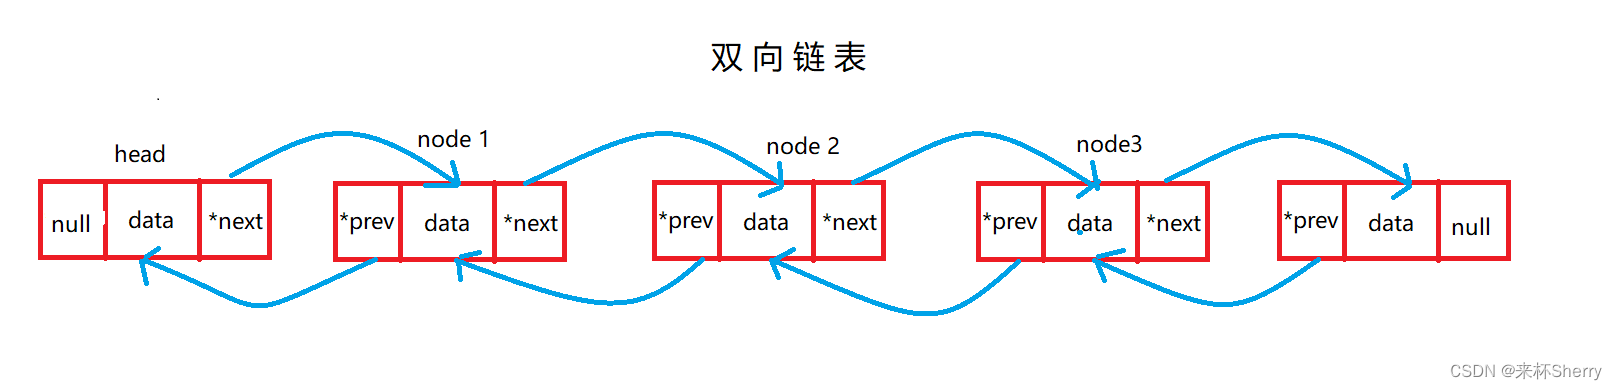
假设2个任意长度的整数x、y分别用链表A和B存储,现要求设计一个算法,实现x+y。计算结果存储在链表C中。链表A、B、C可以是单向链表或双向链表,但由于A和B输出时需要从头至尾遍历,而做加法时需要从尾至头遍历,因此推荐使用双向链表存储。链表的每个结点的数据域可以选择以下三种设计方式:(1)链表的每个结点存储长整数的一位(不推荐);(2)链表的每个结点从长整数的低位开始拆分(4位为一组,存到一个结点
\1.下载地址https://flink.apache.orgor直接找tgzhttps://www.apache.org/dyn/closer.lua/flink/flink-1.11.2/flink-1.11.2-bin-scala_2.11.tgz\2.解压到/usr/flink下\3.启动/usr/flink/bin$ ./start-cluster.sh\4.jps查看9330 Stan
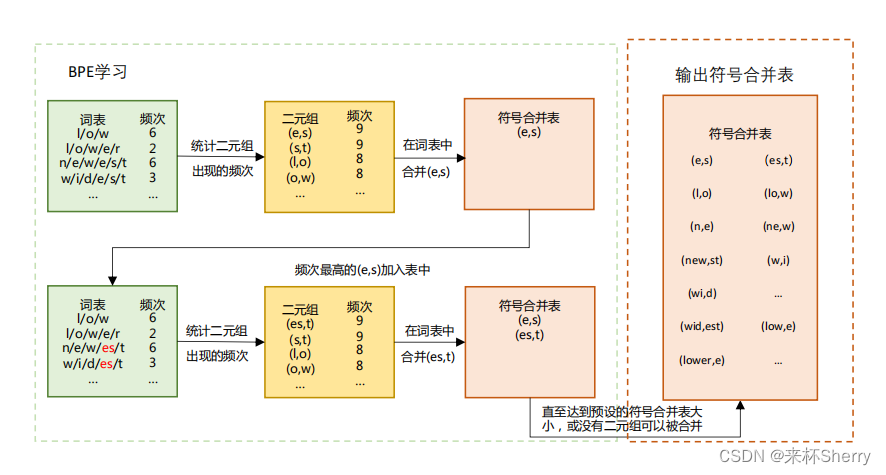
"语料库的似然性"通常是指一个特定文本序列(通常是一段文本或一个句子)在语料库中出现的概率。统计每个相邻字节对的出现频率,合并出现频率最高的字节对,将其作为 新的词元加入词表。构建词元表:覆盖绝大部分的输入词,并避免词表过大所造成的数据稀疏问题。输入词序列全词切分,对照词表按词元从长到短顺序遍历匹配。合成全词时,词元表示失败部分视作未登录词,赋予相同表示。2. 全词切分为词元以及词元合并为全词的方
加入一个或多个隐藏层+激活函数来克服线性模型的限制, 使其能处理更普遍的函数关系类型,这种架构通常称为*多层感知机*(multilayer perceptron)。

的各种矛盾回答搞晕了,奇异值分解的博客很少提到σ的排列问题,浪费了很多时间,最终在周志华的《机器学习》附录中找到了准确描述。矩阵分解的本质是将原本复杂的矩阵分解成对应的几个简单矩阵的乘积的形式。这种情况下,如果我们想通过矩阵分解的形式将原本比较复杂的矩阵问题分解成比较简单的矩阵相乘的形式,会对其进行。其中,U是一个m x m的正交矩阵,Σ 是一个m x n的矩阵,其对角线上的元素称为奇异值,若A可
检查你的cookie重写你的formdata、和headers
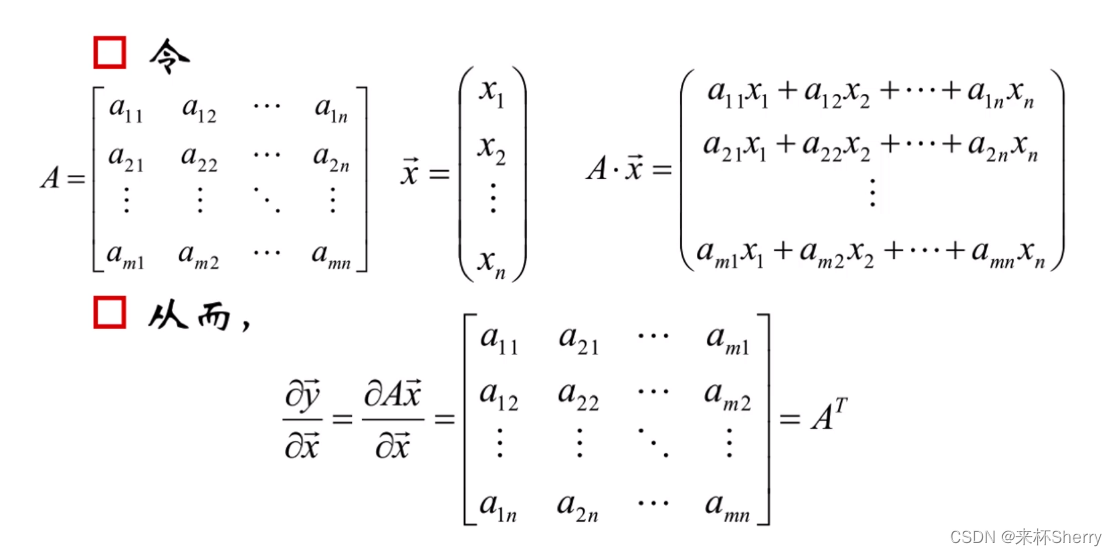
重点是梯度下降法,利用一阶导数,而二阶导数涉及到海森矩阵,具有较大的计算量,因此,往往采用梯度下降算法。

介绍:我们采用波士顿房价预测数据集进行回归任务分析。数据集分为训练集和测试集,训练集可用于训练回归模型,测试集需要进行预测。要求:1.做linear regression,或使用现成的线性回归函数,方法尝试使用Gradient Descent,SGD 以及 ADAM。2.比较不同learning rate的结果。例如损失函数曲线图3.比较有无加上regularization的结果。4.比较有无否使

比如,如果使用随机拆分数据的方式进行验证,因为随机拆分数据的时候存在不随机的情况,所以就会对验证效果产生影响。它是机器学习中唯一一个不需要训练过程的算法,它在训练阶段只是把数据保存下来,训练时间开销为 0,等收到测试样本后进行处理。KNN用于回归问题时,模型从训练数据集中选择离该数据点最近的k个数据点,并且把这些数据的y值取均值,未知点的判断基于已知点的距离,选出最近的K个点,投票选出未知点的最大

一早起来,发现remote-ssh无法进入服务器容器,本地使用git bash进行ssh可正常连接服务器,基本确定是vscode工具本身的问题。重装本地用户的.vscode相关目录清空,vscode重装均无果,不建议尝试。弹窗信息为,连接日志中出现具体错误信息字眼。
