


- @weixin_41446370


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
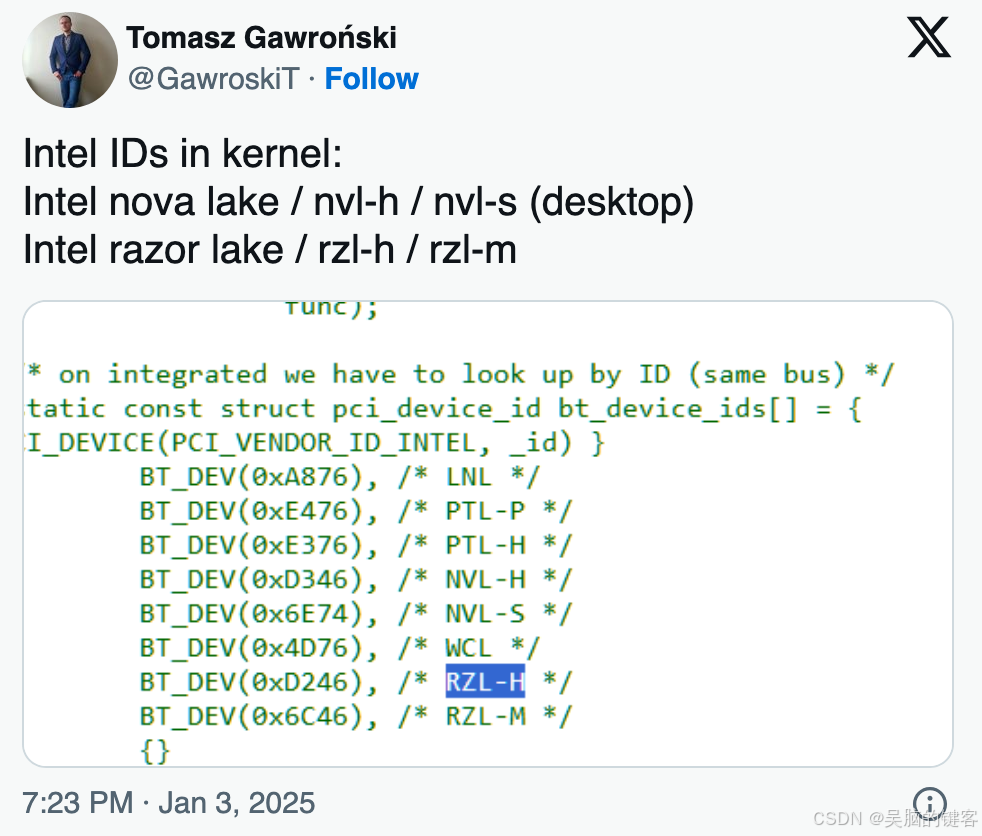
至于 Razer Lake,在之前的报告中,我们讨论了Razer Lake-S 将如何接替 Nova Lake-S,而至于具体细节,除了该系列将拥有 S、M 和 H 系列 SKU 之外,我们目前对该阵容还一无所知。目前,围绕上述 CPU 产品线的细节还很有限,但根据之前的传言,英特尔的 Nova Lake 将是 Arrow Lake-S 系列的真正继任者,应该属于"酷睿 Ultra 400"系列,
是一个开放的、可重现的代码 LLM 系列,包括 1.5B 和 8B 基本模型和聊天模型,支持中英文两种语言。从零开始,OpenCoder 在由 90% 的原始代码和 10% 的代码相关网络数据组成的 2.5 万亿个标记上进行预训练,并在超过 450 万个高质量 SFT 示例上进行监督微调,最终达到顶级代码 LLM 的性能。我们不仅提供模型权重和推理代码,还提供可重现的训练数据、完整的数据处理管道、

Genmo 是一家专注于视频生成的人工智能公司,该公司宣布发布 Mochi 1 的研究预览版。Mochi 1 是一种新的开源模型,可根据文本提示生成高质量视频,其性能可与 Runway 的 Gen-3 Alpha、Luma AI 的 Dream Machine、Kuaishou 的 Kling、Minimax 的 Hailuo 等领先的闭源/专有竞争对手媲美,甚至超过它们。

本周四,人工智能托管平台Hugging Face的人工智能模型列表首次突破100 万个,这标志着快速扩张的机器学习领域的一个里程碑。人工智能模型是一种计算机程序(通常使用神经网络),通过数据训练来执行特定任务或进行预测。该平台在2016年以聊天机器人应用程序起步,在2020年转向成为人工智能模型的开源中心,现在为开发人员和研究人员提供了大量工具。机器学习领域所代表的世界远不止像 ChatGPT 这

Nvidia 将此与蒸馏技术和剪枝技术相结合,确保重新训练的 4B 模型性能优异,并在更大的模型中得到很好的应用。Llama-3.1-Minitron 4B 模型将成为 Nvidia 的 "Hugging Face "系列的一部分,并为不断变化的强大、免费的人工智能模型格局添砖加瓦。在大多数领域,它的性能都远远超过许多其他小型语言模型,如 Minitron 4B、Phi-2 2.7B、Gemma2

Black Forest Labs 发布了三种 FLUX.1 文本到图像模型:高端商业 "pro "版、非商业使用的中端开放权重 "dev "版和更快的开放权重 "schnell "版("schnell "在德语中意为快速)。Black Forest Labs 声称,其模型在图像质量和文本提示的遵从性等方面优于 Midjourney 和 DALL-E 等现有选择。

SmolLM是由 Huggingface 最新发布的一系列最先进的小型语言模型,有三种规格:1.35亿、3.6亿和17亿个参数。这些模型建立在 Cosmo-Corpus 上,Cosmo-Corpus 是一个精心策划的高质量训练数据集。

Video-XL利用语言模型(LLM)的原生能力,对长视觉序列进行压缩,保留了短视频理解的能力,并在长视频理解上显示出了卓越的泛化能力。Video-XL在效率与性能之间实现了良好平衡,仅需一块80G显存的显卡即可处理2048帧输入,对小时级长度视频进行采样,并在视频“海中捞针”任务中取得了接近95%的准确率。该模型的推出,标志着长视频理解技术在效率和准确性上迈出了重要一步,为未来长视频内容的自动化

Video-XL 的核心在于“视觉上下文潜在摘要”技术,它利用 LLM 固有的上下文建模能力,将长视觉表示有效地压缩成更紧凑的形式。同时,大量的视频标记也会带来高昂的计算成本。在多个长视频理解基准测试中,Video-XL 都取得了领先的成绩,尤其是在 VNBench 测试中,它的准确率比现有最佳方法高出近10%。更令人印象深刻的是,Video-XL 在效率和效果之间取得了惊人的平衡,它可以在单个8

例如,Tarsier-34B 模型处理8帧视频需要4608个标记,而 BLIP-3-Video 只需32个标记,就能实现77.7% 的 MSVD-QA 基准得分。在 NExT-QA 数据集中,模型取得了77.1% 的高分,而在 TGIF-QA 数据集中,也达到了77.1% 的准确率。随着视频数据量的不断增长,这种方法变得愈发低效,因此,找到一种既能捕捉到视频的关键信息,又能减少计算负担的解决方案至
