


- @weixin_30777913


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
使用JDBC连接到TCHouse - P,在爬虫配置中指定JDBC URL: jdbc:postgresql://<TCHouse - P endpoint>:5436/<database_name> ,并提供相应的认证信息。使用JDBC连接到TCHouse - D,在爬虫配置中指定JDBC URL: jdbc:mysql://<TCHouse - D endpoint>:3306/<databa
并结合数据特征调整,可显著提升 PySpark 作业的并行效率和资源利用率。建议在开发和生产环境中进行多轮基准测试以确定最优值。是一个关键参数,直接影响作业的并行度和资源利用率。在 PySpark 中,
【代码】Linux下Jenkins数据故障的系统化排查Shell脚本。
需结合任务类型和内存使用监控。对于缓存密集型任务,适当提高存储内存比例;对于Shuffle密集型任务,优先保障执行内存。新版本Spark的动态内存机制简化了调优,但手动干预在极端场景下仍有效。最终需通过反复测试验证参数效果,实现性能最优。优化PySpark程序的性能时,合理设置。(或相关内存参数)是关键。
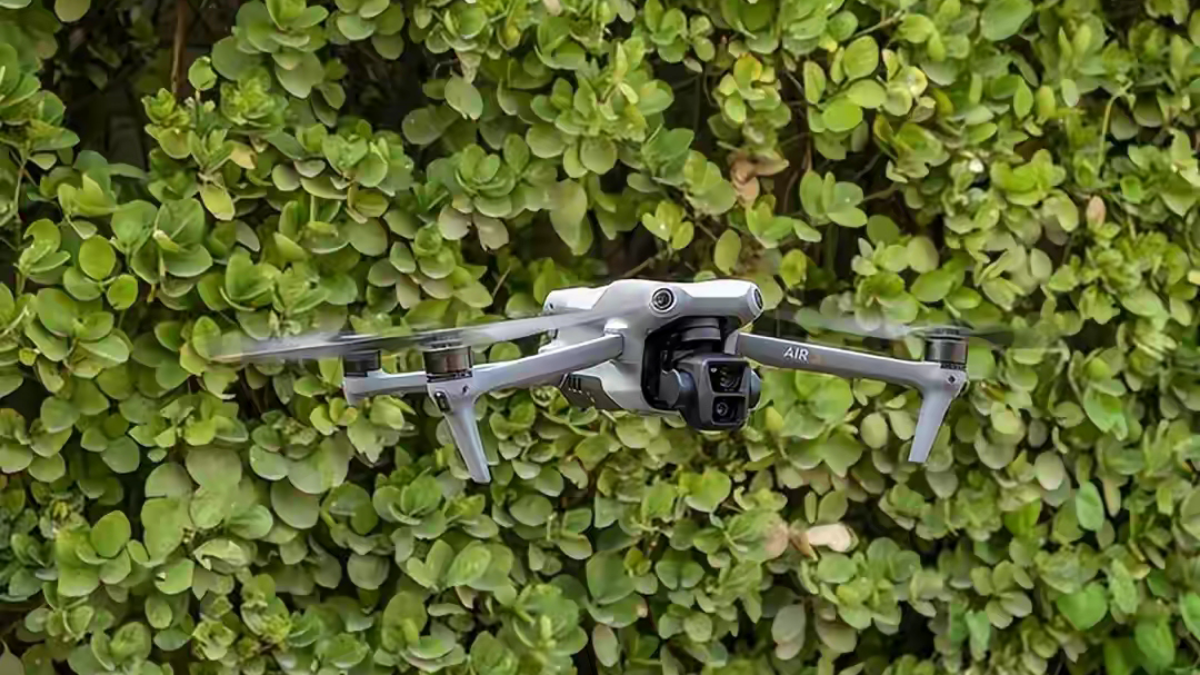
无人机镜头稳定的原理和相关算法主要是通过镜头平衡技术和实时电子稳像技术来保持摄像镜头的稳定性,从而拍摄出清晰、稳定的画面。不同的无人机可能采用不同的稳定方法和算法,具体的实现方式会因无人机的型号和设计而有所差异。它通过计算每行每列的像素值总和,然后在行方向和列方向分别计算其前后两帧图像的相关性,相关性最大的位置就是该方向上图像相对的偏移值。这些算法可以分析相机拍摄的图像,检测图像中的抖动和晃动,并
写一段Redshift的SQL,检查一个表格里所有的字符串字段是否有值等于keyword的单元格,如果有,输出一张表,包含Schema名、表名、字段名和值,输出结果集不包含重复数据。这种方案在性能和结果完整性之间取得了平衡。
对于Pandas DataFrame使用zipfile和直接读取处理大型文件时使用分块读取优化数据类型以减少内存使用对于PySpark DataFrame通过Pandas中转(适合中小型数据)解压后直接读取(适合大型数据)支持处理ZIP中的多个JSON文件性能优化使用适当的数据类型并行处理多个文件流式处理大型文件根据数据大小和处理需求选择合适的方法,可以在保证性能的同时高效地处理ZIP压缩文件中的
导出所有用户和角色设置 SELECT SQL FROM ( SELECT concat('CREATE USER IF NOT EXISTS ', name, ' IDENTIFIED WITH ', auth_type[1], ' BY \'', '<password>', '\�
Amazon Redshift作为云端数据仓库,在处理大规模数据分析时表现出色。将Pandas DataFrame高效地写入Redshift是数据工程中的常见需求。本文将详细探讨三种主要方法:AWS SDK for Pandas、SQLAlchemy结合psycopg2,以及它们的性能优化策略。小数据集:使用AWS SDK for Pandas直接写入或SQLAlchemy大数据集:优先选择通过S
运行该程序,将输出如下(基于内置的 MySQL。