


- @qq_34321590


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
1.问题描述报错内容2.解决方案增加依赖项3.注意事项依赖版本,要和你使用的flink版本对应。

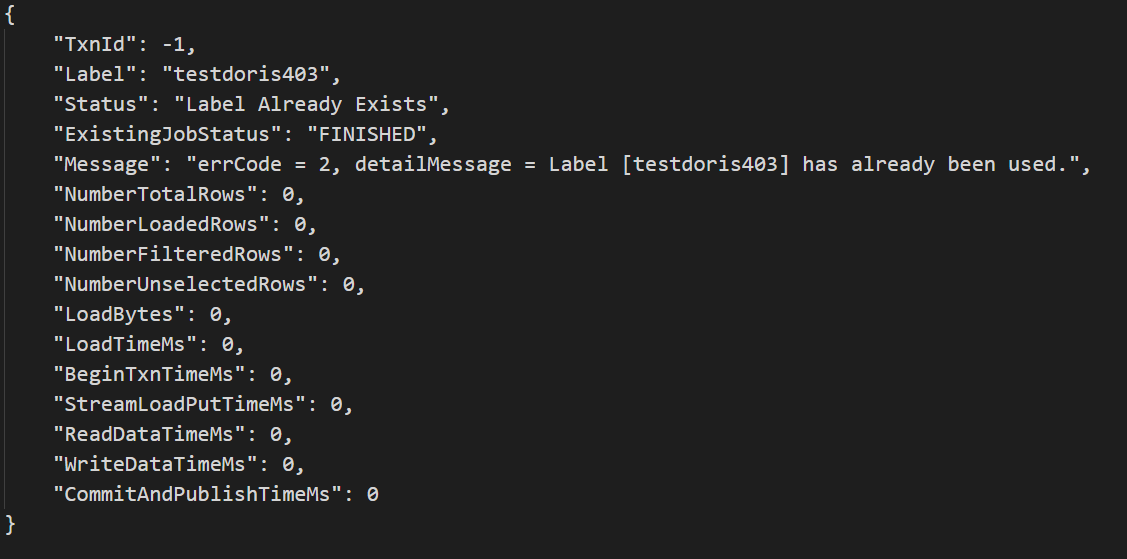
1.报错场景加载数据[starcross@app1 FLink-test-LT]$ curl --location-trusted -u root:aba -T 'data_2022-04-11.csv' -H "label:testdoris201" -H "column_separator:," -XPUT http://10.22.33.69:8030/api/os/ws/_stream_l
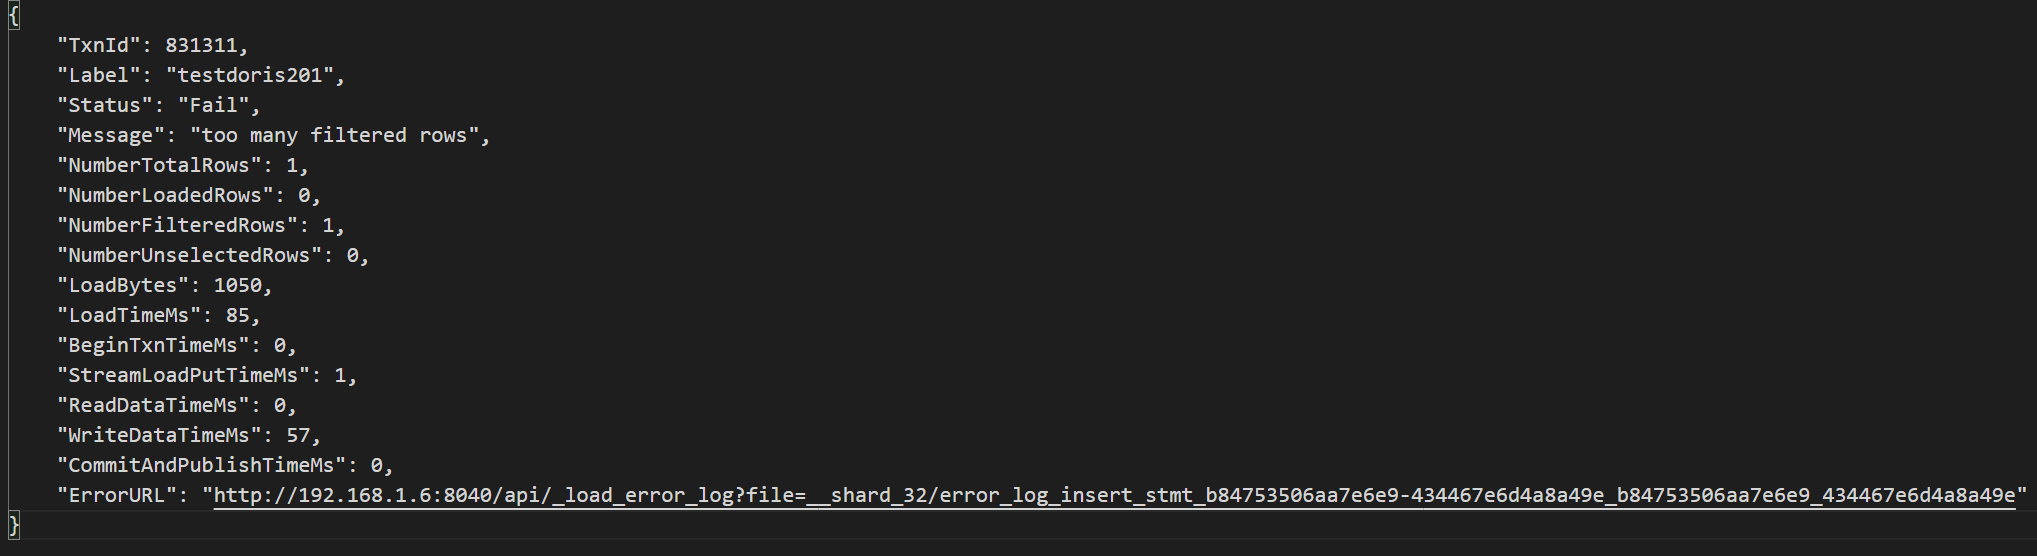
1.报错场景加载数据[starcross@app1 FLink-test-LT]$ curl --location-trusted -u root:aba -T 'data_2022-04-11.csv' -H "label:testdoris201" -H "column_separator:," -XPUT http://10.22.33.69:8030/api/os/ws/_stream_l
1.问题描述新启用了一个集群,正常启动kafka和zookeeper后,jps查看所有节点kafka和zookeeper都正常工作。当使用命令行创建topic时./kafka-topics.sh --zookeeper linux1:2181 --create --replication-factor 3 --partitions 1 --topic test-topic,报了如下错误:Error
最近无聊想刷几部电影,可是去下载的时候发现网页浏览太麻烦了,要一个一个点开看。其实大多数时候我们看一眼名字和主演就可知道要不要看了。索性写了一个爬虫,爬了200多部电影和下载地址,话不多说上源码和爬取结果。SRC:import requestsfrom requests.exceptions import RequestException...
查询后brand_name/company_name为空。带下划线的字段,都会返回空值,应该是字段映射出了问题。在配置文件中添加下划线自动映射为驼峰。数据苦衷实际存储字段全不为空。再次查询,字段正常返回。

猜测是未指定编码造成的,在配置文件mybatis-config.xml添加配置。再次执行插入动作,不再乱码。中文字段乱码,不能正常显示。

1.指令cd ..2.实操演示
1.需求从离线Hive数仓ads层抽取数据到Mysql2.参考DataX官方Github实例DataX官网从hive读数据{"job": {"setting": {"speed": {"channel": 3}},"content": [{"reader": {..
1.指令cd ..2.实操演示
