


- @okbin1991


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
大促之前全链路压监控篇1. skywalking服务监控1.1 skywalking简介Skywalking 是一个APM系统,即应用性能监控系统,为微服务架构和云原生架构系统设计它通过探针自动收集所需的指标,并进行分布式追踪,通过这些调用链路以及指标,SkywalkingAPM会感知应用间关系和服务间关系,并进行相应的指标统计,目前支持链路追踪和监控应用组件如下,基本涵盖主流框架和...
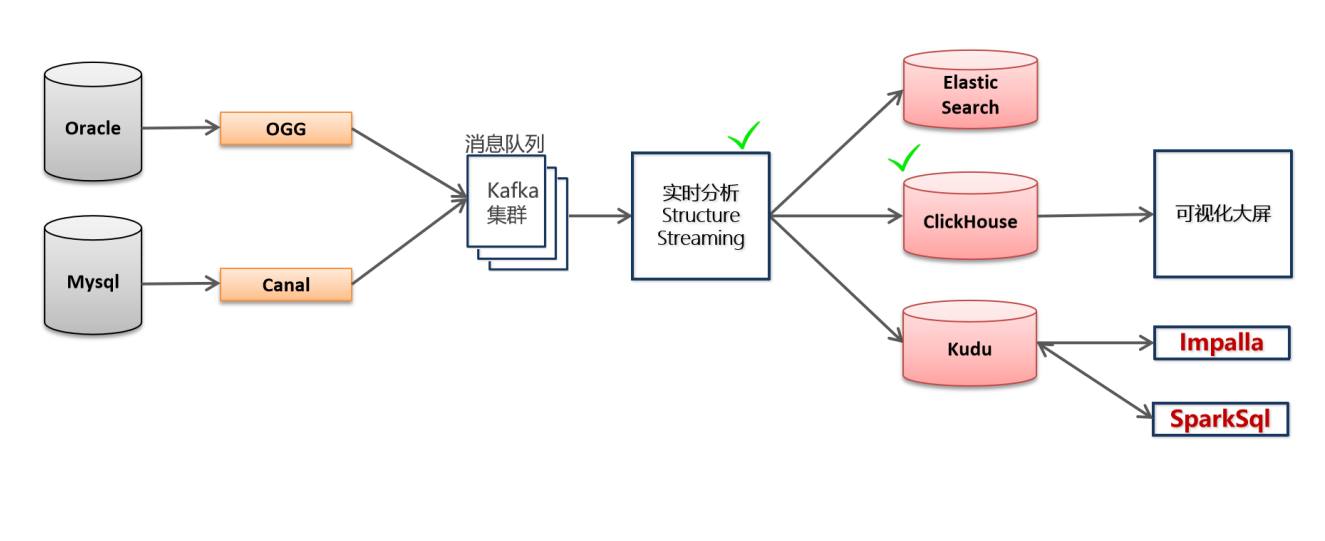
实时OLAP开发一、实时ETL处理使用ClickHouse分析物流指标数据,必须将数据存储到ClickHouse中。业务流程:二、SparkSQL基于DataSourceV2自定义数据源1、Data Source API V1Spark 1.3 版本开始引入了 Data Source API V1,通过这个 API 我们可以很方便的读取各种来源...
hdfs写数据流程契约部分hdfs文件最小单位创建socket请求发送给dataXceiverserver两个datanode之间通过blockReceiver建立管道将数据发送到下游管道内的所有数据写成功才移除ackqueue中的数据...
第一章 Flink简介1.1 初识FlinkFlink起源于Stratosphere项目,Stratosphere是在2010~2014年由3所地处柏林的大学和欧洲的一些其他的大学共同进行的研究项目,2014年4月Stratosphere的代码被复制并捐赠给了Apache软件基金会,参加这个孵化项目的初始成员是Stratosphere系统的核心开发人员,2014年12月,Flink一跃成为...
文章目录1. Flume系列:2. zookeeper系列3.spark系列4.Mysql系列5.其他大数据面试题1. Flume系列:1.Channel Selectors有几种类型,它们的区别是什么?答:有两种。Replicating Channel Selector(默认的)和Multiplexing Channel Selector。(1)Replicati...
第 1 章HBase简介1.1HBase定义HBase是一种分布式、可扩展、支持海量数据存储的NoSQL数据库。1.2HBase数据模型逻辑上,HBase的数据模型同关系型数据库很类似,数据存储在一张表中,有行有列。但从HBase的底层物理存储结构(K-V)来看,HBase更像是一个multi-dimensional map。1.2.1HBase逻辑结构1.2.2HBa...
------Flink初级1、简单介绍一下 Flink2、Flink相比传统的Spark Streaming区别?3、Flink的组件栈有哪些?4、Flink 的运行必须依赖 Hadoop组件吗?5、你们的Flink集群规模多大?6、Flink的基础编程模型了解吗?7、Flink集群有哪些角色?各自有什么作用?8、说说 Flink 资源管理中 Task Slot ...
一、数据质量概述什么是数据质量数据质量差的危害数据质量维度(数据六大评价标准)什么是数据质量测量数据质量测量必须要有目的数据质量测量必须可重复数据质量测量必须可解释什么是数据质量管理二、数据问题根因分析什么是根因分析为什么要进行根因分析产生数据问题的阶段规划设计阶段数据创建阶段数据使用阶段数据老化阶段数据消亡阶段产生问题的原因业务原因技术原因管理原因根因分析的方法根因分析的工具鱼骨图5WHY图故.
数据仓库命名规范目录1. 概述 32. 数据仓库命名规范 42.1. 命名规范 42.1.1. 表属性规范 42.1.2. 索引 92.1.3. 视图 102.1.4. 物化视图 102.1.5. 存储过程 102.1.6. 触发器 102.1.7. 函数 102.1.8. 数据包 102.1.9. 序列 102.1.10. 普通变量 102.1.11. 游标变量 ...
阿里四轮面试总结第一轮面试电话(**5** 月 6 号):1.自我介绍,包括做过项目。2.有看过哪些 JDK 源码,了解哪些常用库。3.集合框架 HashMap 的扩容机制,ConcurrnetHashMap 的原理4.jvm 内存模型与 gc 内存回收机制5.classloader 结构,是否可以自己定义一个 java.lang.String 类,为什么? 双亲代理机制。 ...