


- @mojin2005


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
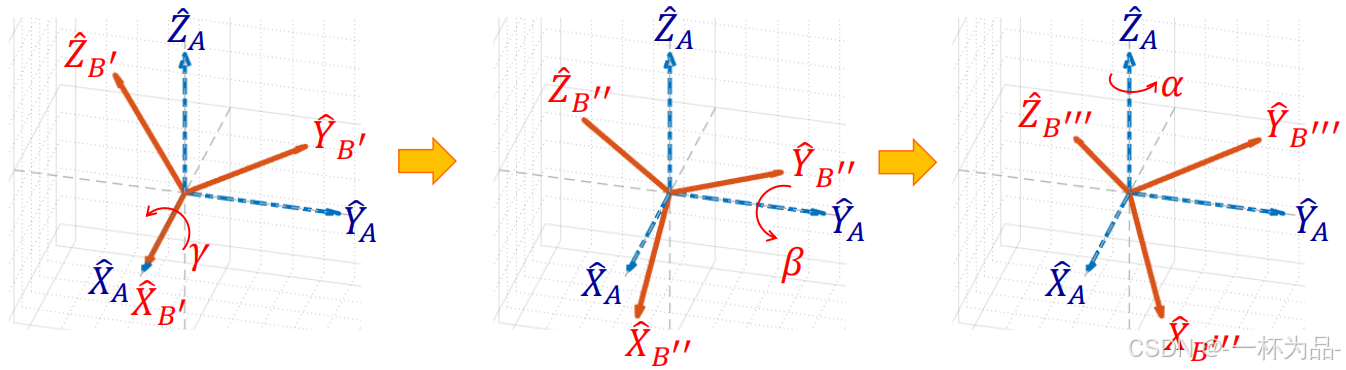
固定角;欧拉角;映射;算子;齐次变换矩阵
环境的(Model)是一个智能体可以用来预测环境对其动作的反应的任何事物。给定一个状态和一个动作,模型能产生后继状态和下一个收益的预测作为环境的反应结果。根据是否有模型参与,强化学习算法可分为(Model-Based RL,MBRL)和在【深度强化学习】和【分层强化学习】中,我们探讨的都是MFRL,它们将环境视为一个黑箱,智能体直接从与环境交互获得的经验数据中学习价值函数或策略,而不会尝试理解环境
本文介绍了深度强化学习开山之作DQN算法,重点介绍了其核心思想与关键技术改进。首先阐述了传统Q-learning在连续状态空间下的局限性,提出用神经网络拟合Q函数的价值函数近似方法。完整介绍了DQN算法流程后,针对原始算法存在的两大问题:数据相关性和训练不稳定性,分别引入经验回放和目标网络两项关键技术。经验回放通过缓存和随机采样eph果克服数据相关性问题;目标网络通过解耦评估与目标计算来稳定Q值收
本文介绍了确定性策略梯度(DPG)算法及其理论依据。DPG通过输出确定性动作解决了随机策略在连续动作空间中的计算开销、方差问题和训练不稳定等缺点。文章详细推导了确定性策略梯度定理,证明其只需对状态空间积分,比随机策略梯度更简洁。DPG采用Actor-Critic框架,Actor网络输出确定动作,Critic网络评估动作价值,通过离轨策略提升状态探索性。文章还分析了DPG的局限性,如依赖于行为策略的
本文系统阐述了足式机器人强化学习框架中的关键要素,重点解析了奖励函数的设计原理。观测空间包含本体感知、环境信息和任务指令;动作空间分为扭矩、速度/位置和步态三个层级,其中关节位置控制是主流方案。论文示例的奖励函数包含六大类:跟踪奖励(速度匹配)、稳定性奖励(抑制异常运动)、效率奖励(降低能耗)、平滑度奖励(减少抖动)、步态奖励(优化足端运动)和碰撞惩罚。这些奖励项通过加权组合,在保证运动性能的同时
为了进一步提高长线学习的效率,该系列从本章开始将舍弃原始教材的代码部分,专注于理论和思维的提炼,系列名也改为“深度学习”消除误导性。在学习中将理论与实践紧密结合固然有其好处,但在所学知识的广度面前,先铺垫广泛的理论基础,再根据最终实践的目标筛选出需要得到深化的理论知识可能是更有效的策略。概述卷积神经网络可以有效地处理空间信息,而循环神经网络(RNN)则可以很好地处理序列信息。循环神经网络通过引入状
博主因不满CSDN平台内容质量,决定停止更新。后续文章将转移至个人网站www.inkem.space、微信公众号"一杯为品"和知乎账号@一杯为品继续发布。
SAC(Soft Actor-Critic)是一种基于最大熵强化学习的Actor-Critic方法,通过引入策略熵来增强探索能力。相比确定性策略方法,SAC采用随机性策略和重参数化技巧,既降低了方差又提高了采样效率。其核心创新在于:1)在目标函数中引入策略熵项,鼓励多样化的探索;2)使用重参数化技巧将随机性与策略参数解耦,实现更稳定的梯度传播。SAC在连续控制任务中展现出优异的样本效率和鲁棒性,成
本文介绍了确定性策略梯度(DPG)算法及其理论依据。DPG通过输出确定性动作解决了随机策略在连续动作空间中的计算开销、方差问题和训练不稳定等缺点。文章详细推导了确定性策略梯度定理,证明其只需对状态空间积分,比随机策略梯度更简洁。DPG采用Actor-Critic框架,Actor网络输出确定动作,Critic网络评估动作价值,通过离轨策略提升状态探索性。文章还分析了DPG的局限性,如依赖于行为策略的
本文介绍了深度强化学习开山之作DQN算法,重点介绍了其核心思想与关键技术改进。首先阐述了传统Q-learning在连续状态空间下的局限性,提出用神经网络拟合Q函数的价值函数近似方法。完整介绍了DQN算法流程后,针对原始算法存在的两大问题:数据相关性和训练不稳定性,分别引入经验回放和目标网络两项关键技术。经验回放通过缓存和随机采样eph果克服数据相关性问题;目标网络通过解耦评估与目标计算来稳定Q值收