


- @m0_74373135


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
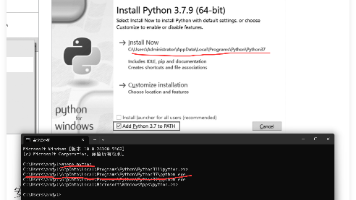
下载Python 3.9.7安装包(官网或镜像站)
在 NLP 中,计算机无法直接理解文字,必须把文本 → 数字向量。传统方法:One-Hot、词袋模型(CountVectorizer)One‑Hot 编码每个词对应一个只有 1 个 1、其余为 0 的向量缺点极度稀疏维度灾难无法表示语义相似性无法捕捉上下文词袋模型• CountVectorizer:统计词频• ngram_range(1,2):1 个词、2 个词组合• 缺点◦ 参数空间爆炸,无法处
本文详细介绍了基于TF-IDF算法的中文关键词提取方法。首先阐述了关键词提取的核心流程,包括语料库构建、中文分词、停用词过滤等预处理步骤。重点解析了TF-IDF算法的计算原理,通过词频(TF)和逆文档频率(IDF)的乘积实现词汇加权。随后提供了Python实战代码,使用sklearn的TfidfVectorizer实现关键词提取,并建议结合jieba分词和中文停用词库优化效果。此外介绍了词云图作为
选择工具→发送请求→解析数据→保存结果。静态网页用requests,高效简洁;动态网页用selenium,模拟浏览器渲染;合规爬取是前提,需遵守网站规则与法律法规。
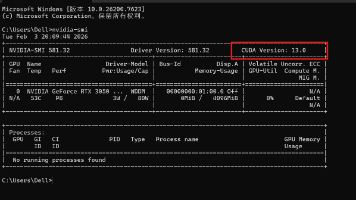
如果计算机上已经安装了与CUDA版本相兼容的Visual Studio Integration文件,或者通过其他方式(如单独安装Visual Studio的插件)已经集成了CUDA支持,那么在安装CUDA时勾选“Visual Studio Integration”可能会导致冲突或重复安装,进而引发问题。Torch是一个开源的机器学习库,主要用于构建深度学习模型。它基于Lua编程语言,并提供了一个强
NumPy的核心价值在于矩阵运算优化:并行计算优势:矩阵操作可实现批量数据处理,显著提升AI训练效率数学基础:支持矩阵求逆、求导等高等数学运算,满足机器学习算法需求性能对比:相比Python原生列表,NumPy数组计算速度提升10-100倍Numpy的版本选择与安装推荐安装numpy==1.26.1,通过pip list命令可查看已安装库的版本,Python第三方库镜像地址与配置,使用镜像地址加速

通过可视化的方式展示了如何在三维空间中应用k-NN算法进行学生性格分类,将爱学习、一般和爱玩的学生分别用不同颜色标记,并解释了如何通过调查问卷和辅导员的专业分析来获取和分类学生数据。机器学习中的k-近邻算法(k-NN)是一种基于实例的监督学习算法,适用于分类和回归任务。其核心思想是通过测量目标数据点与训练集中其他点的距离,找到最近的k个邻居,并根据这些邻居的类别(分类)或平均值(回归)进行预测。3
网络爬虫库介绍:• 网络爬虫是通过代码将HTML网页内容下载到本地的过程,主要用于获取网页中的关键信息(数据、图片、视频等)Python网络爬虫库:• urllib库:Python自带的标准库,无需下载安装,但代码编写较复杂• requests库:Python第三方库,需下载安装,基于urllib库构建,使用更简洁方便• scrapy库:Python第三方库,需下载安装,适用于专业应用开发,集成了
用「下采样」替代之前的 SMOTE 过采样,解决信用卡欺诈检测的类别不平衡问题,并基于逻辑回归模型完成从数据预处理、参数调优到模型评估的全流程,整体逻辑围绕 “下采样平衡数据→交叉验证选最优参数→模型训练→多维度评估” 展开。
