


- @m0_69966537


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
通过对dify源码的解析,用户上传的文档首先经过api处理后传递给文件处理服务层,对于知识管理,上传的 PDF 通过进入索引管道。这个过程通常通过异步执行。作为文档处理的中央处理器根据文档的格式选择具体的Extractor类专门用于 PDF 文件,利用使用 pypdfium2 这个高效的 PDF 解析库,按页读取 PDF 内容。
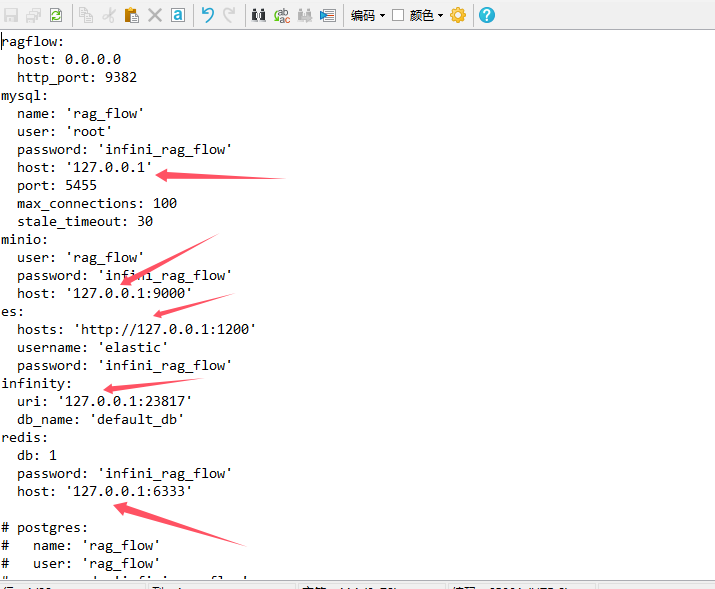
进入根目录和management/server/中执行。原因是宿主机和容器映射端口都被改成了6333。在已激活的 conda 环境中。
该报错说明KV缓存所需的内存超过了可用的显存,KV缓存的计算涉及模型层数、序列长度和批次大小等因素,模型默认设置的max_seq_len是40960,这大大超过了服务器的负载上限,应该降低通过调整–max_model_len参数以减少KV缓存需求。接口必须确认实际加载的模型名称,避免因名称不匹配导致404错误。适用场景:非对话式文本生成(如问答、续写)适用场景:多轮对话(如聊天机器人)

Next.js 应用在生产环境中运行时,它提供的是编译和打包后的静态文件和服务器端渲染的页面。后面尝试的 volumes: - ./web/src:/app/web/src 挂载,确实让容器内部的 /app/web/src 目录与宿主机上的源代码目录实时同步了。所以,容器内 /app/web/src 目录的源代码是更新后的代码,但 langfuse-web 容器中运行的 Next.js 应用程序实
该报错说明KV缓存所需的内存超过了可用的显存,KV缓存的计算涉及模型层数、序列长度和批次大小等因素,模型默认设置的max_seq_len是40960,这大大超过了服务器的负载上限,应该降低通过调整–max_model_len参数以减少KV缓存需求。接口必须确认实际加载的模型名称,避免因名称不匹配导致404错误。适用场景:非对话式文本生成(如问答、续写)适用场景:多轮对话(如聊天机器人)
Docker容器日志管理经验总结:当发现服务器磁盘空间异常时,通过du和find命令可以快速定位大文件,通常为容器日志。案例显示一个Redis连接失败的容器日志占用了925G空间。解决方法包括:1)使用truncate清空日志;2)配置logrotate实现日志轮转(限制大小100M,保留7个压缩日志)。关键技巧:-d参数调试配置,-f强制执行首次轮转。建议为重要容器单独配置日志管理,防止日志无限
第一句是关于春节,中国家庭做饺子,长辈讲关于年兽的故事。这里要注意“make dumplings”翻译成“包饺子”比较合适,而“Nian”是年兽,应该音译为“年兽”或者“年兽”,但通常用“年兽”更常见。model="/home/xugq/qwen3-1.7b/",# 使用模型路径,如通过--served-model-name指定名称需与 vLLM 服务启动时指定的名称一致。:指定使用的推理解析器,
大模型处理文本的核心流程分为三个阶段:1)输入处理,将文本分词、嵌入为向量并添加位置编码;2)模型计算,通过多层Transformer结构进行上下文理解和推理;3)输出生成,将概率分布转换为文本并循环生成完整内容。整个过程实现了"文本→数字→计算→数字→文本"的转换,结合符号处理和神经网络计算,使模型能够理解和生成人类语言。
预训练模型是深度学习中的关键技术,通过在大规模数据上预先学习通用特征,再迁移到具体任务中进行微调。其核心原理包括特征迁移和自监督学习,典型架构如Transformer和卷积神经网络。与用户自训练模型、传统机器学习模型及无预训练深度模型相比,预训练模型在数据需求、训练成本、特征通用性和任务扩展性等方面具有显著优势。然而,它也存在领域偏差、计算成本高和可解释性差等局限性。预训练模型广泛应用于自然语言处
LLM Guard敏感词过滤系统实现分析 Ban Substrings Scanner采用两种匹配方式: STR模式:简单字符串包含检查 WORD模式:正则表达式单词边界匹配 支持大小写敏感配置和敏感词替换功能 Ban Topics Scanner基于零样本分类技术: 使用预训练Transformer模型(如RoBERTa)进行主题分类 通过概率分数与人工设定阈值比较判断敏感内容 支持替换为中文模