- @m0_63815035


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
这篇文章主要学习Python的语法,为后续的自动化打基础Python + requests 接口自动化Python + selenium web 自动化Python + appium移动端自动化(手机 app)这篇文章分六个阶段百分比进行划分,到时大家可以选节查看什么是python?Python 是一种高级编程语言,由吉多·范罗苏姆(Guido van Rossum)于 1991年首次发布。它的设

本文介绍了服务器集群时间同步的两种场景:内网环境与外网环境。内网环境下,需配置一台主节点作为时间服务器,通过chrony或ntpd协议实现集群内时间同步;外网环境下可直接使用公共NTP服务器(如阿里云NTP)进行同步。文中详细给出了主从节点的chrony配置步骤、时间同步验证方法及注意事项,确保集群各节点时间一致性,避免因时间偏差导致的服务异常。
浏览器开发者工具就是给专业的web应用和网站开发人员使用的工具。包含了对HTML查看和编 辑、Javascript控制台、网络状况监视等功能,是开发JavaScript、CSS、HTML和Ajax的得力助手。(俗称F12) 就是按下F12键就会进入开发者工具,只对于谷歌浏览器用户来说。

大数据电商项目实战摘要 本项目为大数据实战课程,聚焦电商流量分析,涵盖Hadoop、Hive、Spark等核心技术栈。课程采用"理论+实践"模式,10天完成从数据采集到可视化的全流程,重点包括: 搭建Hadoop高可用环境,掌握HDFS/YARN核心原理 使用Hive构建数据仓库,实现ODS→DWD分层建模 通过Spark SQL计算PV/UV等核心指标 利用Flume实现日志

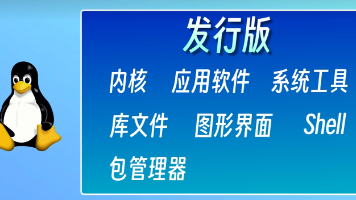
本文介绍了大数据电商实战项目的课程内容和学习计划,涵盖Hadoop、Hive、Spark等核心技术,并详细讲解了Linux文件系统结构。课程采用“实战拆解+技术落地”方式,通过10天学习掌握大数据处理全流程,包括数据采集、存储、计算、分析和可视化。文章还提供了Linux基础知识,如内核结构、发行版特点,以及Linux二级目录的功能解析(如/bin、/etc、/home等),帮助读者快速搭建大数据学
《大数据电商项目实战课程》摘要: 本课程聚焦大数据技术在电商领域的实战应用,涵盖Hadoop、Hive、Spark等核心组件,通过10天模块化学习(环境搭建→数据采集→指标计算→可视化),带领学员完成从原始日志到分析报表的全流程。重点包括:Flume实时采集、Hive分层建模、Spark SQL指标计算(PV/UV/跳出率)、Shell定时任务及FineBI可视化。课程强调企业级实践,提供完整项目
摘要 本文介绍了一门大数据电商实战课程,涵盖Hadoop、Hive、Spark等核心技术,通过10天学习掌握从数据采集到分析可视化的全流程。课程采用"理论+实操"模式,重点讲解Hadoop高可用搭建、Hive数仓构建、Spark指标计算等核心模块。同时详细演示了Linux环境下MySQL 8.0的安装步骤,包括依赖安装、mariadb卸载、rpm包安装及服务启动等操作,为后续大
本文介绍了《大数据电商项目实战》课程的核心内容与学习计划。课程以"实战拆解+技术落地"为导向,通过10天系统学习,帮助学员掌握Hadoop、Hive、Spark、Flume等大数据技术在电商场景的应用。 主要内容包括:大数据基础概念、Hadoop高可用环境搭建、Hive数据仓库构建、Spark SQL核心计算、Flume日志采集、PV/UV指标计算、定时任务调度等全链路技术点。
Flink算子状态摘要 Flink算子状态(Operator State)是与算子实例绑定的中间数据,用于记录处理上下文(如偏移量、缓存等)。核心特点包括状态与算子实例绑定、并行度变化时自动重分配。提供4种实现:ListState(列表存储)、UnionListState(全量复制)、BroadcastState(广播配置)和ReducingState(聚合值)。典型应用场景包括Source算子的
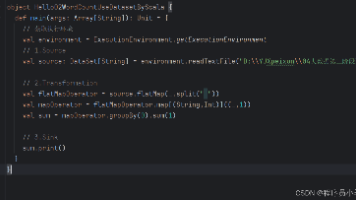
程序员小羊遇到Flink Scala代码假报错问题:IDEA显示语法错误但实际运行成功。尝试了多种方法无效,最终解决方案是将IDEA的Scala检查模式从"Built-in"切换为"Compiler"模式,彻底避免了IDE对Flink隐式转换的错误提示。该案例揭示了IDE内置检查机制在处理复杂Scala类型推断时的局限性:实时检查(Built-in)易误报,