


- @lrj41781196


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
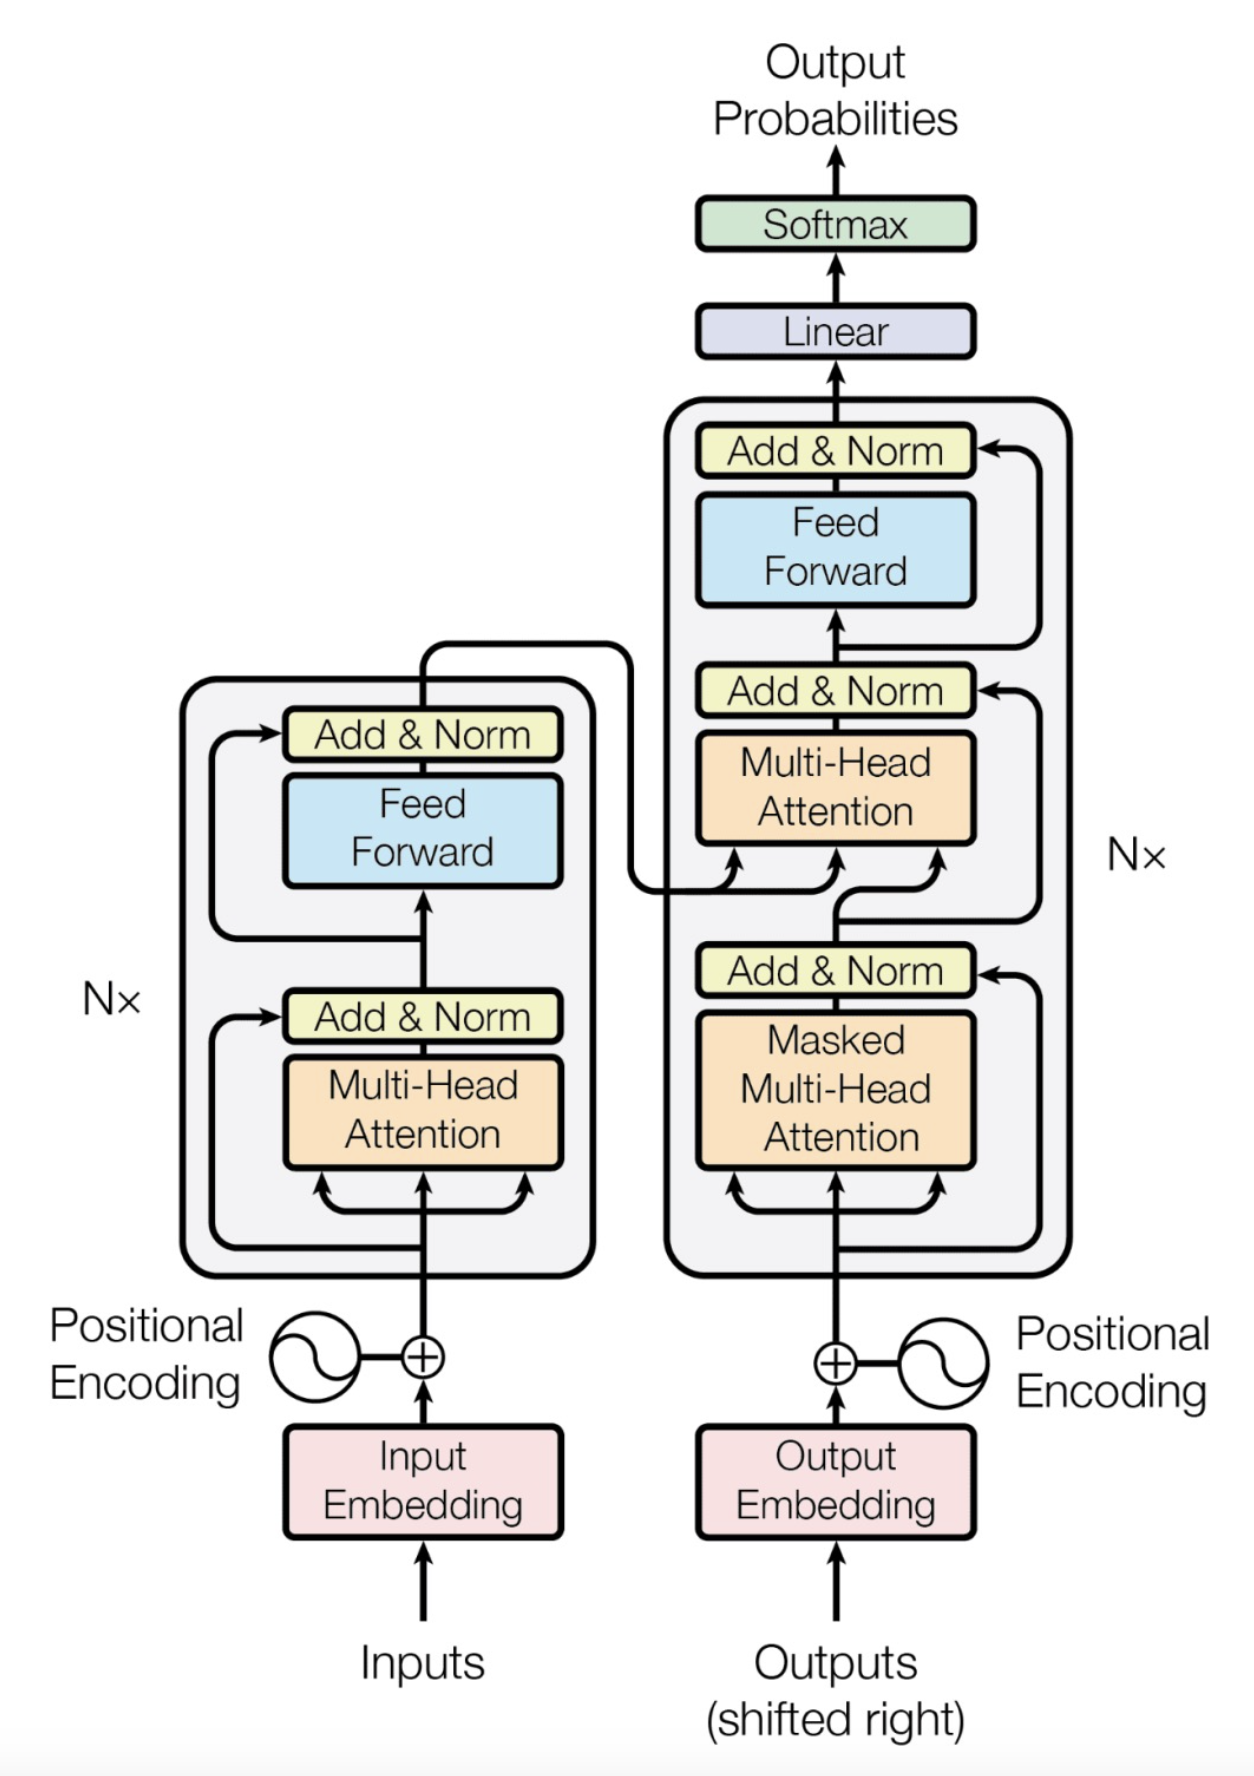
Transformer是自然语言处理领域的革命性架构,其核心设计摒弃了循环结构,采用自注意力机制实现全局依赖建模。主要组件包括自注意力机制、多头注意力、位置编码、残差连接与层归一化。自注意力机制通过查询矩阵(Q)、键矩阵(K)和值矩阵(V)计算注意力权重,多头注意力则并行多个注意力头以捕获不同子空间信息。位置编码通过正弦函数引入序列位置信息,弥补了无循环结构的不足。编码器-解码器架构由多个相同层堆
BERT(Bidirectional Encoder Representations from Transformers)是自然语言处理领域的里程碑模型,通过大规模无监督预训练获取深度双向语言表示。其核心架构基于Transformer编码器,采用多头自注意力和前馈网络,并通过残差连接和层归一化增强模型性能。BERT通过掩码机制实现双向上下文建模,突破传统语言模型的单向限制。预训练任务包括掩码语言建

`Conv2d`参数详解:- `1`: 输入通道数(MNIST为灰度图)- `32`: 输出通道数(特征图数量)- `padding=1`: 在输入周围填充1圈0,保持空间分辨率(计算公式:`H_out = (H_in + 2*padding - kernel_size)/stride + 1`)- `MaxPool2d(2,2)`:使用2x2窗口,步长2,输出尺寸减半。
嵌入层将离散字符索引映射为连续向量空间- 参数:`num_embeddings`(词汇表大小), `embedding_dim`(隐藏层维度)- 创建GRU循环层(可替换为LSTM)- `batch_first=True` 表示输入形状为 `(batch, seq, feature)`- 输出形状:`(batch, seq, hidden_size)`- 初始化隐藏状态为全零张量- 形状:`(nu

frm(旧版本)记录表结构MySQL 8 后使用数据字典替代.frm| SQL层 |↓| 查询执行器 → 调用引擎 | ----> | B+树定位主键页 |↓ ↓| 页进入 Buffer Pool |<----| 磁盘 I/O(如未命中) |↓| 写 Undo Log(支持回滚) |↓| 写 Redo Log(支持恢复) |↓| 修改内存页(Buffer Pool)|↓| 提交事务 COMMIT
生成对抗网络(GAN)通过博弈论框架实现数据生成,其核心是生成器(Generator)与判别器(Discriminator)的对抗训练:1)双网络架构- 生成器(G):将随机噪声z映射到数据空间,G(z) → 伪样本- 判别器(D):区分真实数据(P_data)与生成数据(P_g),输出概率值- 目标函数(极小极大博弈):$$ \min_G \max_D V(D,G) = \mathbb{E}_{
嵌入层将离散字符索引映射为连续向量空间- 参数:`num_embeddings`(词汇表大小), `embedding_dim`(隐藏层维度)- 创建GRU循环层(可替换为LSTM)- `batch_first=True` 表示输入形状为 `(batch, seq, feature)`- 输出形状:`(batch, seq, hidden_size)`- 初始化隐藏状态为全零张量- 形状:`(nu
本文深入剖析了Java并发编程中的核心机制,分为四个部分: MarkWord机制:详细解析对象头中MarkWord的结构和功能,包括锁状态转换、哈希码存储、GC年龄等,并分析了不同架构下的内存布局。 线程与同步:探讨Java线程在OS层的映射、锁的优化路径(偏向锁→轻量级锁→重量级锁)、内存屏障实现等底层细节。 LockSupport实现:深入分析park/unpark的许可证机制、Linux平台
DeepSeekMoE模型基于专家混合(Mixture of Experts, MoE)架构,通过动态路由机制实现计算资源的智能分配。其核心设计包括稀疏专家激活、门控网络创新、专家并行策略和DeepSeek特色改进。稀疏专家激活通过每个输入token仅激活top-k个专家,显著提高计算效率。门控网络引入随机噪声和TopK操作,确保路由的探索性和稀疏性。专家并行策略通过专家分片和动态负载均衡,优化资
本文总结了Spring框架中常用的扩展点,涵盖Web层、消息转换、Servlet/Filter、Bean容器、AOP、事务安全、嵌入式容器、监控等多个方面。重点介绍了HandlerInterceptor、WebMvcConfigurer、自定义参数解析器、统一响应处理、全局异常处理等核心组件的实现方式,并提供了5个可直接使用的完整示例代码,包括请求日志过滤器、用户参数解析器、统一响应包装、自定义消