


- @lemon9597


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
两者的区别:如果在library目录下存在该R包,运行library()函数时会返回已加载的R包的名称,否则系统会抛出异常并停止运行;而运行require()函数时,系统会根据R包是否存在相应地返回TRUE或FALSE,此时程序会继续执行。因此,前者能快速找出R脚本存在的问题,而后者则不会报错。

正则表达式是一种可供Linux工具过滤文本的自定义模板,Linux工具(如sed、gawk)会在读取数据时使用正则表达式对数据进行模式匹配。正则表达式使用元字符来描述数据流中的一个或多个字符。它是由正则表达式引擎实现的。正则表达式引擎是一种底层软件,负责解释正则表达式并用这些模式进行文本匹配。
1、输入输出重定向输入重定向:指把文件导入到命令中;标准输入重定向STDIN文件描述符为0。默认从键盘输入,也可以从其他文件或命令中输入。
具体来说,就是使用概率来评估一个单词序列发生的可能性,即在多大程度上是自然的单词序列。比如,对于“you say goodbye” 这一单词序列,语言模型给出高概率(比如 0.092):对于“you say good die' 这一单词序列,模型则给出低概率(比如 0.000 000 000 0032 )。此时,使用语言模型,可以按照〝作为句子是否自然〞这一基淮对候选句子进行排序。具体地说,先将输
SystemVerilog、有符号和无符号类型
R语言中,数据重塑(Data Reshaping)是指改变数据框(data frame)或类似结构(如矩阵、列表等)的形状,以适应不同的分析或可视化需求。这通常涉及行和列的重新排列、数据的汇总或拆分等操作。数据重塑是数据预处理中的一个重要步骤,特别是在数据分析和机器学习项目中,因为不同的算法和可视化工具对数据格式有不同的要求。R语言中有几个常用的包和函数来进行数据重塑,其中最著名的是reshape

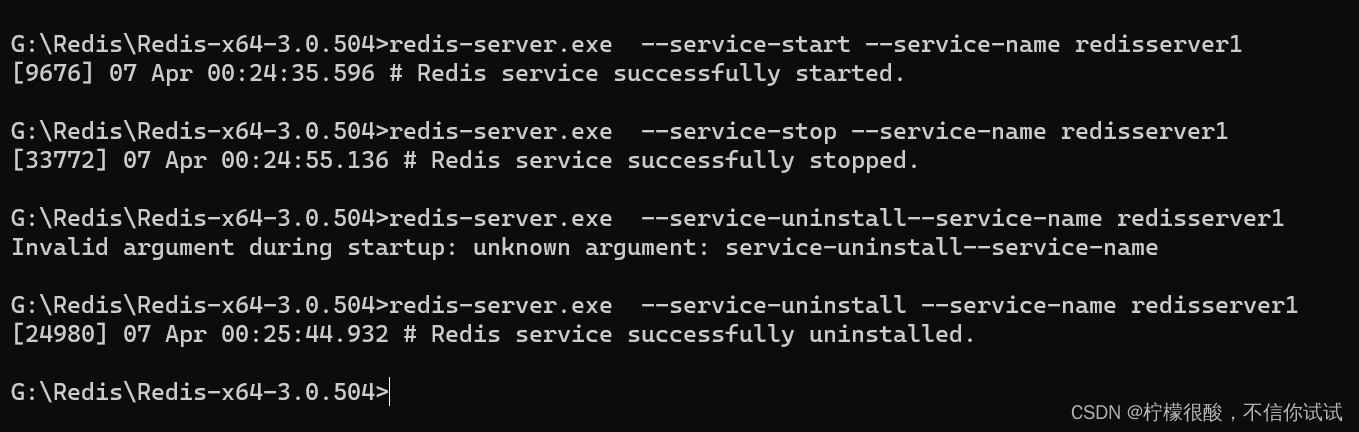
Redis service failed to start的解决方法
具体来说,就是使用概率来评估一个单词序列发生的可能性,即在多大程度上是自然的单词序列。比如,对于“you say goodbye” 这一单词序列,语言模型给出高概率(比如 0.092):对于“you say good die' 这一单词序列,模型则给出低概率(比如 0.000 000 000 0032 )。此时,使用语言模型,可以按照〝作为句子是否自然〞这一基淮对候选句子进行排序。具体地说,先将输
具体来说,就是使用概率来评估一个单词序列发生的可能性,即在多大程度上是自然的单词序列。比如,对于“you say goodbye” 这一单词序列,语言模型给出高概率(比如 0.092):对于“you say good die' 这一单词序列,模型则给出低概率(比如 0.000 000 000 0032 )。此时,使用语言模型,可以按照〝作为句子是否自然〞这一基淮对候选句子进行排序。具体地说,先将输
SystemVerilog、有符号和无符号类型