


- @a_code_rookie


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
定义结构体//结构体typedef struct {int *data;//动态分配的指针int maxsize; //顺序表的最大容量int length;//静态顺序表的当前长度} SeqList;此处声明函数//声明基本操作void initList(SeqList *L);void increaseSize(SeqList *L);int getLength(SeqList L);int
环境spark:3.0.0scala:2.12.10kafka:2.12-2.2.2spark-streaming:org.apache.spark:spark-streaming-kafka-0-10_2.12-3.0.0.jar描述使用spark-streaming连接Kafka并读取数据,出现如下错误:报错信息Exception in thread "streaming-start" jav
【数据结构】非递归实现二叉树的后序遍历
创建如图所示的二叉树。先序遍历为:ABDGECF中序遍历为:DGBEAFC创建结构体定义二叉树中每个结点的数据,以及左右孩子。typedef struct BiNode {char data;//结点数据struct BiNode *lchild, *rchild; //左右子树指针} BiNode, *BiTree;先序遍历按照根->左->右的顺序递归遍历二叉树,并打印输出。//先序
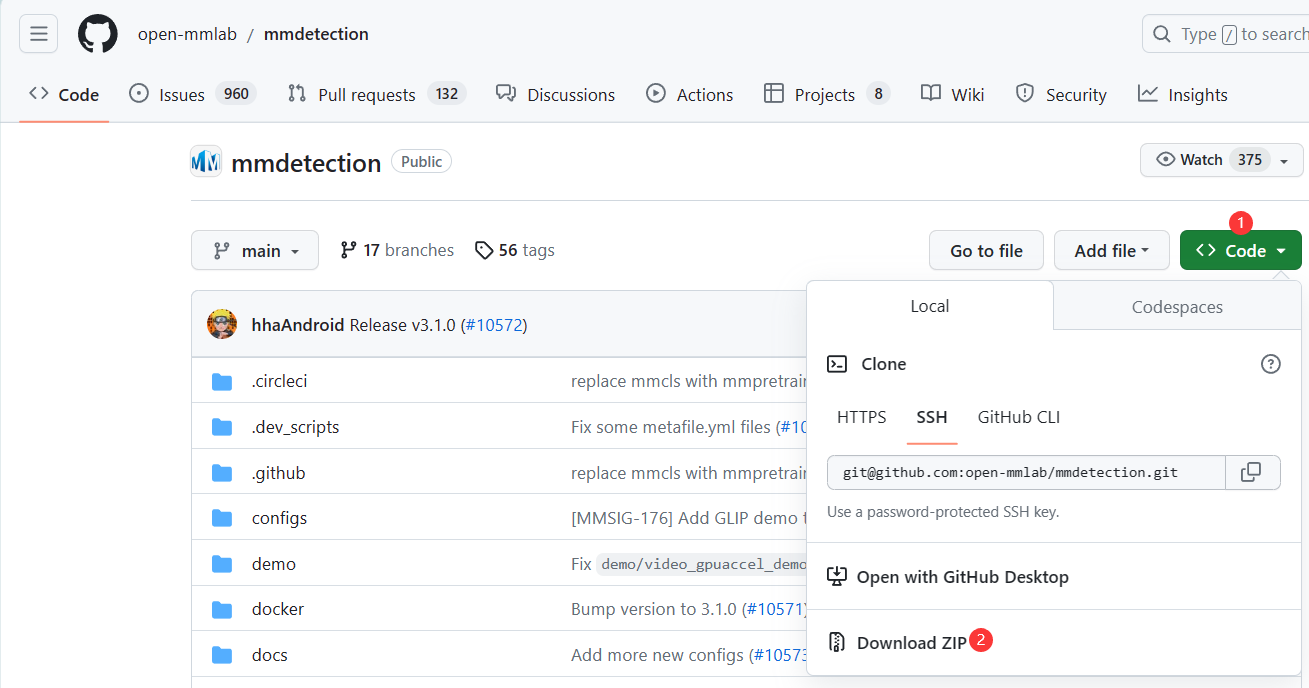
windows环境下使用mmdetection+mmdeploy训练自定义数据集并转成onnx格式部署。使用faster_RCNN+VOC格式数据集进行试验
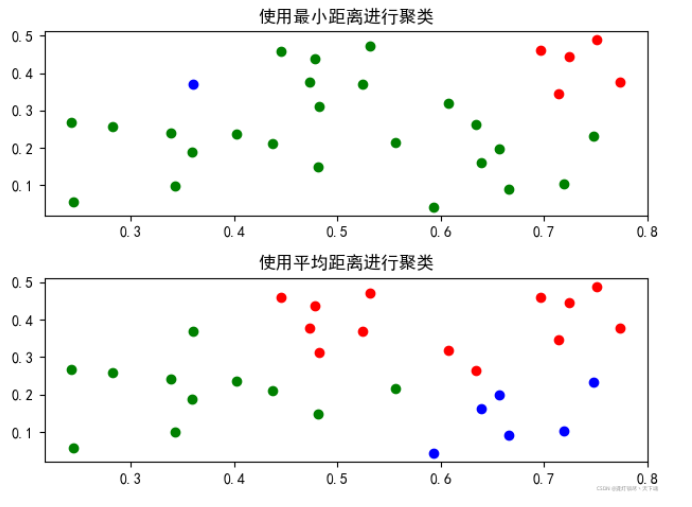
算法思想:初始每个数据都是一个簇;寻找每个簇之间的距离,获取距离列表;合并距离最近的两个簇Ci,Cj,并删除Cj,更新距离列表,使簇个数减1;重复第3步,直到簇个数等于所需个数k。
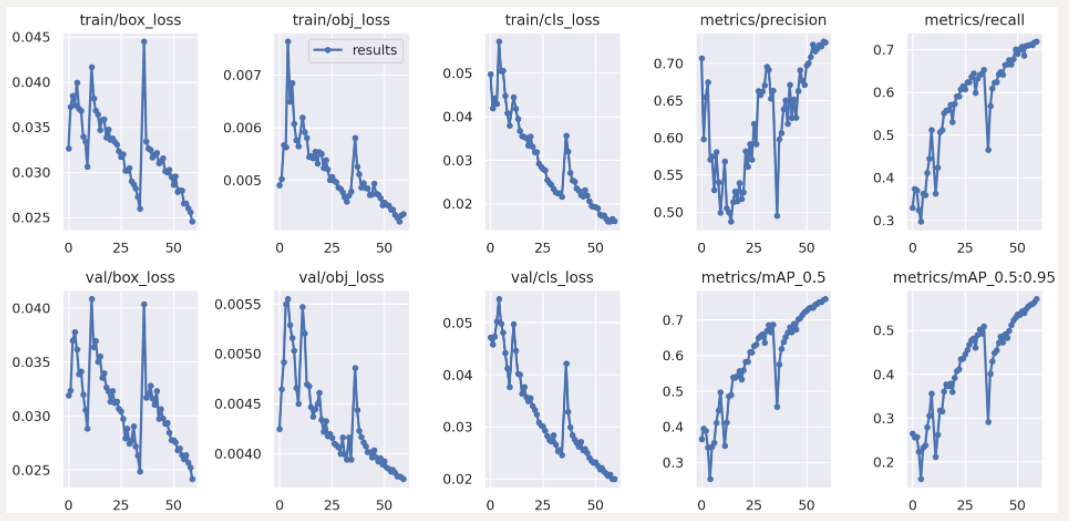
基于YOLOv5的交通标志识别系统-TT100K
1.介绍1.1 sigmoid函数逻辑回归中的sigmoid函数:g(θ0+θ1X1+⋯θnXn)=h(θX)=p=eθX1+eθXg(θ_0+θ_1X_1+\cdotsθ_nX_n)=h(θX)=p=\frac{e^{θX}}{1+e^{θX}}g(θ0+θ1X1+⋯θnXn)=h(θX)=p=1+eθXeθX也可写成(分子分母同时除以eθX):g(θ0+θ1X1+⋯θnXn)=h(
基于YOLOv5的交通标志识别系统-TT100K
非递归实现二叉树的先序遍历