


- @2502_92311356


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
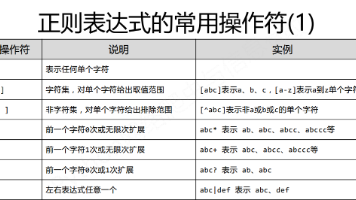
正则表达式(Regex)是一种强大的文本处理工具,广泛应用于表单验证、数据清洗、日志分析等场景。它通过特殊符号组合描述匹配规则,核心语法包括元字符(如.、\d)、量词(如*、{n})、字符类([])、分组(())和断言((?=))。典型应用包括校验手机号(^1[3-9]\d{9}$)、提取特定格式文本、批量替换内容等。掌握正则表达式能显著提升文本处理效率,是开发者必备技能之一。
MySQL面试八股文全集:从基础到架构的体系化指南 本文系统整理了MySQL全阶段面试知识点,分为四大模块: 基础篇:涵盖数据类型、SQL规范、范式设计等必考内容 进阶篇:深入多表查询、索引优化、事务特性等核心考点 精通篇:解析存储引擎、锁机制、性能调优等高级问题 架构运维篇:探讨分库分表、主从复制等生产级方案 每道题目均提供: 标准答案:准确简洁的官方解答 答题思路:结构化表达方法(总分总) 加
本文全面解析RAG(检索增强生成)技术,作为大模型应用落地的核心方案。RAG通过检索专属知识库内容作为生成依据,有效解决大模型幻觉、数据更新和安全问题。文章详细对比了RAG与微调技术的差异,指出RAG在知识注入、实时更新和成本方面的优势。技术架构部分拆解了离线索引构建(文档加载、分块、向量化)和在线问答生成(检索、重排序、生成)全流程,并提供分块策略、模型选型等实操建议。本文适合从零基础到进阶的开
本文深入解析了Transformer这一革命性架构的原始论文《Attention Is All You Need》。作为当前AI大模型的核心基础,Transformer彻底改变了序列建模范式,摒弃了传统RNN的串行计算,通过纯注意力机制实现高效并行处理。文章首先强调该论文的划时代意义:它不仅大幅提升了机器翻译性能,更开创了大模型时代,其影响力已扩展到计算机视觉、语音等多领域。随后提供了论文的精准中
2026年,依然是大模型应用开发的黄金窗口期,零基础入行,现在一点都不晚。很多人觉得,AI技术门槛很高,自己零基础、非科班,肯定学不会。但我想告诉你,大模型的出现,恰恰降低了技术开发的门槛,给了所有零基础学习者一个弯道超车的机会。传统后端开发,你需要积累3-5年,才能达到中级工程师的水平;而在大模型应用赛道,只要你找对了路线,用对了方法,3个月就能入门,1年就能达到中级工程师的水平,实现薪资的翻倍
大白话解释:虚拟环境就是给你的项目单独建了一个「独立的Python小房间」,你装的所有依赖包,都只在这个房间里生效,不会影响全局的Python环境,也不会和其他项目的依赖包版本冲突,这是Python开发的标准规范,新手从一开始就要养成好习惯。对于99%的人来说,我们不需要去造大模型这个「发动机」,我们只需要学会用这个发动机,造出能解决实际问题的产品,而写好后端接口,就是你造产品的第一步。
在大模型应用的技术体系中,工具是大模型与外部世界交互的、具备明确输入输出契约的原子化可执行能力单元。知识边界:突破预训练数据的时间、领域限制,获取实时、专属的领域数据;能力边界:突破纯文本推理的限制,实现文件操作、数值计算、API调用、多模态处理等可执行操作;环境边界:突破本地运行环境限制,与数据库、云服务、硬件设备、第三方系统进行交互。
摘要: 本文针对RAG(检索增强生成)系统中的大模型幻觉问题,提出了一套商用级解决方案。通过体系化Prompt工程、多模型兼容调用和引用溯源机制,从根源抑制幻觉,实现稳定问答。 核心内容: 幻觉根源分析:总结5大幻觉来源(Prompt约束缺失35%、检索内容无效30%等),强调商用场景需解决多模型兼容、成本控制等痛点。 Prompt工程铁律:提出6项设计原则,如强约束优先、强制引用溯源,并提供可直
本文是RAG系统商用部署的终极指南,涵盖从本地环境到生产上线的全流程解决方案。主要内容包括: 架构设计:提供生产级部署全景图,强调无状态服务、高可用集群、资源隔离等核心原则,给出Docker Compose单机部署和K8s集群两种方案选型。 环境准备:详细列出服务器最低配置要求(4核8G)和推荐配置(16核32G集群),提供Ubuntu系统优化脚本,包括关闭Swap、内核参数调优等关键设置。 核心
在正式深入技术细节之前,我们需要先给“上下文”一个清晰、完整的定义,厘清它在不同AI时代的形态与边界。狭义上下文:特指大语言模型输入序列中的token集合,也就是我们常说的系统提示词+对话历史+外部注入的知识信息,是模型单次推理能够直接读取的全部文本内容。广义上下文:是AI系统在执行任务时,所有能够影响其输出的、与当前任务相关的背景信息集合,包括但不限于文本序列、历史交互数据、环境状态、外部知识库