- @2401_88116610


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文详细介绍了Lua语言中唯一的数据结构——表(Tables)及其多样化用法。主要内容包括:1)表作为数组和字典的基础用法;2)混合表和嵌套表的实现方式;3)元表的概念及其特殊操作定义;4)表模拟常见数据结构如集合、栈和队列的方法;5)Lua内置的表操作函数。文章通过丰富的代码示例展示了表的灵活性和强大功能,强调掌握表的各种用法对于构建复杂数据结构的重要性,是Lua编程的核心技能之一。

本项目实现了使用Reptile算法在Omniglot数据集上进行小样本分类的功能。Reptile是由OpenAI开发的模型无关元学习算法,旨在通过最少的训练(小样本学习)快速学习执行新任务。该算法"通过使用在从未见过的数据小批量上训练的权重与在固定数量的元迭代训练之前的模型权重之间的差异来执行随机梯度下降"。

本项目实现了一个基于对比学习的半监督学习框架,主要基于 SimCLR 模型架构。这个实现旨在解决标签数据有限场景下的机器学习问题,通过利用大量未标记数据来提高模型性能。

本文介绍了一个基于Flask的JavaScript Ajax请求演示项目,包含三种实现方式:fetch API、XMLHttpRequest和jQuery。项目结构清晰,包含完整的后端处理(Flask)和前端交互模板。核心功能是演示不同技术如何发送POST请求到/add端点进行加法计算并显示结果。基础模板提供统一界面,子模板分别实现不同技术方案。该项目适合学习现代Web开发中的Ajax交互技术,涵
本文实现了一个基于CTC损失函数的自动语音识别系统,采用DeepSpeech2架构结合2D CNN和RNN。系统使用LJSpeech数据集进行训练和评估,通过词错误率衡量性能。文章详细介绍了数据处理流程、模型构建方法和训练过程,包括音频预处理、频谱图计算、CTC损失函数实现以及DeepSpeech2模型的搭建。项目提供了完整的代码实现,从数据加载、预处理到模型训练和评估,为构建端到端的语音识别系统
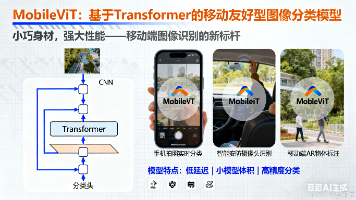
MobileViT是一种创新的移动友好型图像分类模型,结合了Transformer的全局特征提取能力和卷积网络的局部空间关系捕获优势。其核心创新在于MobileViT块设计,通过特征展开、Transformer处理和特征折叠,实现了局部与全局特征的有效融合。该模型保持计算效率的同时,在移动设备上表现出色,使用约一百万个参数,在256x256分辨率下达到约85%的top-1准确率。模型完全兼容Ten
本项目基于EfficientNet模型实现了斯坦福狗数据集的图像分类任务。文章详细介绍了EfficientNet架构的优势(B0-B7不同变体),提供了完整的安装指南和数据预处理流程。采用两阶段训练策略:先冻结预训练层训练顶层,再解冻部分层进行微调。重点讲解了层冻结策略、超参数选择等关键技术细节,并提供了训练流程说明和可视化方法。该项目展示了如何利用EfficientNet的高效特性,在特定分类任
月下花海白发少女
废墟、硝烟、机械腿、军装红瞳少女 CG 插画
本文介绍了C语言字符串操作的核心函数和实现方法,通过strings.c示例程序展示了字符串连接(strcat)、长度计算(strlen)、比较(strcmp)、复制(strcpy/strncpy)、查找(strchr/strstr)以及手动实现的大小写转换等操作。代码演示了如何安全处理字符串,包括缓冲区溢出防护和空字符处理。输出结果验证了各函数的正确性,并附带了字符串分割和反转的补充示例。该示例完