- @2401_84204207


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
低代码平台通过封装复杂技术细节,降低开发门槛,提升效率,实现智能体快速构建与可视化调试。其核心价值在于让非技术人员参与创新、加速原型验证、沉淀最佳实践,并支持企业级安全与扩展。主流平台如Dify(全栈式开源)、n8n(强连接自动化)、Coze(零代码友好)各具优势,分别适用于专业开发、流程集成与快速落地场景,助力创意高效转化为可运行的AI应用。
本文系统梳理了从零开始成为AI大模型应用开发工程师的学习路径,涵盖数学编程基础、机器学习、深度学习及大模型实战应用。强调通过理论学习与项目实践结合,掌握Transformer架构、RAG、Agent开发与模型微调等核心技术。虽提及“3个月速成”捷径,但核心仍倡导扎实积累与持续学习,助力从业者高效入行,把握高薪就业机遇。
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?答案只有一个:人工智能(尤其是大模型方向)当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应
下载安装后查看版本号安装成功!搜索具体参数可参照配置表自行选择出现success安装成功!

前面在4.中提到了Lora,我也曾在别的回答中提过Lora真是本世纪最美女名,因为真的是个人微调的一大福音。如果你想细致了解,可以看看这篇CW不要無聊的風格:当红炸子鸡 LoRA,是当代微调 LLMs 的正确姿势?我在这里也具体来讲讲:首先肯定是要搬上来这张图的:

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模

层归一化 Layer Norm 在 大语言模型 LLMs 中的不同位置 有什么区别么?如果有,能介绍一下区别么?在大语言模型(Large Language Models)中,Layer Norm(层归一化)可以应用在不同位置,包括输入层、输出层和中间隐藏层。这些位置的归一化有一些区别:输入层归一化:在输入层应用 Layer Norm 可以将输入的特征进行归一化,使得输入数据的分布更加稳定。这有助于

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

程序员35岁后,无人问津、被下岗,说到底还是中国互联网企业普遍短命和中国程序员新人不断涌现导致的,前者是岗位的缩减,后者是供应的增加,两者一叠加,35岁程序员就成了背锅侠。
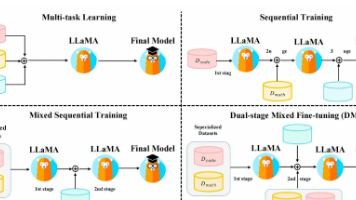
微调是一种有监督的技术手段,是在已具备广泛知识基础的大型预训练语言模型上,利用针对性的数据集实施额外的训练过程,旨在使模型更精准地契合特定任务需求或深入某一专业领域。微调的核心目标在于实现知识的精细化灌输与指令系统的精确匹配,所以 SFT 的重点是学习样式和指令,而非知识注入。当前实践中,微调主要分为全参数微调和部分参数微调,下面详细说一下这两个方式的特点和技巧。01 全参数微调有什么技巧?主要是