登录社区云,与社区用户共同成长
邀请您加入社区
OLAP引擎选型是业务需求技术特性与团队能力的精密平衡艺术。ClickHouse、Druid和Trino分别代表了极致性能实时聚合和统一查询三种技术路线,各有其适用的理想场景。核心选型原则性能匹配:根据延迟要求选择合适引擎,避免过度设计成本可控:综合考虑存储、计算和运维成本演进可行:选择有活跃社区和明确roadmap的技术架构灵活:为未来业务变化预留扩展空间成功实施关键渐进式采纳:从特定场景开始验
ClickHouse-driver是一个基于原生TCP协议的Python驱动,为高性能列式数据库ClickHouse提供完整功能支持。该项目支持丰富的类型系统,包括数值、日期时间、字符串和复合类型等核心数据类型。具有实用功能如外部数据查询、查询设置调整、数据压缩加密、流式结果返回等特性,适用于大规模数据分析场景。支持Python DB API 2.0规范,提供NumPy数组集成选项。安装便捷,使用
Apache Doris · ClickHouse 迁移 · DDL 转换 · Stream Load · 数据校验 · Colocate Join · 全栈实战 · 存算分离。
ClickHouse是由俄罗斯互联网巨头Yandex开发的一个用于实时分析的列式数据库。它的设计理念是为了满足现代互联网应用中对于大数据量、高并发查询的需求。与传统的关系型数据库不同,ClickHouse采用了列式存储结构,这使得它在执行聚合运算和其他类型的复杂查询时具有极高的效率。
本文介绍了ClickHouse中控制数据插入行为的两个关键参数:insert_distributed_sync(新版为distributed_foreground_insert)和async_insert。前者控制分布式表数据分片的同步/异步写入,确保强一致性但影响吞吐量;后者控制插入请求的批处理方式,提高吞吐量但牺牲实时性。文章详细对比了两者的作用机制、重要性及适用场景,并提供了全局配置、会话设
我们的 CI 系统在捕捉 Bug 方面表现优秀,尤其擅长在 AST Fuzzing、Stress(压力)测试和功能测试阶段捕获崩溃日志
但注意:mutation 通常不会显示在这里(因为它们由后台线程执行),更可靠的还是查。⚠️ 注意:这会终止 mutation,可能导致部分数据未删除,需要重新执行一次。中记录正在运行的查询,包括后台 mutation 任务。在 ClickHouse 中检查是否有 DELETE。ClickHouse 的删除操作本质上是一个。的记录,就说明删除任务仍在执行中。ClickHouse 也会在。系统表中查
ClickHouse中的Array(T)类型用于存储相同类型元素的有序集合。它支持字符串、数值等各类元素,语法为Array(T),如Array(String)。常见用途包括标签系统、多值属性和时间序列数据。插入时使用方括号[]表示数组,查询支持length()、arrayElement()等函数,arrayJoin()可将数组展开为多行。相比JSON,Array类型更高效且类型安全,适合存储同类型
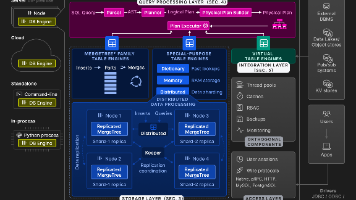
摘要:ClickHouse是一款由Yandex开发的列式存储OLAP数据库,采用MPP架构,适用于商业智能等分析场景。其核心特性包括多主架构、列式存储(提升查询性能和数据压缩率)、向量化执行引擎(利用SIMD指令加速计算)以及多样化表引擎(如MergeTree系列)。系统架构分为查询处理、存储和集成三层,支持灵活扩展和高效分析。作为当前领先的OLAP解决方案之一,ClickHouse特别适合实时海
是一个 Python 包(绑定库),提供 CityHash 哈希函数的实现,用于 ClickHouse 客户端或驱动在启用压缩/散列相关功能时计算哈希值或校验。错误提示的意思是你的程序需要这个包来支持压缩功能,但当前环境中没有安装它。是一个 Python 包(绑定库),提供 CityHash 哈希函数的实现,用于 ClickHouse 客户端或驱动在启用压缩/散列相关功能时计算哈希值或校验。Cit
通过datax将mysql导入到clickhouse中
Clickhouse数据库支持定义字段类型为Array,Array中可以定义基本类型为String,int等等,那么我们如何读取它呢,特别是我们在使用Java读取数据时,有写程序里面既有Mysql数据源,又有Clickhouse数据源,也有可能还有Redis,MangoDB等等,这种情况下,可能使用的连接串都是类似的,都是通过JDBC来连接这些数据源的。id Int32,cursor_name A
Druid 是由 MetaMarkets 开发、用于探索式实时分析数据的 OLAP 数据存储。它专为海量数据的实时摄入、存储和查询而设计,在实时性和高并发查询方面表现出色,被广泛应用于实时数据分析场景,如网站流量分析、用户行为分析等。
【代码】ClickHouse迁移Starrocks脚本工具。
本文详细介绍了在 Linux 系统上安装配置 Docker 和 ClickHouse 的完整流程,并实现了 MySQL 到 ClickHouse 的数据同步方案。在Linux上安装配置docker,然后再安装配置Clickhouse,然后在里面建立MySQL外部表和MergeTree内部表的详细步骤,写SQL代码全量和按表里的时间戳字段增量同步数据。这种架构适用于数据分析、实时报表等场景,充分发挥
本文介绍了如何将部署在阿里云上的ClickHouse数据库从系统盘迁移至专用数据盘的过程。首先需要购买并挂载数据盘到/home/data目录下,包括查看磁盘信息、格式化、挂载和配置自动挂载。然后详细说明了ClickHouse数据迁移步骤:停止服务、移动数据文件、设置权限、创建软链接,最后重启服务并进行验证。通过将数据迁移至专用数据盘,解决了系统盘空间不足的问题,提高了存储可扩展性。整个迁移过程需要
本文介绍了使用Docker部署3节点ClickHouse集群的完整流程。首先创建专用网络和配置文件目录,为每个节点配置不同的XML配置文件(主要修改宏定义部分)。然后启动ZooKeeper服务作为协调组件,接着分别运行3个ClickHouse节点容器,每个节点映射不同的端口并挂载对应的配置文件和数据目录。最后通过连接任意节点验证集群状态,并演示如何创建分布式表。整个部署过程涵盖了网络配置、容器编排
添加jdbc依赖 <dependency> <groupId>com.clickhouse</groupId> <artifactId>clickhouse-jdbc</artifactId> <version>0.4.6</version> </dependency> 将配置信息写到yml文件中 cl
原有数据库一直无法写入(too many part/ read only/ shard unavaliable)3 select from remote() 将老数据读取后写入新clickhouse集群中。1. 将原来的表结构从system.tables导出表结构。用于新服务上的表创建。2 在新集群上创建表。
分区键的选择直接影响数据分布的均匀性和查询效率。优先选择高频查询条件中的时间或枚举字段作为分区键,例如按天分区的日期字段。避免使用基数过高的字段,这会导致分区数量过多,增加元数据管理开销。合理设置分区粒度,过细的分区会降低批量写入效率,过粗的分区会导致查询扫描过多数据。物化视图应包含完整的聚合逻辑和过滤条件,并采用与源表相同的分区策略。ClickHouse的主键索引采用稀疏索引结构,默认每8192
通过以上策略,可显著提升 ClickHouse 在复杂查询和高并发场景下的性能表现。:10TB 日志表,按。
在实时分析场景中,通过「时间分区+低基数字段」的分区键设计和「预计算+流式更新」的物化视图,可提升查询性能5-50倍。关键是根据业务特征平衡分区粒度与物化视图维护成本,并持续监控系统表(如。
此方案可实现毫秒级响应千万级数据的多维度实时分析,QPS可达500+(单节点32核128GB配置)。
这种分层架构(热数据在 ClickHouse、冷数据在 OSS)是数据湖设计的常见模式,适用于大规模数据场景(如电商或 IoT)。它平衡了性能与成本,通过自动化工具实现无缝管理。实际部署时,建议结合云服务商的托管服务(如阿里云 DataWorks)简化运维。如果您有具体数据规模或工具链需求,我可以提供更定制化的建议!
text{数据源} \xrightarrow{\text{JDBC}} \text{DataEase} \xrightarrow{\text{可视化引擎}} \text{BI看板}DataEase 作为开源数据可视化工具,通过低代码方式集成 Hive/ClickHouse 可快速构建数据分析平台。通过以上流程,可在 2 小时内完成从数据源接入到可视化看板发布,大幅降低数据分析门槛。
工具验证配置变更效果,遵循"变更单参数-测试-记录"的迭代流程。
ClickHouse提供4类表引擎,分别支持不同场景。包括Log、MergeTree、Special、Integrations系列引擎。对各类引擎进行介绍和总结。最后举例说明建表的SQL脚本。
官方已经指出 Nullable 类型几乎总是会拖累性能,因为存储 Nullable 列时需要创建一个额外的文件来存储 NULL 的标记,并且 Nullable 列无法被索引。单个日志文件最大 1GB,保留 10 个文件 → 总日志量可达 10GB,可能占用过高磁盘空间。作用:自动将 WHERE 条件转换为 Prewhere,优先过滤数据再读取列,减少 I/O。是最详细的日志级别,记录所有操作(包括
【代码】用户行为分析:使用 ClickHouse 存储与查询亿级用户访问日志的优化技巧。
优化核心公式: $$ T_{query} = \frac{D_{scan}}{V_{disk}} + \alpha \cdot N_{row} \cdot C_{cpu} $$ 其中$\alpha$在24.3版本下降至原值的$0.35$分析执行计划,优先优化高代价算子(如。
<flat /> <!-- 内存布局:flat/hashed/cache --> <!-- 主键字段 -->
数学表达式描述增量效率: $$ \Delta T_{update} = O(\log n) $$ 其中$n$为新数据块大小,效率远高于全量更新$O(N)$ClickHouse物化视图(Materialized View)本质是。管理生命周期,可平衡实时性与存储成本。:在日志分析场景中,采用。
在 10 亿数据点环境下,该查询可在 800ms 内完成,满足实时监控需求。(例:5分钟粒度统计)
的组合在 ClickHouse 中能高效处理大规模统计任务,尤其适合实时分析场景。通过优化查询结构和利用 ClickHouse 的分布式特性,您可以实现毫秒级响应。记住,实际性能取决于数据分布和集群配置——建议从官方文档获取更多参数细节。是两个核心聚合函数,它们可以组合使用来实现高效统计,例如计算唯一用户的总消费额或满足特定条件的汇总值。在数据分析中,ClickHouse 以其高性能列式存储引擎著
预聚合,可实现订单数据的实时分析,在100亿数据量下保持95%查询响应时间<500ms。
Superset 是一个开源的数据可视化和商业智能(BI)工具,支持多种数据源,提供丰富的图表和仪表盘功能。ClickHouse 是一个高性能的列式数据库,专为大规模数据分析设计,特别适合离线数据仓库场景,能以毫秒级延迟处理复杂查询。将两者集成,可以实现对离线数仓数据的实时可视化查询,提升数据分析效率。ClickHouse 的高吞吐量和 Superset 的灵活可视化结合,能将查询响应时间控制在毫
例如:对时间序列数据按分钟聚合: $$ \text{SELECT} \quad \text{toStartOfMinute}(timestamp) \quad \text{AS} \quad \text{minute}, \quad \text{SUM}(value) \quad \text{FROM} \quad \text{source_table} \quad \text{GROUP BY}
通过合理配置分区键和排序键,MergeTree 引擎的查询性能可提升 $3\sim5\times$ ,同时降低 $40%$ 的存储空间占用。和系统表监控持续调优。
ClickHouse是由俄罗斯互联网巨头Yandex(相当于“俄罗斯谷歌”)于2016年开源的面向分析的列式数据库管理系统(Columnar OLAP DBMS),其设计目标是**“处理PB级数据,支持实时分析,提供秒级查询响应”**。截至2024年,ClickHouse已成为全球最受欢迎的OLAP引擎之一,被字节跳动、腾讯、美团、快手等国内互联网公司广泛应用于用户行为分析、实时报表、广告归因、物