
Clickhouse异步/同步写入配置详解
一、参数介绍
先看官网介绍关于数据insert分布式表的参数:
参数组1
-
distributed_foreground_insert
默认值:0
启用或禁用同步数据插入到 Distributed 表中。
默认情况下,当将数据插入到 Distributed 表中时,ClickHouse 服务器以后台模式将数据发送到集群节点。当 distributed_foreground_insert=1 时,数据将同步处理,并且只有在所有数据都保存在所有分片上(如果 internal_replication 为 true,则每个分片至少一个副本)后,INSERT 操作才会成功。
可能的值:
0 — 数据以后台模式插入。
1 — 数据以同步模式插入。 -
insert_distributed_sync
参数介绍跟distribued_foreground_insert一样,新版本的参数已经修改成distributed_foreground_insert,老版本的参数还是insert_distributed_sync。
客户端执行insert的参数
参数组2
- async_insert:是否异步执行insert语句
默认值: 0
如果为 true,则来自 INSERT 查询的数据存储在队列中,稍后在后台刷新到表中。如果 wait_for_async_insert 为 false,则 INSERT 查询几乎立即处理,否则客户端将等待直到数据刷新到表中 - wait_for_async_insert:是否等待异步执行语句返回
默认值: 1
如果为 true,则等待异步插入的处理完成。
注意:因为默认情况下async_insert参数和wait_for_async_insert参数是按照同步的方式进行配置,这里不单独进行设置。
区别
insert_distributed_sync和async_insert两个用于控制插入行为的参数,但它们在应用场景和机制上有重要区别。
先说结论:

insert_distributed_sync
作用:
- 当向分布式表(Distributed table)插入数据时,控制插入行为是同步还是异步。
- 默认情况下,insert_distributed_sync=0,即异步插入。这意味着数据先写入本地文件系统,然后再在后台异步地发送到集群分片。
- 设置为insert_distributed_sync=1时,插入操作将同步进行,即客户端会等待数据成功写入所有分片(或达到超时时间)后才返回。
重要性和影响:
- 数据一致性:同步插入可以确保在插入操作返回时,数据已经写入所有分片,从而保证强一致性。而在异步模式下,如果在后台发送数据之前发生故障,可能会导致数据丢失。
- 性能:同步插入会降低写入吞吐量,因为需要等待网络传输和所有分片的写入完成。异步插入则具有更高的吞吐量,因为客户端不需要等待后台操作。
- 超时控制:当使用同步插入时,可以通过insert_distributed_timeout参数设置等待超时时间,默认为180秒。如果超时,插入操作会失败。
使用场景:
- 当需要确保数据已经安全写入所有分片时,例如在关键业务数据插入时,可以使用同步插入。
async_insert
作用:
- 控制是否启用异步插入,该参数针对的是插入请求的处理方式,而不是分布式表的分片数据同步。
- 默认情况下,async_insert=0,即每个插入请求都会立即被处理
- 设置为async_insert=1时,ClickHouse会将插入请求排队,并定期批量处理它们。这可以减少小批量插入的频率,提高吞吐量。
重要性和影响:
- 吞吐量:异步插入可以将多个插入请求合并成一批,减少IO操作和表锁竞争,从而提高吞吐量。
- 延迟:异步插入会增加数据可见的延迟,因为数据不会立即被写入表中。
- 可靠性:异步插入存在一定的风险,如果在数据被刷新到磁盘之前服务器发生故障,可能会丢失部分数据。
使用场景:
- 适用于写入频繁、单次插入数据量小且对实时性要求不高的场景,例如日志数据插入。
从作用、重要性和影响、使用场景三个方面来看,
- insert_distributed_sync 针对分布式表的数据分片同步。async_insert 是针对插入请求的处理方式,不区分表类型(可以是本地表也可以是分布式表)。
- insert_distributed_sync 控制数据在集群分片间的同步写入。async_insert 控制是否将多个插入请求合并成批处理。
- insert_distributed_sync=1 保证数据同步到所有分片,强一致性。async_insert=1 可能会因为批量处理的延迟而导致数据不能立即可见,且存在故障时丢失数据的风险
- insert_distributed_sync=1 会降低分布式表插入的吞吐量,但保证一致性。async_insert=1 会提高插入吞吐量,但牺牲了实时性和一定的可靠性。
二、参数配置
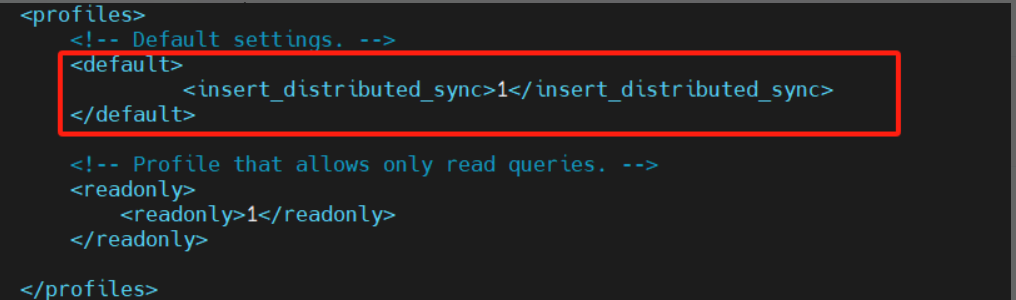
全局用户基本设置
users.xml配置文件里
<insert_distributed_sync>1</insert_distributed_sync>
会话基本session
hb3 :) set insert_distributed_sync=1;

SET insert_distributed_sync = 1

Query id: 5dbdce47-4f39-454f-b3f7-1940edd1070e

Ok.

0 rows in set. Elapsed: 0.001 sec.

hb3 :) select * from system.settings where name like '%insert_distributed_sync%' \G

SELECT *
FROM system.settings
WHERE name LIKE '%insert_distributed_sync%'

Query id: cdffefb5-d0e3-49d3-96b5-2da065e1332a

Row 1:
──────
name:        insert_distributed_sync
value:       1
changed:     1
description: If setting is enabled, insert query into distributed waits until data will be sent to all nodes in cluster.
min:         ᴺᵁᴸᴸ
max:         ᴺᵁᴸᴸ
readonly:    0
type:        Bool
default:     0
alias_for:

1 row in set. Elapsed: 0.003 sec.
JDBC连接设置insert_distributed_sync

import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
/**
 * @author duhj
 * @datete 2025/10/20 10:20
 */
public class ClickhouseUrlTest2 {
    public static void main(String[] args) throws Exception{
        Connection conn = DriverManager.getConnection("jdbc:clickhouse://hb3:8123/default?insert_distributed_sync=1"
        , "default", "wobushidashen");
        PreparedStatement ps = conn.prepareStatement("insert into test.log_test values(?,?)");
        for (int i = 0; i < 1000000; i++){

            ps.setInt(1, i);
            ps.setString(2, "xxx"+i);
            ps.execute();
            Thread.sleep(200);
        }
        ps.close();
        conn.close();
    }
}
URL:jdbc:clickhouse://hb3:8123/default?insert_distributed_sync=1
如果还有额外的参数利用&拼接即可。
例如:jdbc:clickhouse://hb3:8123/default?insert_distributed_sync=1&async_insert=0
三、扩展部分
-
源码1分布式表写入时consume方法解释
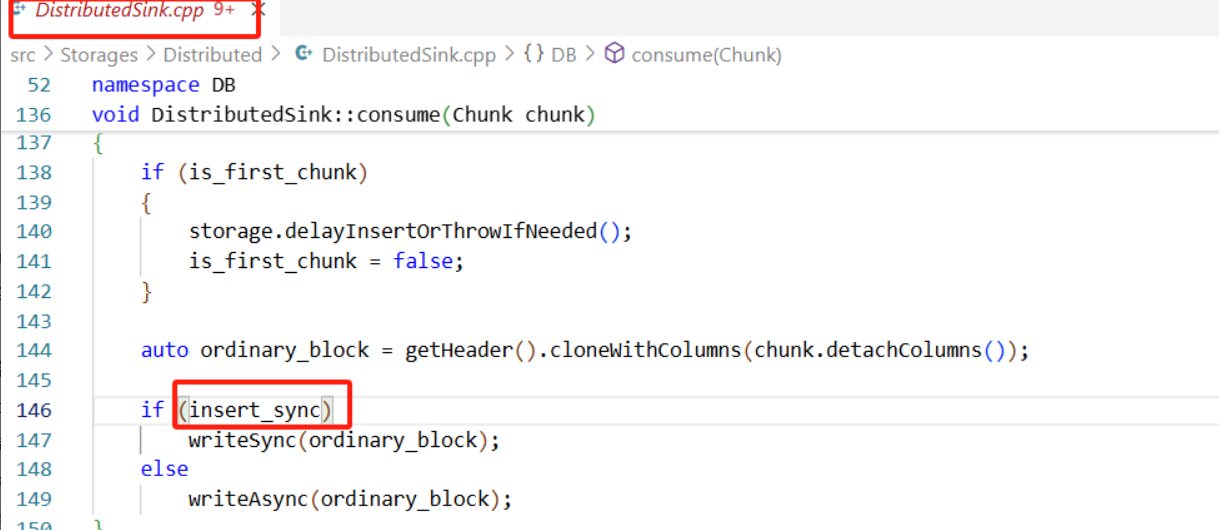
a.Processor 向 Sink 传入一个 Chunk(块),consume 做首块延迟策略检查然后决定同步/异步写入
b.首次 chunk 时调用 storage.delayInsertOrThrowIfNeeded()(可基于 local queue 大小延迟或抛错)
c.将 Chunk 转为 Block(使用 header)
d.如果 insert_sync 为 true 调用 writeSync,否则 writeAsync -
源码2同步写入block部分
作用:同步插入主逻辑,针对多个 shard/replica 并发发送并等待完成
void DistributedSink::writeSync(const Block & block)
{
    OpenTelemetrySpanHolder span(__PRETTY_FUNCTION__);
    获取基本配置信息
    const Settings & settings = context->getSettingsRef();
    const auto & shards_info = cluster->getShardsInfo();
    Block block_to_send = removeSuperfluousColumns(block);
    size_t start = 0;
    size_t end = shards_info.size();
    根据分片数计算star、end
    if (settings.insert_shard_id)
    {
        start = settings.insert_shard_id - 1;
        end = settings.insert_shard_id;
    }
    创建线程池pool
    if (!pool)
    {
        /// Deferred initialization. Only for sync insertion.
        initWritingJobs(block_to_send, start, end);
        如果分片键是random那么值=1,否则等于远程和本地任务总和
        size_t jobs_count = random_shard_insert ? 1 : (remote_jobs_count + local_jobs_count);
        最大线程数
        size_t max_threads = std::min<size_t>(settings.max_distributed_connections, jobs_count);
        计算最大线程数,取设置中的最大分布式连接数和任务数的最小值
        pool.emplace(/* max_threads_= */ max_threads,
                     /* max_free_threads_= */ max_threads,
                     /* queue_size_= */ jobs_count);

        限流器
        if (!throttler && (settings.max_network_bandwidth || settings.max_network_bytes))
        {
            throttler = std::make_shared<Throttler>(settings.max_network_bandwidth, settings.max_network_bytes,
                                                    "Network bandwidth limit for a query exceeded.");
        }
        重启计时器watch(用于监控整体时间)
        watch.restart();
    }
    重启当前块的计时器
    watch_current_block.restart();
    if (random_shard_insert)
    {
        start = storage.getRandomShardIndex(shards_info);
        end = start + 1;
    }
    size_t num_shards = end - start;
    span.addAttribute("clickhouse.start_shard", start);
    span.addAttribute("clickhouse.end_shard", end);
    span.addAttribute("db.statement", this->query_string);
    如果分片数量大于1,则创建选择器(selector)并为每个分片准备行号
    if (num_shards > 1)
    {
        auto current_selector = createSelector(block);

        /// Prepare row numbers for needed shards
        for (size_t shard_index : collections::range(start, end))
            per_shard_jobs[shard_index].shard_current_block_permutation.resize(0);

        for (size_t i = 0; i < block.rows(); ++i)
            per_shard_jobs[current_selector[i]].shard_current_block_permutation.push_back(i);
    }
    try
    {
        /// Run jobs in parallel for each block and wait them
        finished_jobs_count = 0;
        并行运行每个块的任务并等待
        for (size_t shard_index : collections::range(start, end))
            for (JobReplica & job : per_shard_jobs[shard_index].replicas_jobs)

                pool->scheduleOrThrowOnError(runWritingJob(job, block_to_send, num_shards));
    }
    catch (...)
    {
        pool->wait();
        throw;
    }
    try
    {
        waitForJobs();   等待所有分片执行完job
    }
    catch (Exception & exception)
    {
        exception.addMessage(getCurrentStateDescription());
        span.addAttribute(exception);
        throw;
    }
    更新插入的块数和行数
    inserted_blocks += 1;
    inserted_rows += block.rows();
}
a.准备 block_to_send(removeSuperfluousColumns)
b.延迟初始化 pool(线程池)和 throttler(如果尚未创建)。
c.计算 start/end(根据 settings.insert_shard_id 或 random_shard_insert)。
d.如果 num_shards>1:使用 createSelector 生成 selector 并为每个 shard 构造 shard_current_block_permutation。
e.对每个 shard 的每个 replicas_jobs 调用 pool->scheduleOrThrowOnError(runWritingJob(…)) 提交任务。
f.等待所有任务完成(waitForJobs),处理异常并补充状态信息。
g.成功后统计 inserted_blocks/inserted_rows。
- 源码3异步写入源码writeAsync
void DistributedSink::writeAsync(const Block & block)
{
    随机分片写入
    if (random_shard_insert)
    {
        writeAsyncImpl(block, storage.getRandomShardIndex(cluster->getShardsInfo()));
        ++inserted_blocks;
    }
    else
    {
        if (storage.getShardingKeyExpr() && (cluster->getShardsInfo().size() > 1))
            return writeSplitAsync(block);

        writeAsyncImpl(block);
        ++inserted_blocks;
    }
}
a.若 random_shard_insert 为 true:随机挑选一个 shard 并调用 writeAsyncImpl(block, shard_id)
b.否则:如果有分片键且集群分片 >1,则调用 writeSplitAsync(先按 selector 切分块);否则直接 writeAsyncImpl(block)
c.统计 inserted_blocks++
- 异步写实现源码部分
void DistributedSink::writeAsyncImpl(const Block & block, size_t shard_id)
{
    OpenTelemetrySpanHolder span("DistributedSink::writeAsyncImpl()");

    const auto & shard_info = cluster->getShardsInfo()[shard_id];
    const auto & settings = context->getSettingsRef();
    Block block_to_send = removeSuperfluousColumns(block);

    span.addAttribute("clickhouse.shard_num", shard_info.shard_num);
    span.addAttribute("clickhouse.written_rows", block.rows());

    if (shard_info.hasInternalReplication())
    {
        if (shard_info.isLocal() && settings.prefer_localhost_replica)
            /// Prefer insert into current instance directly
            writeToLocal(block_to_send, shard_info.getLocalNodeCount());
        else
        {
            const auto & path = shard_info.insertPathForInternalReplication(
                settings.prefer_localhost_replica,
                settings.use_compact_format_in_distributed_parts_names);
            if (path.empty())
                throw Exception("Directory name for async inserts is empty", ErrorCodes::LOGICAL_ERROR);
            writeToShard(block_to_send, {path});
        }
    }
    else
    {
        if (shard_info.isLocal() && settings.prefer_localhost_replica)
            writeToLocal(block_to_send, shard_info.getLocalNodeCount());

        std::vector<std::string> dir_names;
        for (const auto & address : cluster->getShardsAddresses()[shard_id])
            if (!address.is_local || !settings.prefer_localhost_replica)
                dir_names.push_back(address.toFullString(settings.use_compact_format_in_distributed_parts_names));

        if (!dir_names.empty())
            writeToShard(block_to_send, dir_names);
    }
}
更多推荐
 9
 0
- 0


 已为社区贡献9条内容

所有评论(0)