


- @weixin_55843921


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
这里介绍会用两个生成模型,一个是生成模型G用来捕捉数据分布,一个是辨别模型D用来估计一个样本到底是从(真实)训练数据来的还是从G生成来的。G的任务就是尽量让D犯错。如果G和D是一个MLP的话就可以通过误差反传来进行训练,并且不需要用到马尔可夫链。
β就相当于第一个公式里的w,如果只有一个样本,看起来是向量,但如果样本是n个,那就是矩阵了,这个X的第一行乘以w1一直到wn,w0,乘完以后就可以得到y1到yn,y0。在机器学习中模型要保存为pkl格式的文件,它的保存和加载使用joblib.dump(),机器模型的上线就只需要把这个模型加载然后predict就行了。在回归问题中是无法看准确率的,因为预测的时候比如就一条线,那如果点不在线上面就不标
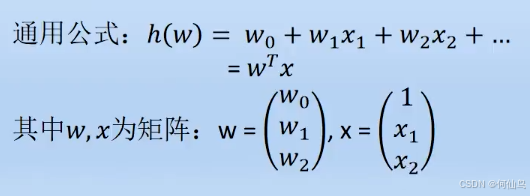
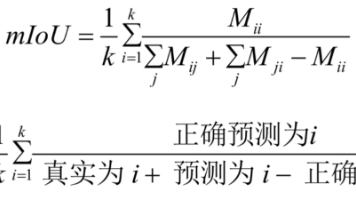
指所有被正确分类的像素所占比例表示被标注为类i,但被预测为类j的像素数量(总像素),表示预测正确的像素数量。
是一种改进的循环神经网络(RNN),专为解决传统RNN的(梯度消失/爆炸)而设计。其核心是通过动态控制信息的流动。

比如机器学习算法对训练数据中的噪声、离群点不敏感,或者在不同分布的数据集上表现稳定。模型在含有错误标签或噪声特征的数据上训练或预测时,性能下降不大。模型不易被精心设计的微小扰动(对抗样本)欺骗而做出错误预测。模型在训练数据分布以外的数据上依然有较好的表现。
"""一个用于图像分类的卷积神经网络(CNN)模型""""""初始化CNN模型结构Args:activation: 激活函数类型,可选"relu"或"selu""""# 设置激活函数# 卷积层定义# 输入形状: (batch_size, 1, 28, 28)self.conv1 = nn.Conv2d(in_channels=1, out_channels=32, kernel_size=3, p
self.rnn = nn.RNN(embedding_dim, hidden_dim, num_layers=num_layers, batch_first=True, bidirectional=bidirectional) #bidirectional是双向的#把final_hidden去除轴size为1的,和x进行比较,里边元素是否相等# 取最后一个时间步的输出 (这也是为什么要设置pad

BPE:这是一种流行分词算法,可以有效的平衡词汇表大小和步数,分词采用共现性。步骤:1.准备足够大的训练语料2.确定期望的subword词表大小(超参)3.将单词拆分为字符序列并在末尾添加后缀"</w>",这样就可以统计单词频率。比如一开始有一个l字母,现在编程l</w>5,就说明出现了五次。停止符</w>的意义在于表示subword是词后缀。每次合并后词表可能出现三种变化:+1:表明加入合并后的
是一种改进的循环神经网络(RNN),专为解决传统RNN的(梯度消失/爆炸)而设计。其核心是通过动态控制信息的流动。
"""一个用于图像分类的卷积神经网络(CNN)模型""""""初始化CNN模型结构Args:activation: 激活函数类型,可选"relu"或"selu""""# 设置激活函数# 卷积层定义# 输入形状: (batch_size, 1, 28, 28)self.conv1 = nn.Conv2d(in_channels=1, out_channels=32, kernel_size=3, p