- @weixin_51350847


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
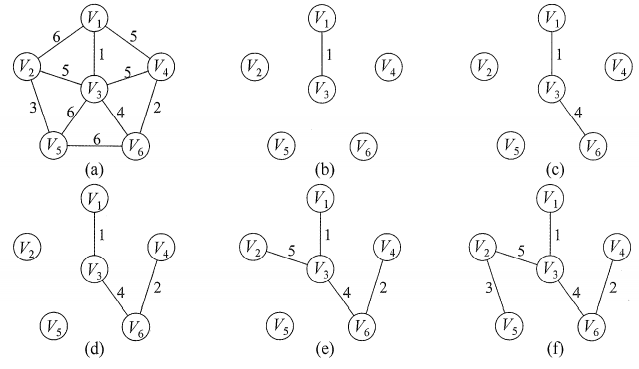
它的基本思想是:生成树中所有顶点必然是连通的,所以两个不相交集必须连接起来才能构成生成树,而且所选择的连接边的权重必须最小,才能得到最小生成树。若(u,v)是一条具有最小权值的边,其中u∈U, v∈V-U,则必存在一棵包含边(u,v)的最小生成树。如果使用 O(mlog m) 的排序算法,并且使用 O(mα(m,n)) 或 O(mlog m) 的并查集,就可以得到时间复杂度为 O(mlog m)
三、线索二叉树1.原理&作用2.存储结构创建线索二叉树3.二叉树线索化3.1中序线索化❗中序线索化代码头结点3.2先序、后序线索化❗前序线索化代码❗后序线索化代码4.根据线索二叉树找前驱后继4.1中序4.2先序4.2.1先序后继4.2.2先序前驱4.3后序4.3.1先序前驱4.3.2后序后继❗线索二叉树代码C

【规范】在并发环境下(多道程序环境中),各进程因竞争有限的资源而造成的一种互相等待对方手里的资源,导致各进程都阻塞,都无法向前推进的现象,就是“死锁”。发生死锁后若无外力干涉,这些进程都将无法向前推进。。可能是只有一个进程“饥饿”。【规范】由于长期得不到想要的资源,某进程无法向前推进的现象。比如:在短进程优先(SPF)算法中,若有源源不断的短进程到来,则长进程将一直得不到处理机,从而发生长进程“饥

前面共存储有 1 + 2 + 3 + 4 + 5 + 6 + 1 = 22 个元素 ( 数组下标范围为0 ~ 21 ),注意数组下标从 0 开始,故。n(n+1)/2+1] 中,则存放到 B[k] 中的非零元素。+ (n - j + 2) = (j-1)(2n - j + 2) / 2 个元素,,矩阵 M 的第一行有 12 元素,第二行有 11 个,第三行有 10 个,第四行有 9 个,第五行有

显然边集数组关注的是边的集合,在边集数组中要查找一个顶点的度需要扫描整个边数组,效率并不高。结合起来,解决了存储时候,有冗余的问题,也更容易求得顶点的出度和入度。若要删除左图的( V0 , V2 )这条边,需要对邻接表结构中右边表的阴影两个结点进行删除操作,显然这是比较烦琐的。eg. 如果要删除一条边,那么在邻接表中,要在两个顶点(边的两端点)的单链表中进行边的删除。ilink 指向依附顶点ive

由于非网图它没有边上的权值,所谓的最短路径,其实就是指两顶点之间经过的边数最少的路径。对于网图来说,最短路径,是指两顶点之间经过的边上权值之和最少的路径,并且我们称路径上的第一个顶点是源点,最后一个顶点是终点。【技巧】不带权值图其实就是一直特殊的带权图,只是权值都是1。通过一次遍历,就得到了每个结点到源点的距离。所以求最短路径的代码可以通过BFS遍历得到:3.2 迪杰斯特拉(Dijkstra)算法

哈夫曼树(Huffman Tree):在含有n个带权叶子节点的二叉树中,其中带权路径长度(WPL)最小的二叉树称为哈夫曼树,也称最优二叉树。例如,在上图求WPL的四棵树中,都是4个同样权值的叶子节点,中间两棵树的WPL最小,那么它们两个就是哈夫曼树。。3.哈夫曼树和哈夫曼编码3.1带权路径长度3.2哈夫曼树的定义和原理3.3哈夫曼树的构造代码实现3.4特点3.5哈夫曼编码压缩比代码实现3.6哈夫曼

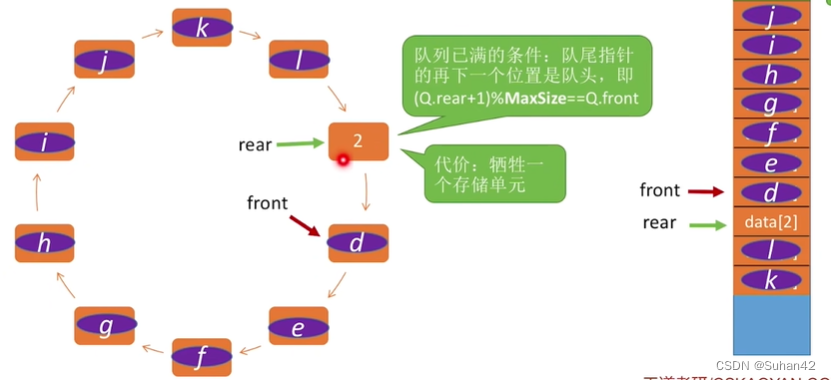
入队和出队的复杂度:在循环队列中,入队和出队操作的时间复杂度都是O(1),即常数时间复杂度。:循环队列将队列的头部和尾部连接起来形成一个环状结构,当队列的尾部指针达到数组的最末尾时,它将会绕回到数组的开头。:循环队列拥有固定的容量,即队列最多可以存储的元素数量是预先确定的。这里就必须空出一个元素的位置,不能让Q.rear==Q.front,因为这样,就和判空的条件一样了。重要术语:队头(可以出队(
markdown中数学公式的编辑其实和LaTeX中一样,所以这篇文章既可以作为markdown中数学公式的编辑的入门,也可以作为LaTeX的入门。一般公式分为两种形式,可以理解为一种特殊的代码块,Γz∫0∞tz−1e−tdt行公式,是在代码块的基础上前面加上,后面加上组成的。而块公式则是 输入$$和$$在公式前后。
用户定义完整性是针对某一个具体关系的约束条件。它反映的某一个具体应用所对应的数据必须满足一定的约束条件。例如,某些属性必须取唯一值,某些值的范围为0-100等。例如:学生(学号,姓名,课程号,性别,…)课程(课程号,课程名,学分);选修(学号,课程名,成绩)如这里学生的性别只能取“男”,“女”学分只能取1-…分成绩只能取1-100分数据库及数据仓库模型设计的三个主要步骤概念模型设计 , 逻辑模型设