


- @weixin_44931681


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
1.Hive1.nvl函数nvl函数:空值转换函数函数形式:nvl(expr1,expr2),类似于mysql-nullif(expr1,expr2)作用:将查询为Null值转换为指定值。若expr1为Null,则返回expr2,否则返回expr1。适用于数字型、字符型和日期型,但是expr1和expr2的数据类型必须为相同类型。转载自NVL函数NVL函数的格式如下:NVL(expr1,expr2
在现实情况中,用户代码错误不断,进程奔溃,机器故障等等。使用hadoop的好处之一就是可以它能处理这类故障并成功完成任务。需要考虑的实体失败任务为:任务(job),Application Master,NodeManager和ResourceManager。1.任务失败1.1 可能存在以下情况:MapTask或者ReduceTask中由于代码原因抛出异常,jvm在关闭之前,会通知mrAppMast
布隆过滤器(Bloom Filter)是一种空间效率极高的概率型数据结构,用于判断一个元素是否在一个集合中。快速判断元素是否存在可能存在误判(假阳性),但不会漏判(假阴性)占用空间小,适合大规模数据去重、过滤布隆过滤器是一种用空间换时间的高效数据结构,适合快速判断元素是否存在于大规模集合中,缺点是存在一定误判率,且传统版本不支持删除。布隆过滤器是一种高效的概率型数据结构,适合大规模数据去重和快速判
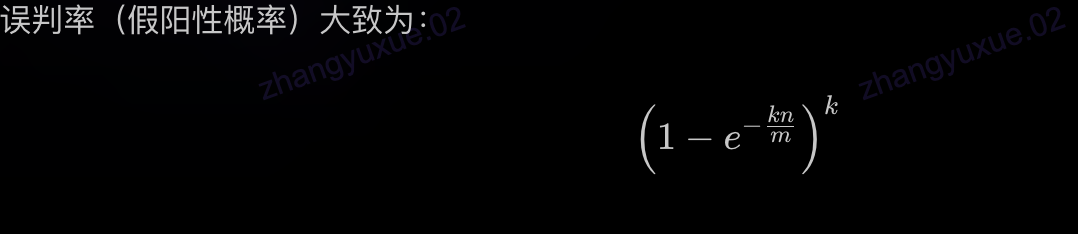
先逐一拆解每个概念的本质,明确其“做什么”和“解决什么问题”。想“用数据解决业务问题”?这是数据科学的范畴;想“让机器自动分析数据,不用写死规则”?这需要机器学习;数据是“图片、语音、文字”等复杂类型?需要深度学习来搞定;深度学习靠什么实现?靠神经网络这个“骨架”来搭建多层结构。理解它们的层级和协同关系,就能清晰判断:面对一个问题时,该用哪个技术,以及它们如何配合。
先逐一拆解每个概念的本质,明确其“做什么”和“解决什么问题”。想“用数据解决业务问题”?这是数据科学的范畴;想“让机器自动分析数据,不用写死规则”?这需要机器学习;数据是“图片、语音、文字”等复杂类型?需要深度学习来搞定;深度学习靠什么实现?靠神经网络这个“骨架”来搭建多层结构。理解它们的层级和协同关系,就能清晰判断:面对一个问题时,该用哪个技术,以及它们如何配合。