- @weixin_44617651


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Python是最受欢迎的爬虫语言之一,因为它易于学习和使用,有大量的库和框架可供选择。JavaScript通常用于Web爬虫,因为它可以直接在浏览器中运行,可以轻松地从动态网站中提取数据。java是一种广泛使用的语言,它有很多强大的库和框架,可以用于爬虫。

将静态文件存放在单独的目录中,使得 Django 可以有效地提供这些静态资源,如图片、CSS 文件、JavaScript 文件等,给用户的浏览器。在部署项目时,可以通过收集静态文件到一个单独的目录,然后将该目录服务于静态文件的 Web 服务器或者 CDN,从而更轻松地部署静态文件。那么对于在使用中我们经常遇到的问题,可以尝试着我这种解决方法。

在 Python 中,使用正则表达式可以非常方便地从字符串中提取浮点数。Python 的 re 模块提供了正则表达式支持。下面是如何使用正则表达式提取浮点数的示例。

为了便利化使用selenium驱动浏览器进行操作,遇到一个网页,大部分内容都是通过xhr请求后再通过前端js处理显示,带来的一个问题就是,采用显示等待无法准确的定位到需要的节点。因此,需要考虑采用判断xhr请求是否完成后再进行定位,或者直接获取xhr请求返回内容的做法。
对于大型的爬虫项目,肯定需要有良好的反爬机制,还应该配合代理iP使用,只有这两种结合才能让你的爬虫更高效准确。今天我就借用我一点空闲时间,来谈一谈有关python爬虫网络方面的解决方案,这里提供内网穿透和端口转发两种模式。
还记得我刚学Python爬虫那会儿,天真地以为几行requests加BeautifulSoup就能走天下。结果迎面撞上反爬机制、频繁被封IP、页面结构一变代码就崩……踩过无数坑后我才明白,写出健壮的爬虫不仅是技术活,更是对耐心和细心的考验。今天我想分享这些用教训换来的经验,希望能帮你少走些弯路。
Shell作为自动化脚本的利器,在爬虫领域展现独特价值。它虽不擅长复杂页面解析,却是卓越的流程调度器。通过巧妙组合curl、jq、pup等工具,Shell能构建高效数据采集流水线。其优势在于轻量级调度、系统无缝集成和简洁的文本处理,特别适合API数据抓取和定时爬取任务。
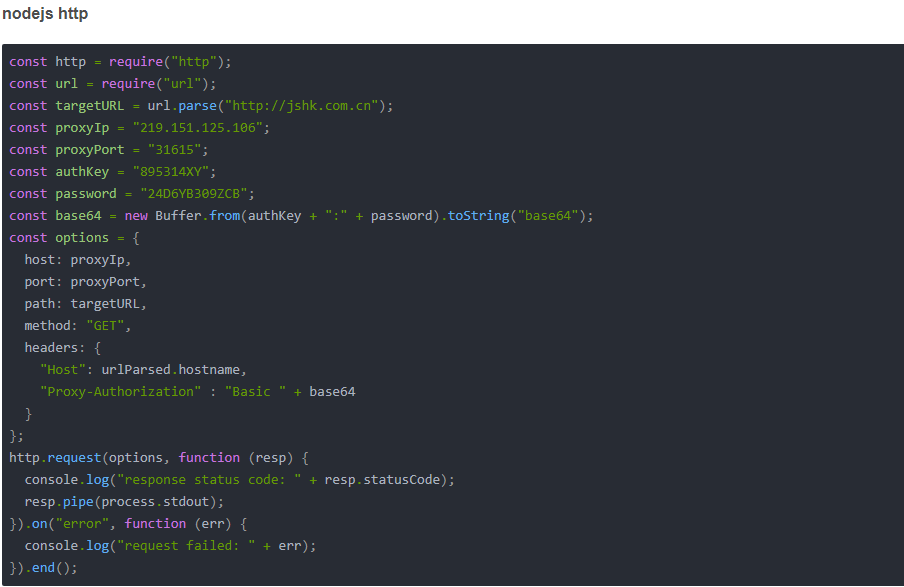
作为一名程序员,你是否曾遇到过爬虫IP被频繁封禁的困扰?在日常数据采集任务中,我们常常需要面对网站的反爬机制。使用Selenium配合隧道代理成为了一种有效的解决方案。本文将手把手教你如何搭建稳定的爬虫系统,让你的数据采集工作更加高效顺畅,不再为IP限制而烦恼。
Perl 虽然不像 Python 那样是当今爬虫领域的绝对主流,但它凭借其独特的优势,在特定场景下与爬虫结合能碰撞出非常惊艳的火花,尤其是在文本处理、快速原型、系统集成和遗留系统维护方面
竞品分析爬虫通常用于抓取竞争对手网站的产品信息、价格、评论等数据,以便进行市场分析。我们首先需要明确竞品分析的目标。并做重要的分析。根据项目自身结构特点然后总结一套可行性方案。