


- @solihawk


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
MySQL分库分表可以通过中间件Mycat实现,本文简要介绍了Mycat的几种分片策略mode、range和hash,并分别进行测试验证
百度研发的知识增强大语言模型,中文名是文心一言,英文名是ERNIE Bot。我能够与人对话互动,回答问题,协助创作,高效便捷地帮助人们获取信息、知识和灵感
TiDB中的SQL计算层TiDB Server会解析客户端的SQL请求并进行逻辑和物理上的优化,生成执行计划。本文简要介绍TiDB中的几种执行计划,了解不同算子在Explain中的输出信息。
MyCAT原理MyCAT主要是通过对SQL的拦截,然后经过一定规则的分片解析、路由分析、读写分离分析、缓存分析等,然后将SQL发给后端真实的数据块,并将返回的结果做适当处理返回给客户端。
ProxySQL是基于MySQL的一款开源的中间件的产品,是一个灵活的 MySQL代理层,可以实现读写分离,支持Query路由功能,缓存查询结果、故障切换和一些SQL的过滤功能。
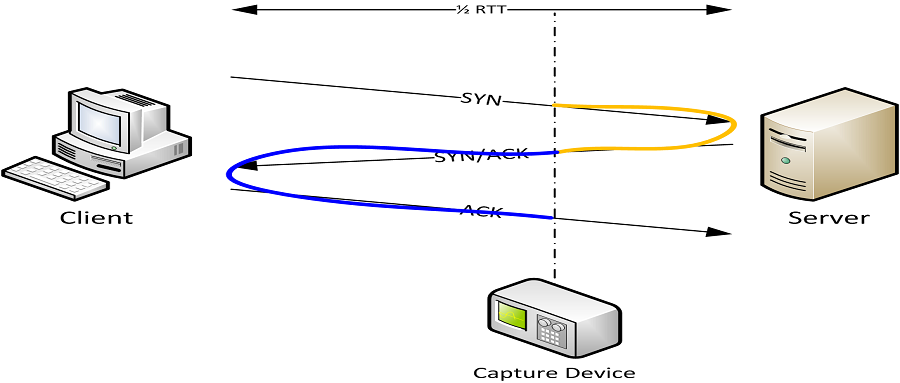
RTT是衡量网络传输性能的重要指标之一,能够反映出数据在网络中传输的速度和稳定性。通常情况下,RTT越短,网络传输的速度就越快,反之则越慢。因此,通过监测TCP中的RTT时延,可以初步判断网络的性能如何。但需要注意的是,RTT时延只是一个指标,要全面评估网络性能还需要结合其他指标进行综合分析。
Spark Streaming是构建在Spark上的实时流计算框架,可以进行实时流数据处理。本文简要介绍了Spark Streaming的基本概念和基本算子的使用。
本文主要介绍Spark通过PyMySQL和API算子对外部数据库MySQL和HBASE的读写操作
Spark大数据分析中涉及到RDD、Data Frame和SparkSQL的操作,本文简要介绍三种方式在数据统计中的算子使用。
Spark作为一种大数据分布式计算框架,已经构建Spark Streaming、Spark SQL、Spark ML等组件,与文件系统HDFS、资源调度YARN一起,构建了Spark生态体系。