- @qq_71257020


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
《物流大数据平台架构设计与实践》摘要: 物流行业数字化转型面临海量数据处理挑战,日均千万级订单和实时轨迹追踪需求催生了新一代大数据平台建设。该架构采用分层设计:数据采集层通过Kafka实现业务解耦;存储层融合HDFS、ClickHouse等组件满足不同场景;计算层基于Flink实现实时预警,Spark处理离线分析。技术选型注重高吞吐与低延迟,如Kafka3.4+Flink1.17组合。特别针对物流
本文结合企业依托集团技术底座、小团队运维的现状,论证轻量化数据中台落地可行性。企业无需重构底层基座,核心聚焦业务数据资产中台建设。针对现存数据质量差、指标口径混乱、取数低效、数据争议频发等痛点,依托现有业务数据基础,采用先落地业务价值、后规范建模的迭代思路,通过数据治理、统一口径、搭建OneData体系,实现低成本、轻量化的数据中台落地。
摘要:指标体系在借鉴阿里OneData方法论时遭遇三大挑战:1)修饰词与维度边界模糊,通过SQL语法(WHERE条件为修饰词,GROUP BY为维度)实现清晰划分;2)命名规范与业务可读性冲突,采用"规范英文名+中文注释+BI层映射"的折中方案;3)口径统一后使用方不认可,通过指标卡片、自动校验SQL和口径代码化推动落地。最终87个指标精简优化,23个重复口径合并,11个同名异义指标统一。实践表明
数据中台分层架构中常见的越权问题:ODS层擅自做业务映射导致历史数据无法修改,DW层越权JOIN维度表使DWD层失去作用,DWD层顺手聚合引发DWS层直接COPY数据,最终导致ST层绕过DWS直接查询DWD产生数据不一致。文章提出三条核心禁令解决分层混乱:ODS禁止业务映射、DWD禁止聚合、ST禁止直接查询DWD。通过明确各层职责边界(ODS原样接入、DW去重标准化、DWD维度JOIN、DWS聚合
数据质量校验的三大陷阱与应对策略 摘要:本文通过真实案例揭示了数据质检中的常见漏洞:1)默认值变更导致空值检测失效;2)业务新增枚举值未被覆盖;3)历史数据删除未被发现。作者总结出质检规则需从"有没有"升级到"对不对",提出分级质检方案:核心表强依赖阻断、非核心表弱依赖告警,并强调业务规则需由业务方定义。最终指出数据质检的本质矛盾——数仓掌握技术规则但不懂业务逻辑,业务方了解逻辑却不愿参与规则制定
文章摘要:本文探讨了数据中台血缘关系建设的实践与挑战。作者通过排查报表数据问题的案例,揭示传统血缘系统仅展示物理依赖关系而无法有效定位影响范围的痛点。针对字段映射混乱、全局血缘视图信息过载等问题,团队创新性地采用逐层展开的交互方式,分离前置/后置血缘存储,通过SQL解析+人工兜底实现1362张表的自动化维护。最终形成的解决方案聚焦核心需求——快速评估数据变更影响,在完整性和可用性间取得平衡,使血缘
实时数仓中Flink多表JOIN状态爆炸问题及分层治理方案 问题描述:一个出库包裹实时任务因10表JOIN导致状态从几百MB暴涨至12GB,引发Checkpoint过大和RocksDB写入阻塞。初期通过设置TTL(10天或30天)尝试解决,但面临数据丢失或内存爆炸的两难局面。 根因分析:问题源于Regular JOIN机制需永久保存两侧状态,10表JOIN导致状态数据指数级增长。TTL仅作为补救措
本文分析了Flink多表JOIN导致状态爆炸的问题及解决方案。作者在处理10张MySQL CDC表关联的实时任务时,发现状态从几百MB暴涨至12GB。问题根源在于Regular JOIN会永久保存中间状态,TTL设置面临两难:太小会导致数据丢失,太大则内存爆炸。 Flink 2.1提出的MultiJoin方案通过"零中间状态"设计(用计算换存储)从根本上解决问题,但当前生产环境(Flink 1.1
本文分析了Flink多表JOIN导致状态爆炸的问题及解决方案。作者在处理10张MySQL CDC表关联的实时任务时,发现状态从几百MB暴涨至12GB。问题根源在于Regular JOIN会永久保存中间状态,TTL设置面临两难:太小会导致数据丢失,太大则内存爆炸。 Flink 2.1提出的MultiJoin方案通过"零中间状态"设计(用计算换存储)从根本上解决问题,但当前生产环境(Flink 1.1
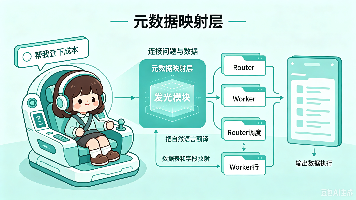
本文介绍了如何在Router+Worker架构中实现元数据映射功能。架构设计将映射层放在Skill Worker中,Router仅负责意图识别。具体实现分为三步:1) 表管理,通过配置表结构和字段描述划定LLM的知识边界;2) 术语词典,解决业务术语与数据库字段的映射问题;3) 表关联关系,提供跨表查询的JOIN规则。文中给出了Python代码示例,展示了如何在Worker中注入表结构上下文、处理