- @qq_60245590


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
判断两棵二叉树是否同构(递归法)输入两行字符序列先序递归构建两棵二叉树。每个字符对应一个树节点,#表示空节点。输出样例:同构输入1,否则输入0。题解:感觉在PTA上,这道题的测试样例是有错误的,当时学的时候同构二叉树要求结构相同且元素相同,下面是定义:两棵二叉树被称为同构二叉树,当且仅当它们具有相同的结构,即它们的节点位置和连接方式完全相同。换句话说,如果可以通过对其中一个树的节点进行一系列的左右

它不需要依赖物品本身的内容特征(如笔记的文字、图片),也不需要用户的显式属性(如年龄、职业),仅通过 “用户 - 物品” 的互动行为数据即可工作。
)#以上为简单的tf八股模板,可以看B站的北大老师曹健的tensorflow笔记#这里设置优化器,损失函数以及metrics#设置优化器为Adam优化器#设置损失函数为交叉熵损失函数#模型评估plt.show()上述代码使用TensorFlow和Keras构建了一个简单的卷积神经网络模型(CNN),并在CIFAR-10数据集上进行训练和评估。代码概要:1. 导入所需的库:tensorflow、nu

使用大模型生成SFT精调格式数据。

【代码】langchain Agent——RAG。
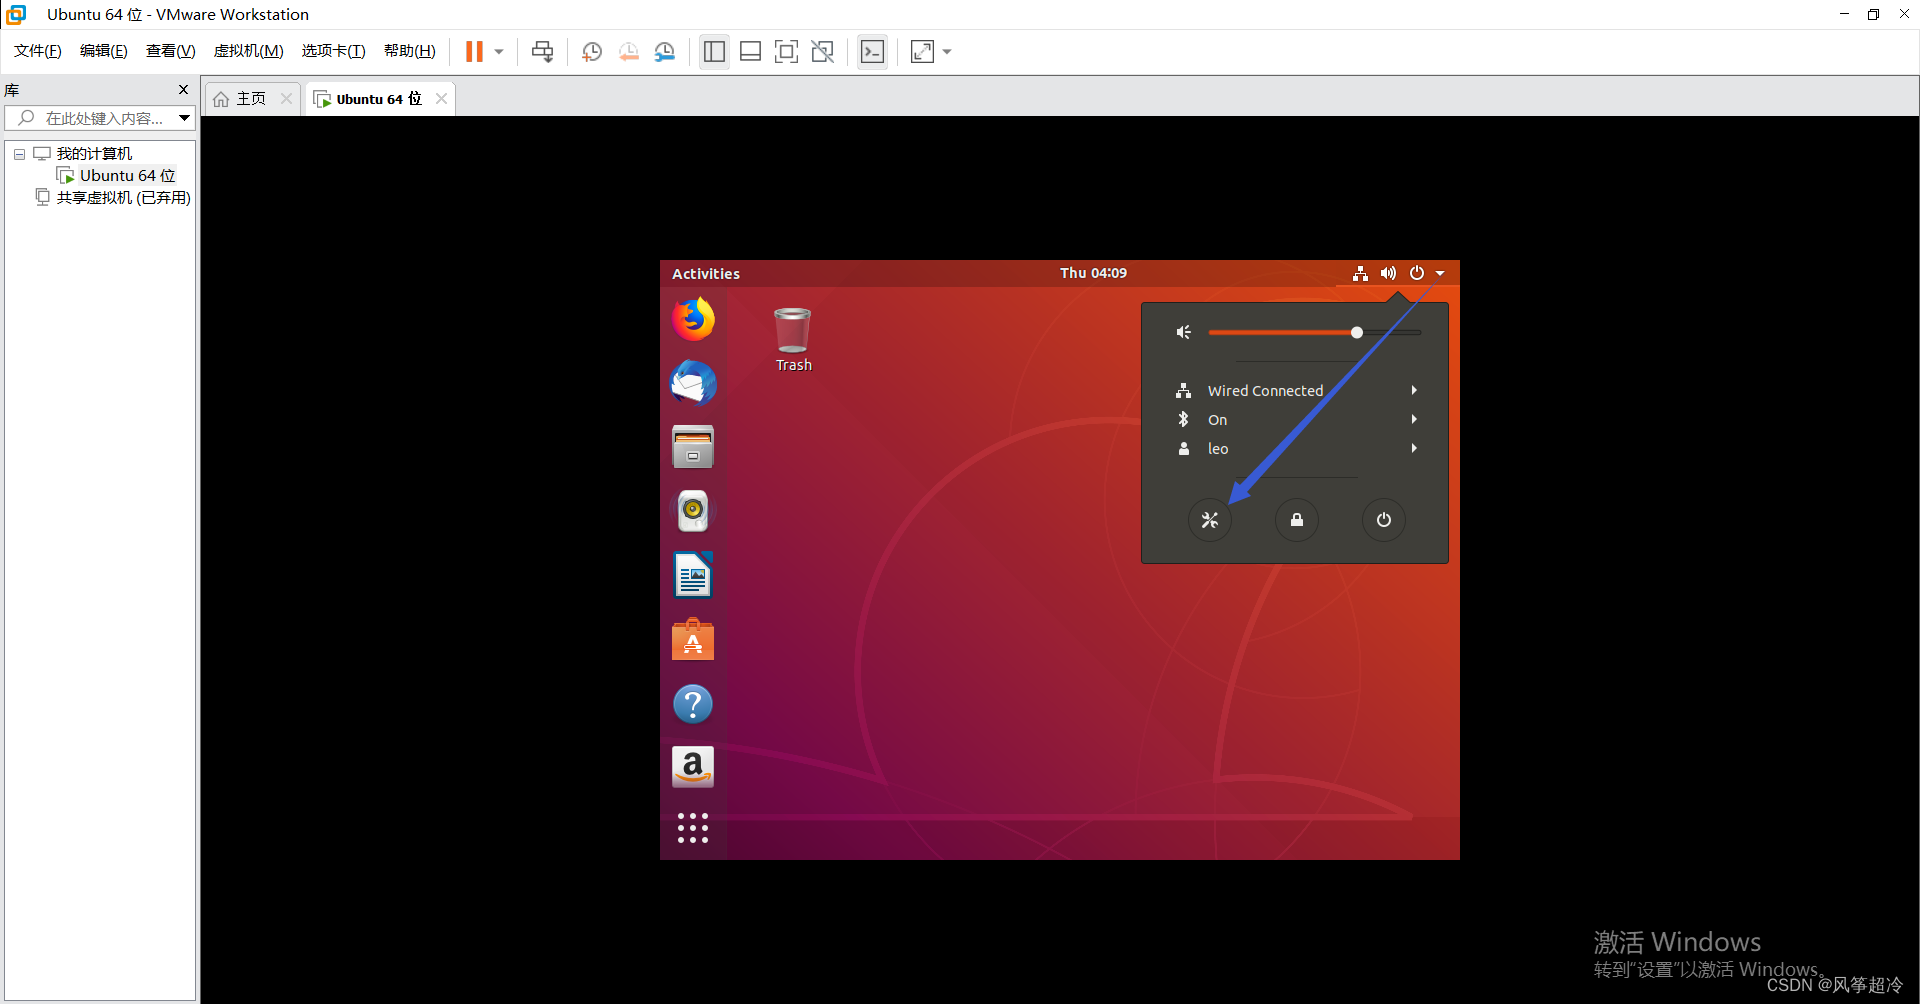
Xshell安装Ubuntu (Xshell连接前,确保已安装ssh)下一步记得 勾选 记住用户名 记住密码。ctr + C 退出ping命令。选择适合自己电脑大小的分辨率。vim按安装同上述步骤。执行 ifconfig。安装 ssh vim。
分析用户“1000113200000151566”常去的加油站点和通常的加油时间;数据集介绍:该表记录了用户在11月和12月一天24小时内的加油信息,包括:持卡人标识(cardholder)、卡号(cardno)、加油站网点号(nodeno)、加油时间(opetime)、加油升数(liter)、金额(amount)统计17:30~18:30期间加油的人数和平均加油量,以及该时间段的加油总量在一天中
2.torchvision.models: 包含常用的模型结构(含预训练模型),例如AlexNet、VGG、ResNet等;1.torchvision.datasets: 一些加载数据的函数及常用的数据集接口;4.torchvision.utils: 其他的一些有用的方法。
3. 使用 `image_dataset_from_directory` 函数加载数据集,并设置了一些参数,如 `validation_split`(指定验证集比例)、`subset`(选择训练集或验证集)和 `seed`(随机数种子),以及图像的大小。2. 定义了图像的批处理大小 `batch_size`,以及图像的高度 `img_height` 和宽度 `img_width`。`val_los

Dify 项目结构近期有变化导致 requirements.txt被替代为~/dify/api 目录下 pyproject.toml 文件,这说明 Dify 后端现在采用了新的 Python 包管理方式(PEP 517/518 标准),通常用 pip 或 poetry、uv、pipx 等工具来安装依赖。如果 api 目录下没有 .env.example,你可以手动创建 .env 文件,内容参考前述