- @qq_37655607


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
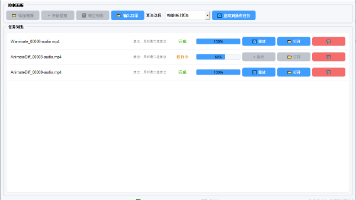
本文介绍了一个基于Python和PyQt5开发的视频音频提取工具,通过图形化界面简化了FFmpeg的音频提取操作。该工具支持WAV、FLAC、MP3等多种音频格式输出,具备任务队列管理、批量处理、进度反馈等功能。采用QThread+Worker模式实现异步处理,避免界面卡顿,并适配Windows/macOS/Linux系统,提供文件定位功能。程序启动时会自动检测FFmpeg环境,降低用户使用门槛。
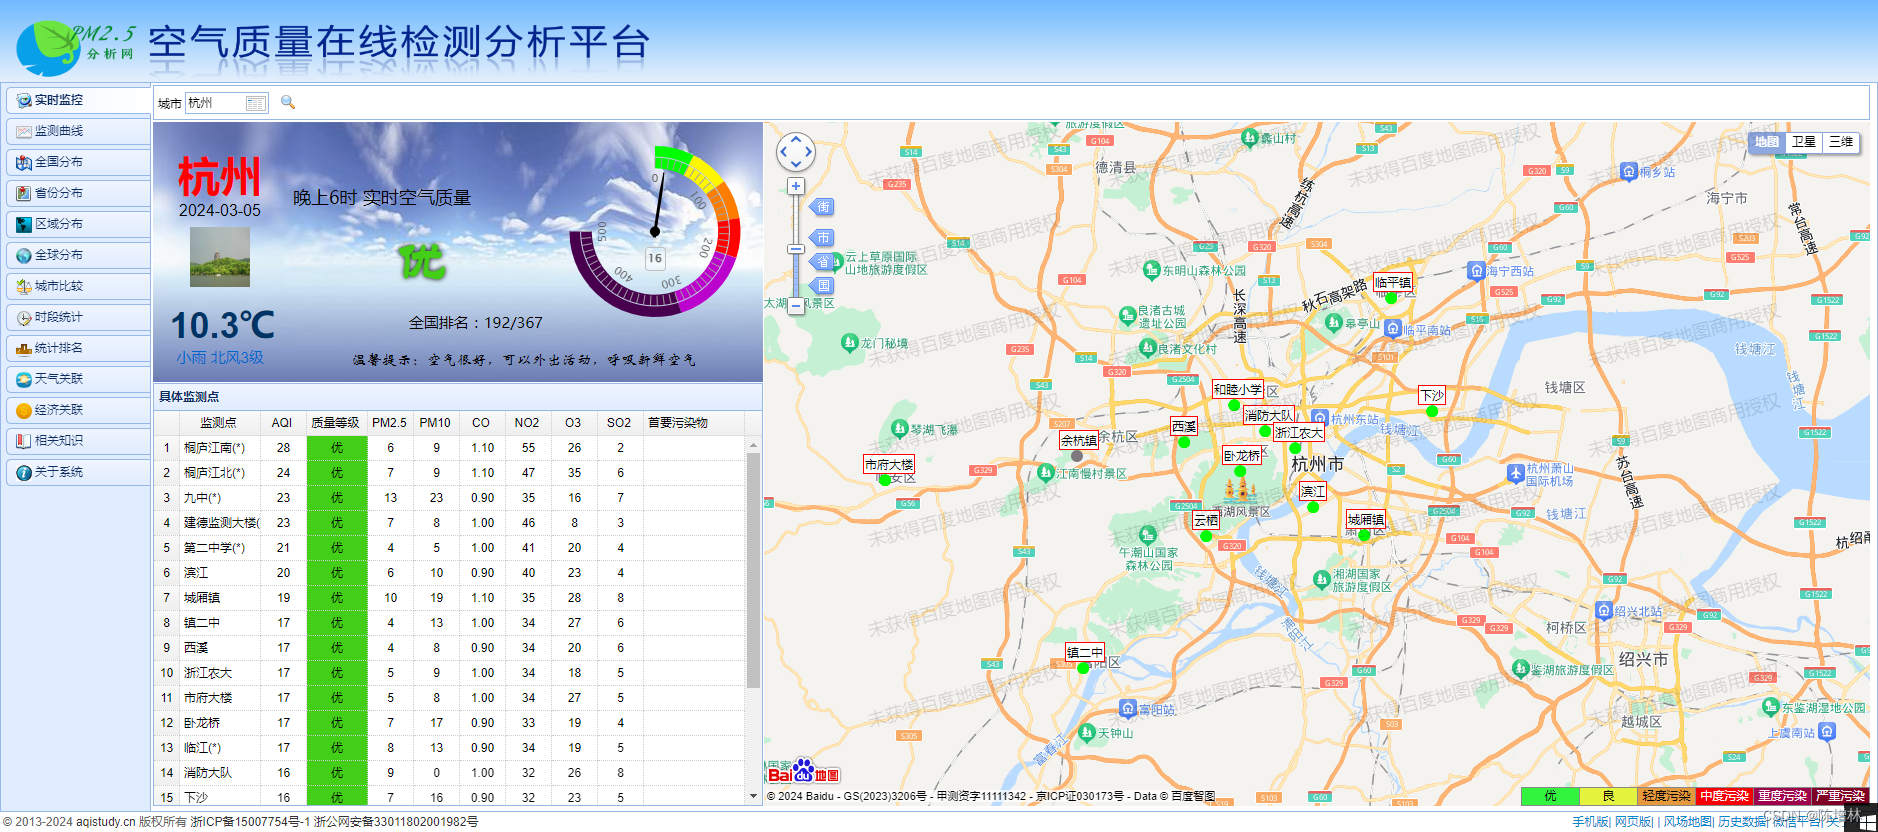
它首先从两个文本文件中读取城市信息和代理IP信息,然后提示用户输入爬取的起始年份、结束年份、起始月份和结束月份。接下来,它启动了Chrome浏览器的调试服务,并创建了一个Chrome驱动,用于自动化地访问指定的网页。之后,它定义了一个函数crawl_aqi_data(),用于爬取指定城市、指定年份和月份的空气质量数据,并将数据保存到本地文件。最后,它循环遍历所有城市和时间段,调用crawl_aqi
摘要:Qwen-Image LoRA模型在推理时失效的问题通常源于权重键名前缀与目标模型结构不匹配。通过对比发现,社区下载的LoRA模型与自行训练的模型键名前缀存在差异。使用提供的Python脚本可检查键名并转换前缀(如移除"diffusion_model."并将".weight"改为".default.weight"),转换后的模型可正
topid’:‘102636799’, //歌曲ID。先找到一首歌,把请求参数替换到下面程序中。爬取的数量不对,有些删除的评论也在。只提供思路,仅用于学习。#此处修改请求的页数。
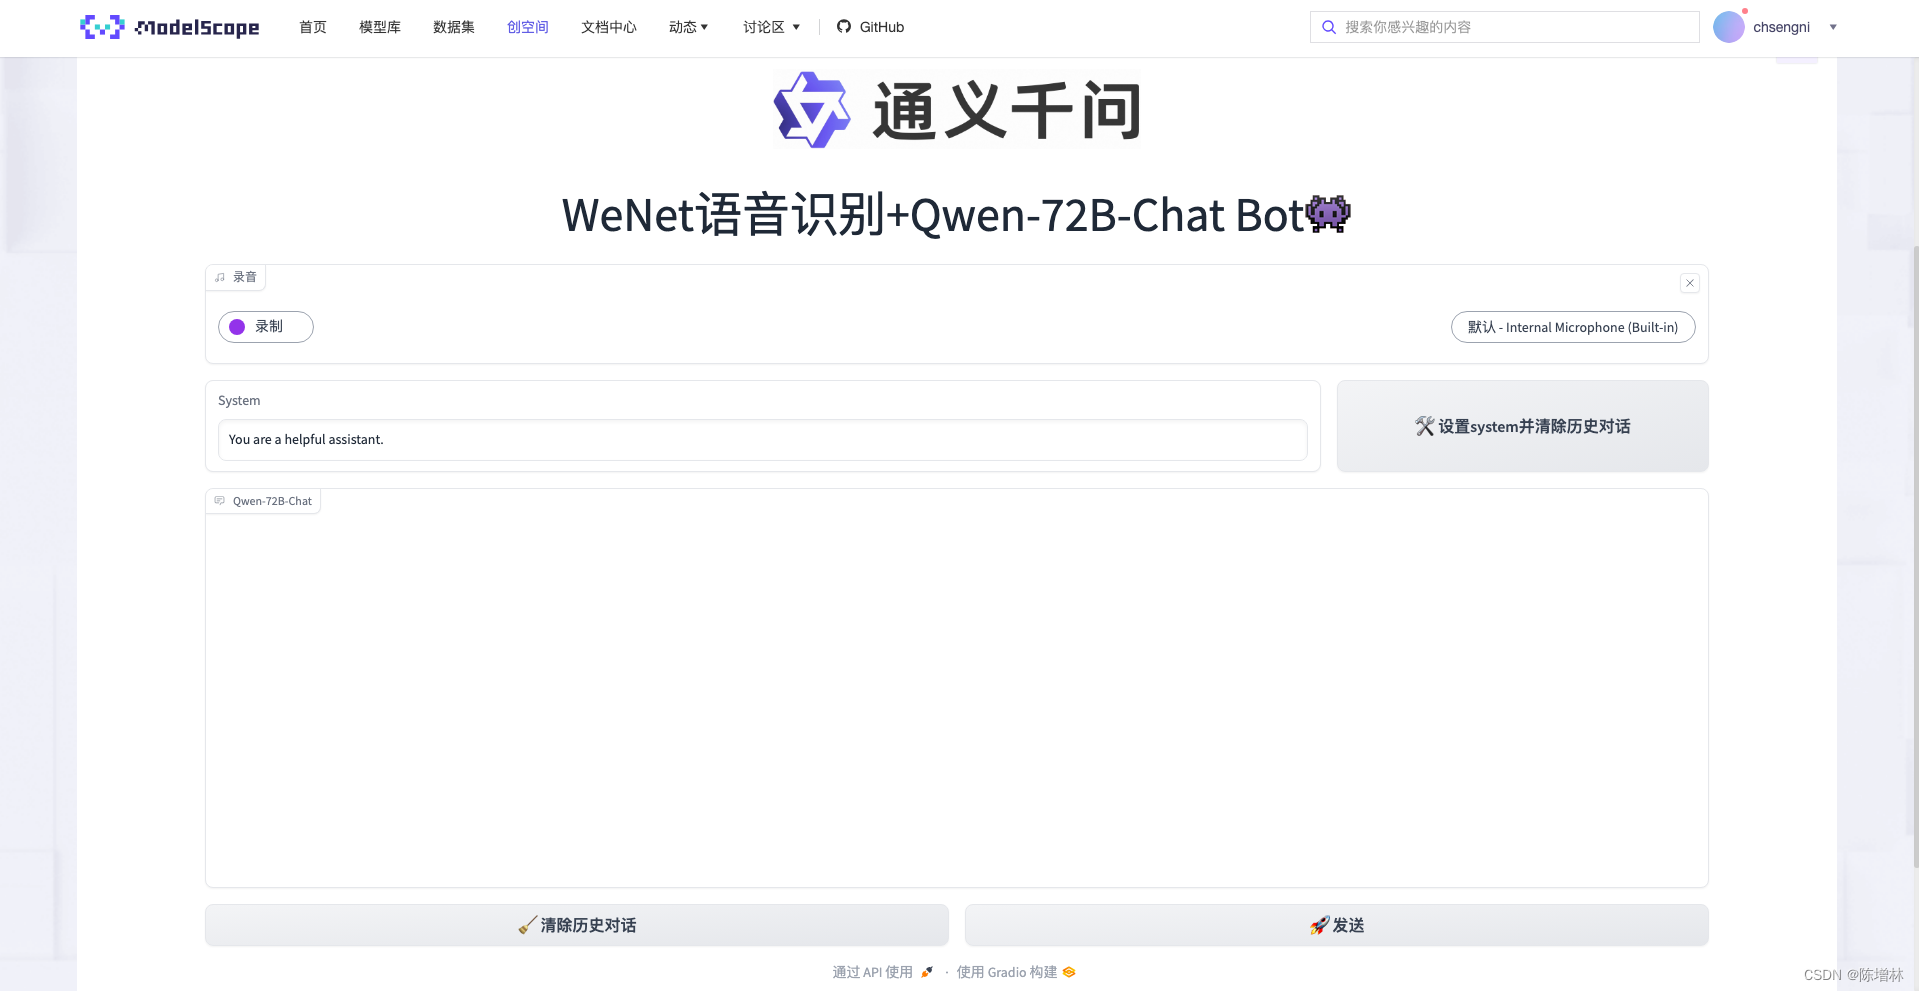
根据用户的文本输入与Chat Bot进行交互,发送用户输入的文本并接收Chat Bot的回复。通过载入中文模型(chs_model)并使用其功能,对录制的语音进行转录处理。WeNet语音识别对通义千问(Qwen-72B-Chat Bot)调用,首先通过WeNet将用户的语音输入转录为文本,然后将此文本输入通用问答模型以获取答案。整个代码的目的是提供一个基于Gradio的界面,使用户能够通过语音与Q
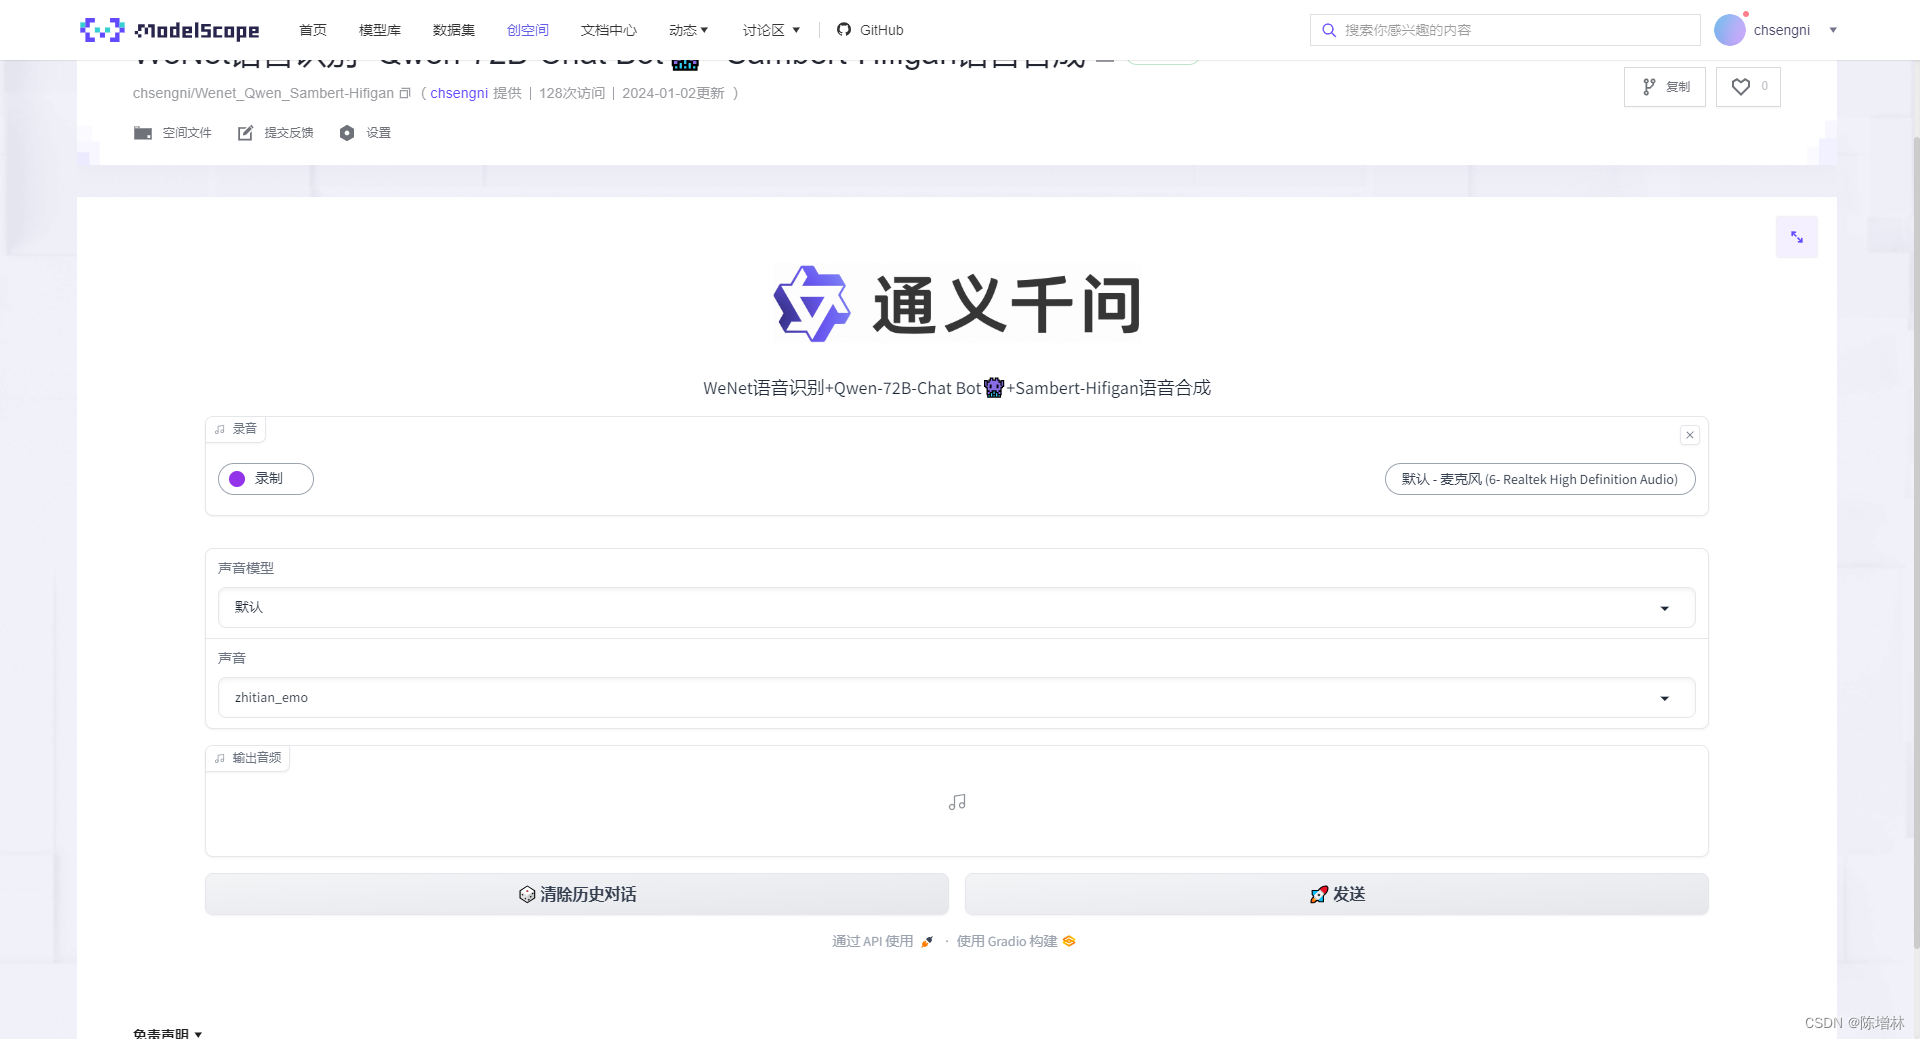
接着,Qwen-72B-Chat Bot作为聊天机器人接收用户的语音输入或文本输入,提供响应并与用户进行对话。最后,系统利用 Sambert-Hifigan 进行语音合成,将机器人的响应转换为自然流畅的语音输出,使用户能够以语音方式接收机器人的回复。多语音模型切换: 该系统支持多种语音模型的切换。用户可以根据需要选择不同的语音模型进行交互。对话记忆功能: 该系统能够记忆和追踪用户和聊天机器人之间的
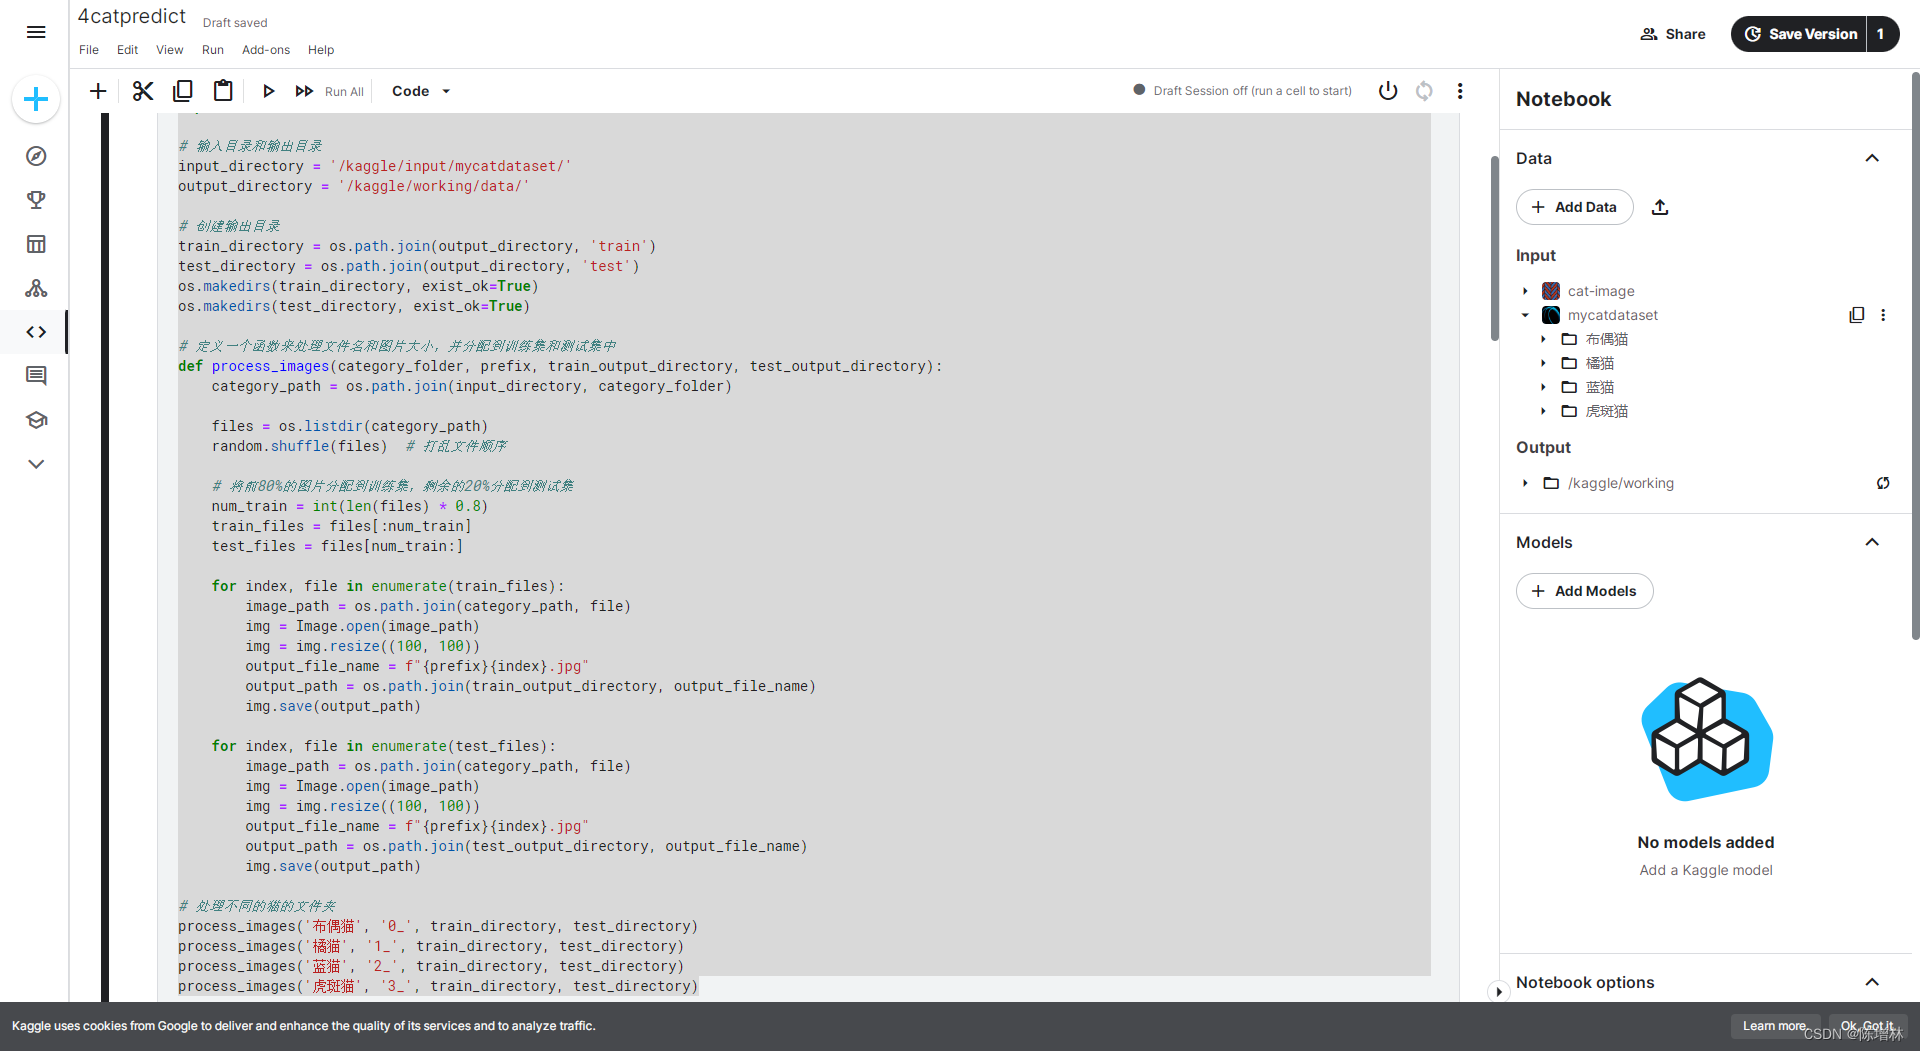
图像分类是计算机视觉中的一个关键任务,而猫种类识别作为一个有趣且实用的应用场景,通过卷积神经网络(CNN)的模型能够识别猫的不同品种。在这篇博客中,将详细介绍如何利用深度学习技术构建模型,从而实现猫种类的自动识别。将探讨数据集的获取和预处理、模型的构建与训练,以及模型的评估和应用。
PyQt5开发AIGC降重和检测软件,批量进行。
本文介绍了一个使用 PyQt5 和 Python-docx 库实现的文档处理工具,旨在帮助用户批量处理 .docx 文件中的段落和表格内容。该工具提供了直观的用户界面,允许用户选择输入文件和输出文件夹,并实时显示处理进度。PyQt5 用于构建用户界面,Python-docx 用于读写 .docx 文件,QThread 用于后台处理以避免阻塞主线程。工具的主要功能包括文件选择、文档处理和进度条显示。
本文介绍了一个基于PyQt5的多算法视频关键帧提取工具,该工具支持三种主流算法并通过图形界面提供便捷操作。关键帧提取技术能有效代表视频内容变化,适用于预览、分析和剪辑等场景。工具内置局部最大值算法(检测亮度差异)、帧差统计算法(自适应阈值)和直方图聚类算法(内容相似性分析),各有特点以适应不同需求。GUI设计支持多任务并行处理、算法灵活切换和友好交互体验,输出结果包含关键帧图片和元数据文件。该工具