


- @qq_33589510


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
template = """以下是一段AI机器人和人类的对话:根据输入和上面的对话记录写一份对话总结.输入: {input}"""llm=llm,

在资深开发的日常,经常能遇见和Page Cache相关场景:服务器的load飙高服务器的I/O吞吐飙高业务响应时延出现大的毛刺业务平均访问时延明显增加。这些问题,很可能是由于Page Cache管理不到位引起的,因为Page Cache管理不当除了会增加系统I/O吞吐外,还会引起业务性能抖动。这类问题出现后,开发人员往往束手无策,究其原因在于他们对Page Cache的理解仅仅停留在概念上,并不清
一、前言我记得以前上学的时候大家经常说的一个词汇叫做所见即所得,有些编程工具是所见即所得的,给程序员带来极大的方便。对于一个c程序员,我们的编写的代码能所见即所得吗?我们看到的c程序的逻辑是否就是最后CPU运行的结果呢?很遗憾,不是,我们的“所见”和最后的执行结果隔着:1、编译器2、CPU取指执行编译器将符合人类思考的逻辑(c代码)翻译成了符合CPU运算规则的汇编指令,编译器了解底层CPU的思维模
多年来,模型在聊天方面的表现早已超越人类,那么,自动化究竟在哪里?这是过去四年来一直驱动着我的问题。在 OpenAI 工作期间,我参与构建了相关方法,让语言模型能够有效地遵循指令并与人交流。这项工作最终成为 ChatGPT 背后的研究成果。当时,我认为聊天模型或许能够引领我们走向 AGI,但尽管外界对此大肆炒作,我还是逐渐意识到,其中显然缺少了某种非常重要的东西。

com.alibaba.nacos.consistency.entity包目录是由protobuf在编译时自动生成。可通过mvn compile来自动生成他们。如果使用的是IDEA,也可以使用IDEA的protobuf插件。执行 mvn compile。

jdk动态代理实例jdk动态代理模式里面有个拦截器的概念,在jdk中,只要实现了InvocationHandler接口的类就是一个拦截器类还使用了些反射的相关概念。拦截器的概念不了解没关系,假如写了个请求到action,经过拦截器,然后才会到action。然后继续有之后的操作。拦截器就像一个过滤网,一层层的过滤,只要满足一定条件,才能继续向后执行。拦截器的作用:控制目标对象的目标方法的执行。拦截器
API的方式来使用“工具”,使LM Studio模型能够查询维基百科。为“工具使用”选择的模型会极大影响性能。如果模型认为用户的消息最好通过调用工具来完成,那么在响应字段。字段来调用实际的函数或API,如Python示例代码中所示。Python聊天机器人示例,通过类似OpenAI调用。识别的所有参数都将生效,并且可用工具的数组应在。中将会提供一个工具调用请求对象的数组。然后把结果返回给我”
上图"Use Ollama models in your Claude Code" 就是这意思:拿本地模型去喂 Claude Code / Codex 这类 CLI)。所以"Ollama 要充值才能用 cloud 模型"不成立,Ollama 根本不管 cloud。但Ollama真正的价值不是替代 Codex,而是当 Codex/Claude Code 的后端。Qoder、TRAE、Kimi Cod
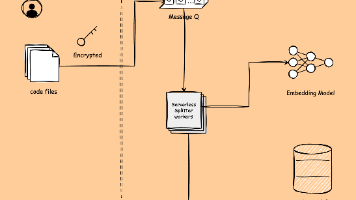
代码库感知索引系统:为 AI 编码工作流提供精准上下文
点击下方“JavaEdge”,选择“设为星标”第一时间关注技术干货!免责声明~任何文章不要过度深思!万事万物都经不起审视,因为世上没有同样的成长环境,也没有同样的认知水平,更「没有适用于所有人的解决方案」;不要急着评判文章列出的观点,只需代入其中,适度审视一番自己即可,能「跳脱出来从外人的角度看看现在的自己处在什么样的阶段」才不为俗人。怎么想、怎么做,全在乎自己「不断实践中寻找适合自己的大道」0