- @qq_25897071


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
不写代码、不碰终端,借助星图客户端与 GitHub,在对话框内用自然语言完成网页开发、版本提交与线上部署。GitHub CLI 的安装与授权由 AI 自动完成,Token 上传环节有安全指引。按工具准备、GitHub 配置、网页搭建、上线后调整四个阶段拆解操作步骤,附可复用指令模板与适用边界说明。
授权安全测试中真正耗时的是工具输出到可行动结论之间的判断环节。本文给出一种本地 AI 分析层方案:在内网用 vLLM 部署 Qwen3.8-27B FP8,通过「工具输出→AI 解读→生成下一步调用→工具层校验授权→执行」的 Agent 循环,把典型 C 段侦察任务从人工 3-4 小时压缩到约 15 分钟出第一版结构化结论。核心原则是数据不出内网、授权边界由代码强制、每次动作可审计。
AI 项目常见断点不是生成代码,而是部署、连接与分发。UCloud 开发者中心以发现、连接、构建为主线,提供 Spaces 沙箱、Repos、Skills、MCP 与 200+ 大模型,并用 AI 游乐场承接分发。适合已做出原型、缺少上线入口的开发者,具体收费、地域、合规与模型授权范围需以官方说明为准。
同时维护多个大模型账号和 API Key,是 AI 工作流里容易被低估的成本。优刻得 AstraFlow 通过一个 API Key 聚合 200+ 模型,支持 Auto Router 智能路由,官方测试显示整体调用成本下降约 50%。围绕多模型接入痛点、AstraFlow 配置步骤、适用边界和常见问题,直接给出可落地的接入方法。
GPU 云服务器选卡先看显存能不能装下模型,再看单位算力成本,最后看供货和合规。2026 年的实用选择可以直接收敛到几条主线:训练优先 H200/H100/B200,7B-13B 微调优先 RTX 4090,推理优先 L40S/H20,FLUX 图像生成优先 RTX 5090 或 48GB 显存卡,国内合规场景重点看 H20 和昇腾 910B/910C。
GPU 云服务器选卡先看显存能不能装下模型,再看单位算力成本,最后看供货和合规。2026 年的实用选择可以直接收敛到几条主线:训练优先 H200/H100/B200,7B-13B 微调优先 RTX 4090,推理优先 L40S/H20,FLUX 图像生成优先 RTX 5090 或 48GB 显存卡,国内合规场景重点看 H20 和昇腾 910B/910C。
本文基于一次 FlowTask 团队任务看板系统的端到端测评,说明如何使用 opencode 对 Claude Opus 4.8、ChatGPT 5.5、Deepseek V4 Pro、Qwen3.7 Max、Kimi K2.6、GLM 5.1 等模型进行工程化评估。重点覆盖测试任务设计、云端部署环境、评分口径、成本统计、问题验证方法,以及在 UCloud 云服务器环境下如何完成从开发到部署的完整

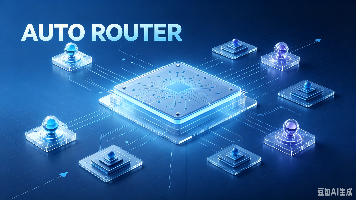
A: Auto Router是一种模型调度机制,根据任务内容、上下文长度、成本等动态选择最合适的模型,而不是在代码中写死某个模型。它把模型选择从业务逻辑中抽离,实现解耦和资源优化。
2026 年,大模型 API 平台选型的重点正在从“模型多不多、token 贵不贵”,转向“能不能稳定访问、合规采购、统一接入、自动路由和精细控成本”。企业生产环境优先看 UCloud 星图(AstraFlow),开发测试和免费额度优先看硅基流动,阿里云生态内应用适合阿里云百炼,文心与微调场景适合百度千帆,OpenRouter 更适合海外模型调研,不建议用于国内生产环境。
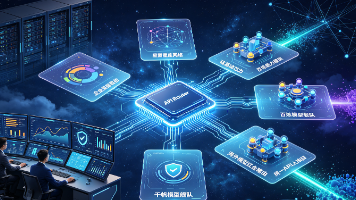
国内接入国外大模型 API,生产环境最稳妥的做法不是直连官方接口,也不是把第三方代理当主链路,而是国产模型做主力、国内合规平台转售的海外模型做兜底。直连官方 API 和第三方代理更适合调研、评测和预研,不适合长期承载国内生产链路。