- @python12345678_


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
随着人工智能技术的不断发展,大模型已经成为了人工智能领域的重要组成部分。然而,随着模型规模的扩大,安全问题也成为了我们需要关注的重要方面之一。在本文中,我们将探讨大模型的安全问题,并提供一些解决方案。大模型的安全问题主要包括以下几个方面:数据安全:大模型需要大量的训练数据,这些数据可能包含敏感信息。如果这些数据被泄露,可能会导致严重后果。模型安全:大模型可能会被攻击者利用,进行恶意操作,如生成恶意
Ollama 是一个开源框架,专为在本地机器上便捷部署和运行大型语言模型(LLM)而设计。,这是 Ollama 的官网地址:https://ollama.com/
本文旨在让无大模型开发背景的工程师或者技术爱好者无痛理解大语言模型应用开发的理论和主流工具,因此会先从与LLM应用开发相关的基础概念谈起,并不刻意追求极致的严谨和完备,而是从直觉和本质入手,结合笔者调研整理及消化理解,帮助大家能够更容易的理解LLM技术全貌,大家可以基于本文衍生展开,结合自己感兴趣的领域深入研究。若有不准确或者错误的地方也希望大家能够留言指正。第一部分 基础概念1.机器学习场景类别

听说你是搞C语言的?天天对着寄存器写代码,对着示波器调Bug?STM32、FreeRTOS、Linux内核驱动,这些你闭着眼睛都能写?摸过GPIO,调过I2C,搞过DMA,踩过各种底层深坑?那我来问你一句话:你拿这个手艺,年薪过了40万没有?没到的话,别急着自我怀疑。是你的能力被低估了,不是你不努力。C语言程序员转AI大模型开发,这条路比你想象的靠谱得多。而且竞争者少,因为大多数AI选手根本搞不定
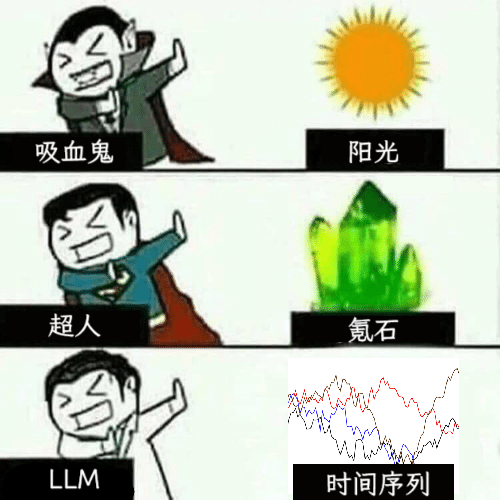
语言模型真的能用于时序预测吗?根据贝特里奇头条定律(任何以问号结尾的新闻标题,都能够用「不」来回答),答案应该是否定的。事实似乎也果然如此:强大如斯的 LLM 并不能很好地处理时序数据。时序,即时间序列,顾名思义,是指一组按照时间发生先后顺序进行排列的数据点序列。在很多领域,时序分析都很关键,包括疾病传播预测、零售分析、医疗和金融。在时序分析领域,近期不少研究者都在研究如何使用大型语言模型(LLM
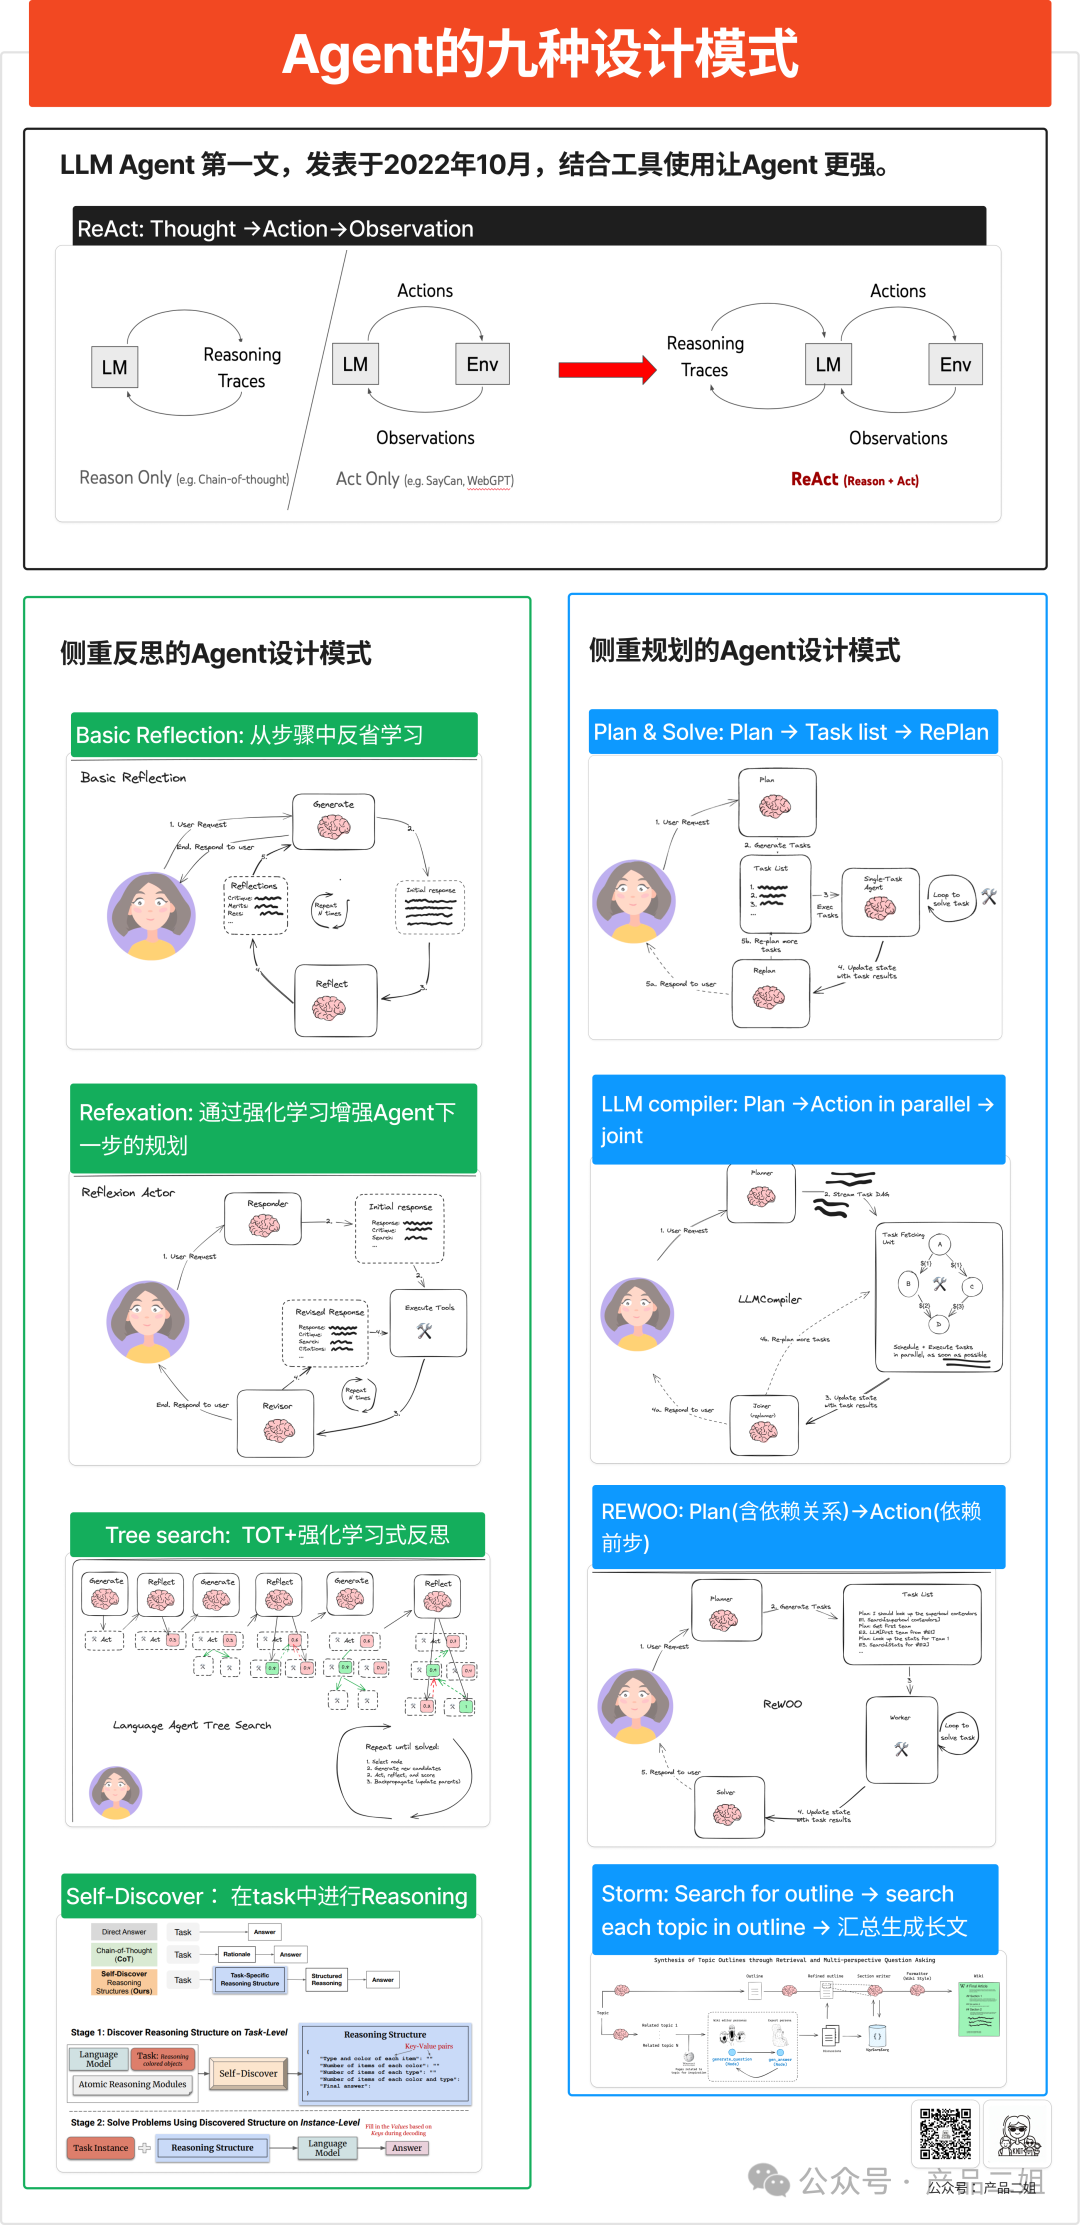
上周五我在一个特工宇宙的社群里做了一次分享,题目是《从 YC 项目看 AI 趋势以及 AI agent 开发工具类产品该如何设计》,收到了大家不错的反馈,不过回看视频后还是发现不少可以提升的地方,感兴趣的朋友公众号回复“分享”获取会议录屏链接,这篇文章和大家详细讲讲分享中提到的:相关的资料(包括论文链接,原作者博客,langchain 代码实现等)已经整理在成表格(关注公众号发送“Agent”即可
关键词1关键词2。
语言模型真的能用于时序预测吗?根据贝特里奇头条定律(任何以问号结尾的新闻标题,都能够用「不」来回答),答案应该是否定的。事实似乎也果然如此:强大如斯的 LLM 并不能很好地处理时序数据。时序,即时间序列,顾名思义,是指一组按照时间发生先后顺序进行排列的数据点序列。在很多领域,时序分析都很关键,包括疾病传播预测、零售分析、医疗和金融。在时序分析领域,近期不少研究者都在研究如何使用大型语言模型(LLM
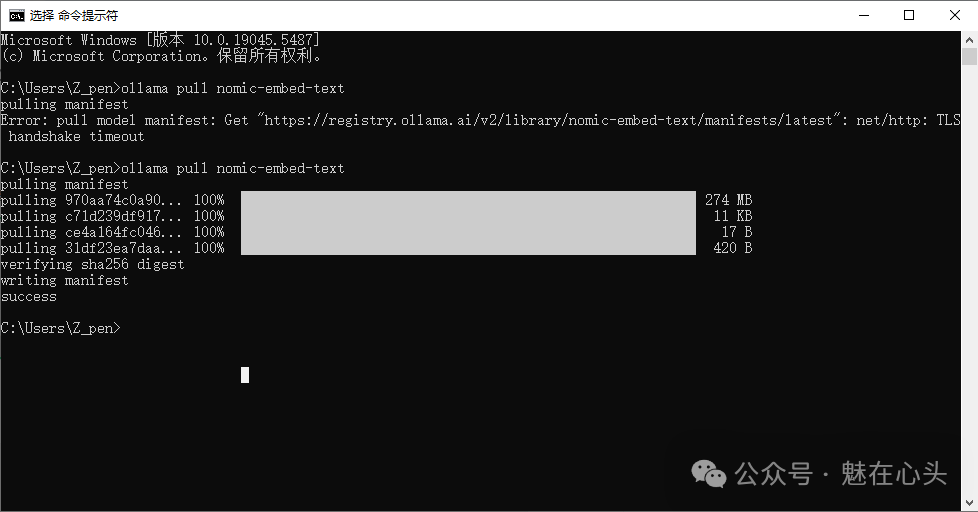
在完成deepseek-r1模型的本地部署后,如何搭建自己的个人知识库,训练(投喂数据)出专属自己的AI工具呢?比如多模态学习:PDF、音频、视频;使AI更加准确的理解我们的意图,更快速完整的给出精准答案,为提供我们更懂、更人性化的服务。follow me,跟着本文下述教程步骤操作就能搞定!此操作使用ollama就可以完成,首先,运行运行我们需要指定好具体的模型名称和大小,即上篇文章安装的本地de
数据集的格式要求在不同的阶段是不同的,本教程以sft阶段的数据集需求,将以系统自带的identity数据集和将自定义的一个商品文案生成数据集为例,介绍数据集的使用。更多详情可以在https://github.com/hiyouga/LLaMA-Factory/blob/main/data/README_zh.md 中找到相关解释。系统目前支持 alpaca 和sharegpt两种数据格式,以alp