


- @maizeman126


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
(对于b+c<25,应该进行二项式计算,事实上,大多数软件包只是简单的在所有情况下都执行二项式计算,因为所有情况下的结果都是精确的。该方法包括评估与所有可能的2×2表相关联的概率,这些表与所观察到的数据具有相同的行和列总数,使得零假设(即行和列变量是无关的)是真的。如果计算出的概率p低于选定的显著水平,则零假设被拒绝,可以得出结论,至少2个变量中的比例是显著不同的。如果数据可以被组织在一组类别中,

1908年,在都柏林的吉尼斯啤酒厂工作的W. S. Gosset被小样本的问题所在吸引,比如说大麦的化学性质,其样本量经常低至3左右。从下一批次的药品开始,n=13的随机样本的重量为3.04g、2.94g、3.01g、3.00g、2.94g、2.91g、3.02g、3.04g、3.09g、2.95g、2.99g、3.10g、3.02g。而其上限值是小于分布的97.5%的值。95%置信区间(CI)的
泊松回归的联系函数为对数函数,对数的一个性质就是把加法变成乘法。在正态线性模型中,回归系数的含义是:x每增加一个单位,y增加系数个单位。而在泊松回归中,x每增加一个单位,y变为原来的多少倍。概率分布为泊松分布、联系函数为对数函数的广义线性模型叫作泊松回归。seaborn中的函数无法直接绘制出泊松回归的曲线,因而这里把所估计的模型的预测值绘制成散点图。分析不同气温与啤酒销量的关系。两个模型相比,包含

(1)x=None,y=None,用于数据显示的轴向。

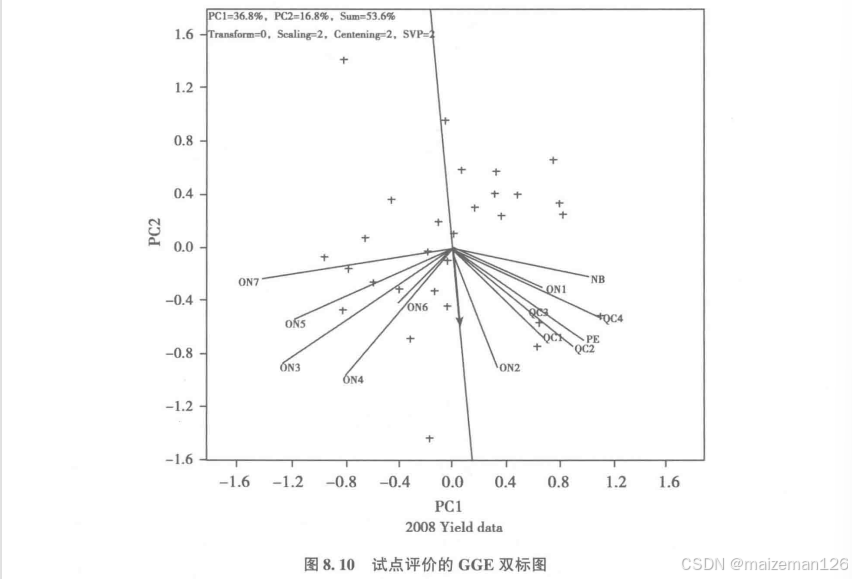
再次,即使是合适的试点在品种试验中也可能存在冗余的问题,多余的试点增加试验成本,却不能增加关于基因型的信息。在基于SD定标和h加权数据的GGE双标图中,试点向量的长度近似于试点的遗传力平方根。因此,GGE双标图中的试点向量长度可以表示试点的h或其与其他试点相关性的强度。品种生态区内的试点都是正相关,如图试点间的锐角所示,可见试点对其所在品种生态区的代表性很好。基于SD定标和h加权数据的GGE双标图
使用range函数时,用逗号把起始值、结束值和步长隔开,而在切片语法中使用冒号来分隔。range函数可用于创建生成器并转换成一个值列表,但切片的冒号语法仅做切片和取子值时才有意义,它本身没有内在意义。pandas的DataFrame对象和其他语言(比如R)中的DataFrame对象相似,每列的类型必须相同,而每行可以包含混合类型。在当前的示例中,iloc和loc的行为完全相同,因为索引标签就是行号

本例中籽粒产量的GGE双标图仅解释了G和GE总变异的53.6%,说明籽粒产量的GE/G比率更大,GE的构成也更为复杂。下图就是“谁赢在哪里双标图”,与前一个功能图相比,仅仅是去掉了试点向量,而增加了多边形和从原点到多边形各边的垂线。下面这张图标有8.5的双标图与上面那个标有8.4的双标图是相同,只是图8.5采用了基因型聚焦的奇异值分析方法。GGE双标图“谁赢在哪里”功能图确实解释了示例中可能包括一

本例中籽粒产量的GGE双标图仅解释了G和GE总变异的53.6%,说明籽粒产量的GE/G比率更大,GE的构成也更为复杂。下图就是“谁赢在哪里双标图”,与前一个功能图相比,仅仅是去掉了试点向量,而增加了多边形和从原点到多边形各边的垂线。下面这张图标有8.5的双标图与上面那个标有8.4的双标图是相同,只是图8.5采用了基因型聚焦的奇异值分析方法。GGE双标图“谁赢在哪里”功能图确实解释了示例中可能包括一
对于分类变量的解释必须和参考变量(即从分析中删除的虚拟变量)联系起来。在尝试解释sklearn模型时,一个棘手的问题就是模型的系数不带标签,原因是numpy ndarray无法存储这类元数据。线性回归的目标是描述响应变量(或“因变量”)和预测变量(也称“特征”、“协变量”、“自变量”)之间的直线关系。对分类变量建模时,必须创建虚拟变量,即分类中的每个唯一值都变成了新的二元特征。在sklearn中,
使用range函数时,用逗号把起始值、结束值和步长隔开,而在切片语法中使用冒号来分隔。range函数可用于创建生成器并转换成一个值列表,但切片的冒号语法仅做切片和取子值时才有意义,它本身没有内在意义。pandas的DataFrame对象和其他语言(比如R)中的DataFrame对象相似,每列的类型必须相同,而每行可以包含混合类型。在当前的示例中,iloc和loc的行为完全相同,因为索引标签就是行号